무료 오픈소스 AirLLM: 4GB GPU·70B 주장의 원리와 자원 계산
AirLLM의 레이어 이동 구조와 70B 가중치의 저장공간·전송시간을 가정별로 계산합니다. 제작사 실행 주장과 직접 계산한 값을 구분한 도입 검토 가이드입니다.
- #AirLLM 사용법
- #무료 오픈소스
- #free open source LLM
- #4GB GPU
- #70B 모델
무료 오픈소스 AirLLM, 4GB GPU로 70B가 정말 돌아갈까?
제작사는 가능하다고 설명합니다. 다만 이 글에서 4GB GPU로 70B 모델을 직접 실행한 것은 아닙니다. 레이어 이동 구조와 저장공간·시간 조건을 계산해 도입 여부를 판단하는 글입니다.
AirLLM은 무료(free)로 사용할 수 있는 Apache-2.0 오픈소스(open source) 로컬 LLM 추론 도구입니다. GPU 메모리를 조금 아끼는 대신, 필요한 순간에만 아주 일부를 쓰는 방식으로 문제를 바꿉니다. 모델 전체가 아니라 계산할 레이어 하나만 GPU에 올렸다가 바로 내리거든요. 그래서 GPU에 상주하는 가중치 양을 줄입니다. 실제 필요한 VRAM에는 현재 레이어 외에 활성값·캐시·실행 버퍼도 포함됩니다.
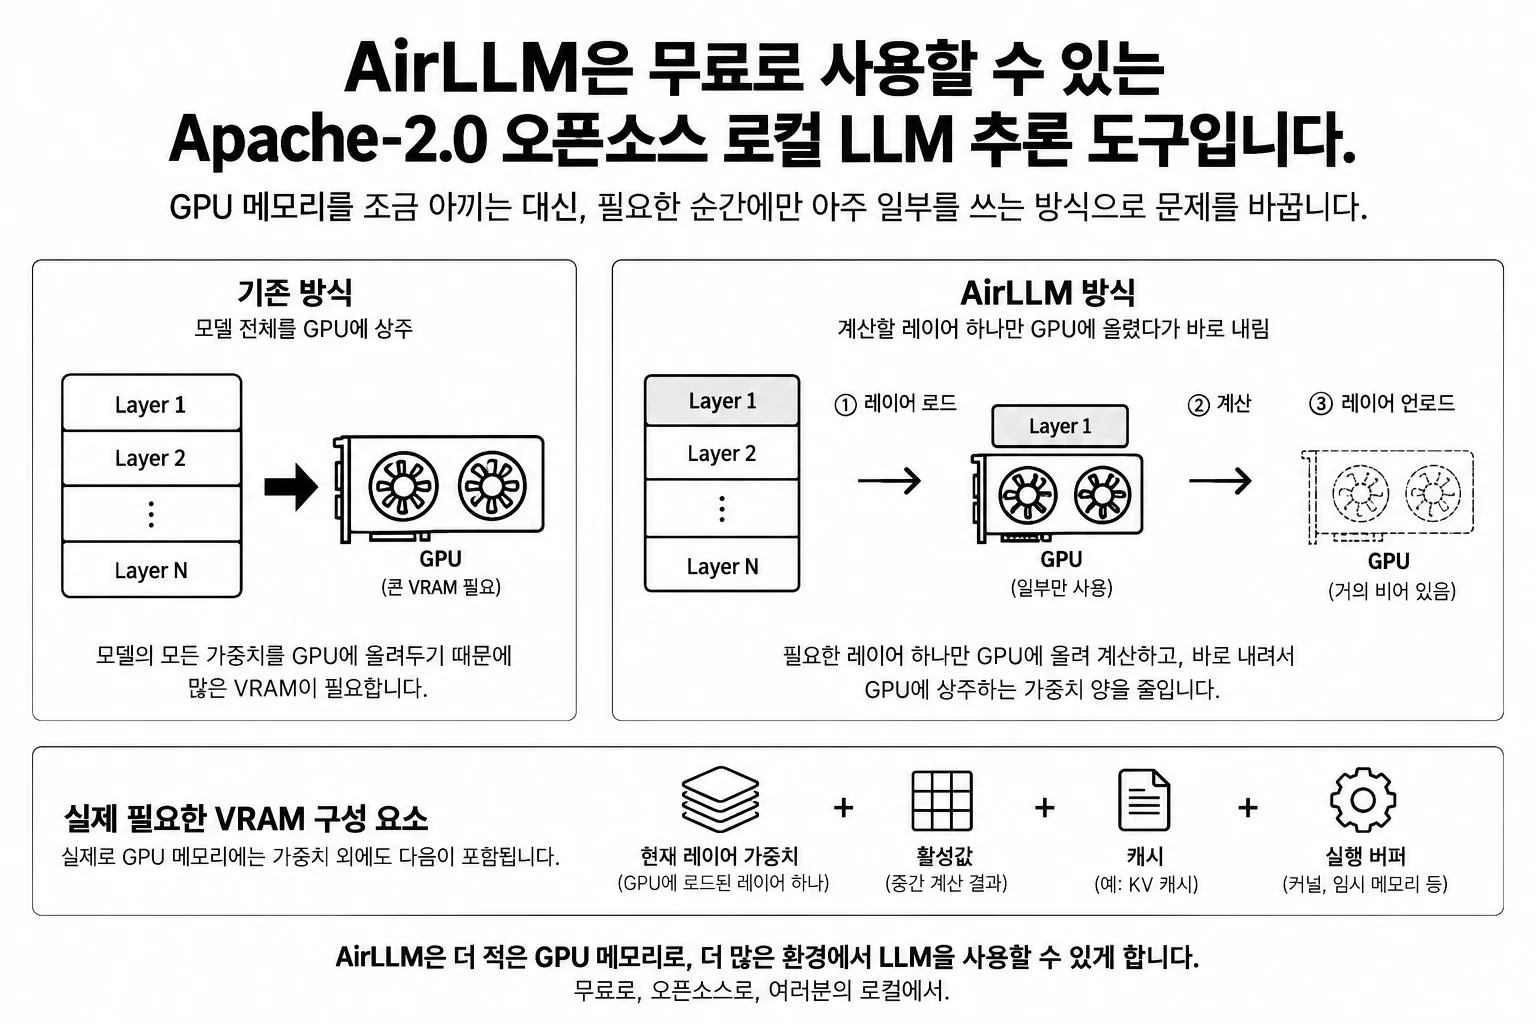
제작사는 70B 모델의 4GB 카드 실행과 671B 모델의 12GB 카드 실행을 안내합니다. 이는 이 글의 실측 결과가 아닙니다. 대신 꼭 알아둘 게 있어요. 메모리를 얻는 만큼 속도는 꽤 많이 내줍니다.
4GB GPU에서 70B 모델을 실행하는 원리
보통 큰 모델을 작은 카드에서 돌리려면 모델을 줄입니다. 양자화(가중치를 4bit 같은 낮은 정밀도로 바꾸기), 증류(작은 모델에 옮겨 담기), 프루닝(안 쓰는 연결 잘라내기) 셋 다 원본을 손대는 방법입니다. 정확도가 조금씩 깎입니다.
AirLLM은 원본을 그대로 둡니다. 대신 실행 순서를 바꿉니다.
- 모델을 레이어 단위로 쪼개 디스크에 저장한다
- 계산할 차례가 된 레이어만 GPU에 올린다
- 계산이 끝나면 내리고 다음 레이어를 올린다
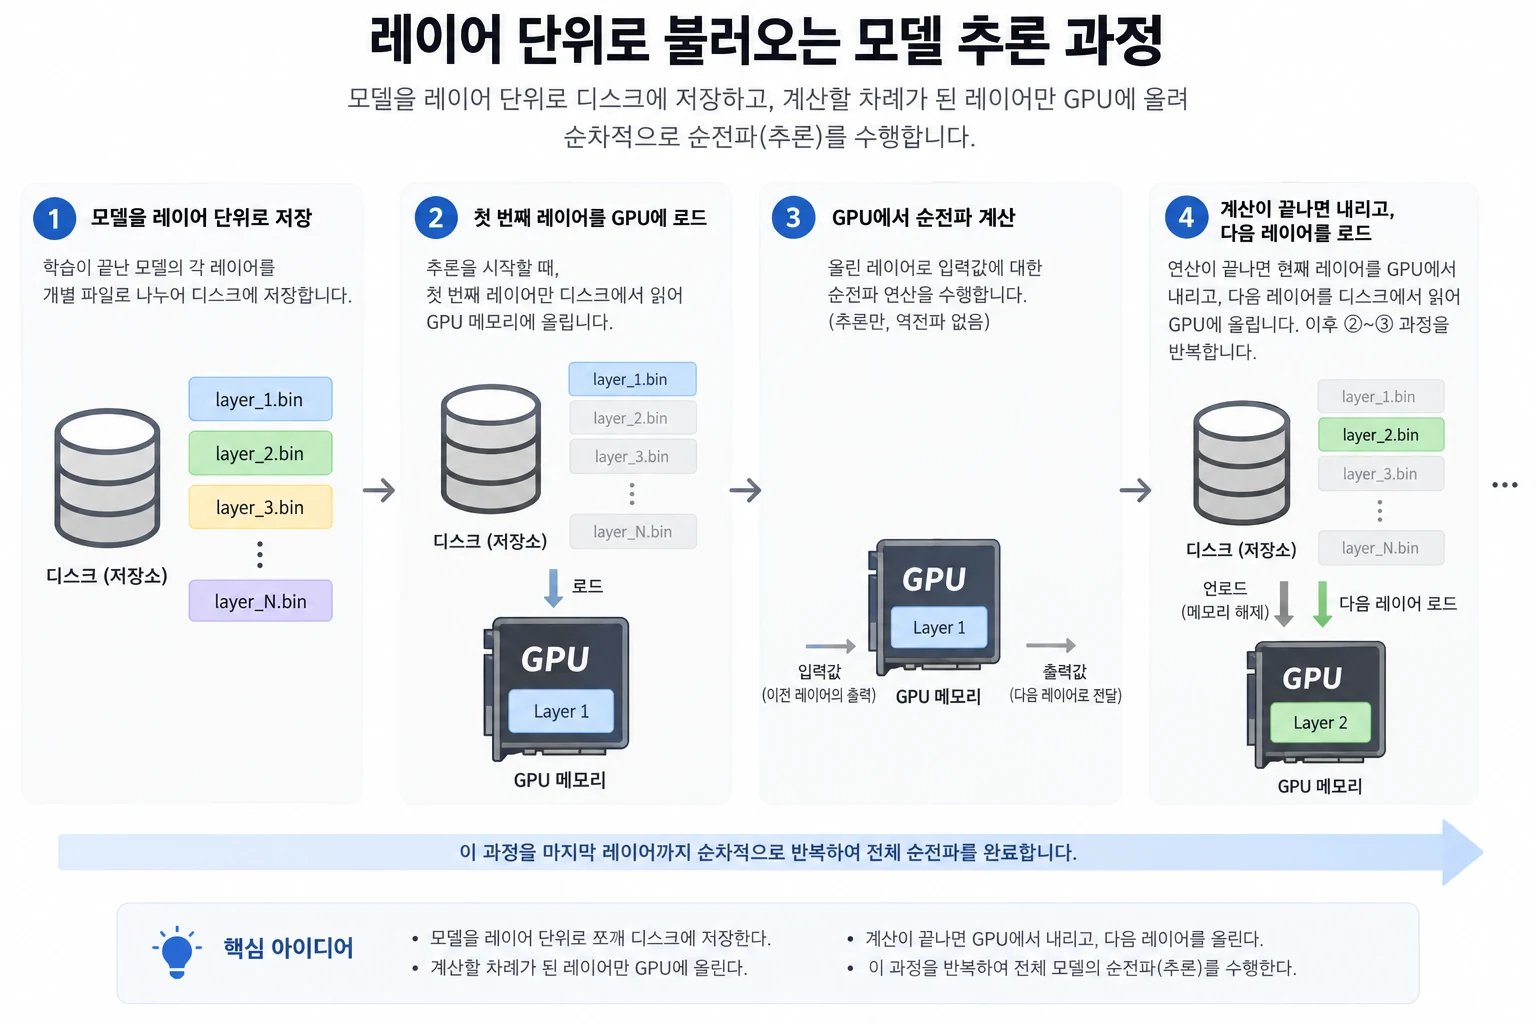
트랜스포머는 레이어를 순서대로 통과하는 구조라, 사실 한 시점에 필요한 건 레이어 하나뿐입니다. AirLLM은 그 사실을 그대로 이용합니다.
MoE(전문가 혼합) 모델에서는 한 걸음 더 갑니다. 토큰이 실제로 지나가는 전문가만 골라 올리기 때문에, 파라미터 총량이 커도 실제로 GPU에 올라가는 양은 훨씬 작습니다. 2.8조 파라미터짜리 Kimi K3가 RTX 6000 Ada 한 장에서 3.72GB로 측정된 것도 이 방식 덕분입니다.
모델별 필요 VRAM
저장소가 공개한 수치입니다.
| 모델 | 파라미터 | 필요 VRAM |
|---|---|---|
| Qwen3 / Mistral / Phi | 약 8B | 약 1~2GB |
| Qwen3-30B / Mixtral (MoE) | 30~47B | 약 1~3GB |
| Qwen3-235B (MoE) | 235B | 약 3GB |
| Llama 3.x 70B (원본 정밀도) | 70B | 약 4GB |
| Llama 3.1 405B | 405B | 약 8GB |
| DeepSeek-V3 | 671B | 약 12GB |
파라미터가 20배 늘어도 VRAM은 3배밖에 안 늘어납니다. 총 크기가 아니라 레이어 크기가 기준이라는 걸 보여주는 표입니다.
코드는 모델 종류와 상관없이 같습니다.
from airllm import AutoModel

model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
# 같은 한 줄로 더 큰 모델도 그대로
# model = AutoModel.from_pretrained("deepseek-ai/DeepSeek-V3")
로컬 LLM을 작은 GPU에서 돌릴 수 있다는 의미
“큰 모델을 돌려보려면 GPU부터 빌려야 한다”는 전제가 깨집니다. 지금까지 70B급 이상을 만져보려면 클라우드 GPU를 시간 단위로 빌리거나, API를 호출하거나, 양자화된 축소판으로 타협해야 했습니다. 셋 다 돈이 들거나 원본이 아니었습니다.
외부 전송을 제한하는 작업에서는 모델 다운로드 이후의 실행 구성과 부가 기능까지 확인해야 합니다. GL4SS의 데이터 전송 경계처럼 별도 앱 서버가 없어도 외부 모델 API에 입력을 보내는 구조가 있습니다. “로컬”이나 “서버 없음”이라는 이름만으로 데이터가 기기 밖으로 나가지 않는다고 판단해서는 안 됩니다.
다른 로컬 LLM 실행 방법과 비교
같은 문제(“VRAM이 모자란다”)를 푸는 다른 방법들과 성격이 다릅니다.
| 방법 | 원본 유지 | 속도 경향 | 소프트웨어·API 요금 | 데이터 외부 전송 |
|---|---|---|---|---|
| AirLLM (레이어 스트리밍) | 기본 모드의 원본 가중치 유지 | 디스크 이동이 병목일 수 있음 | 도구 무료, 모델 조건 별도 | 로컬 구성과 부가 기능 확인 |
| 양자화 (GGUF·llama.cpp 등) | 가중치 정밀도 변경 | 모델·장비에 따라 다름 | 도구 무료, 모델 조건 별도 | 로컬 구성과 부가 기능 확인 |
| 클라우드 GPU 대여 | 유지 | 빠름 | 시간당 과금 | 사용하는 클라우드까지 |
| 상용 API | 해당 없음 | 빠름 | 토큰당 과금 | 있음 |
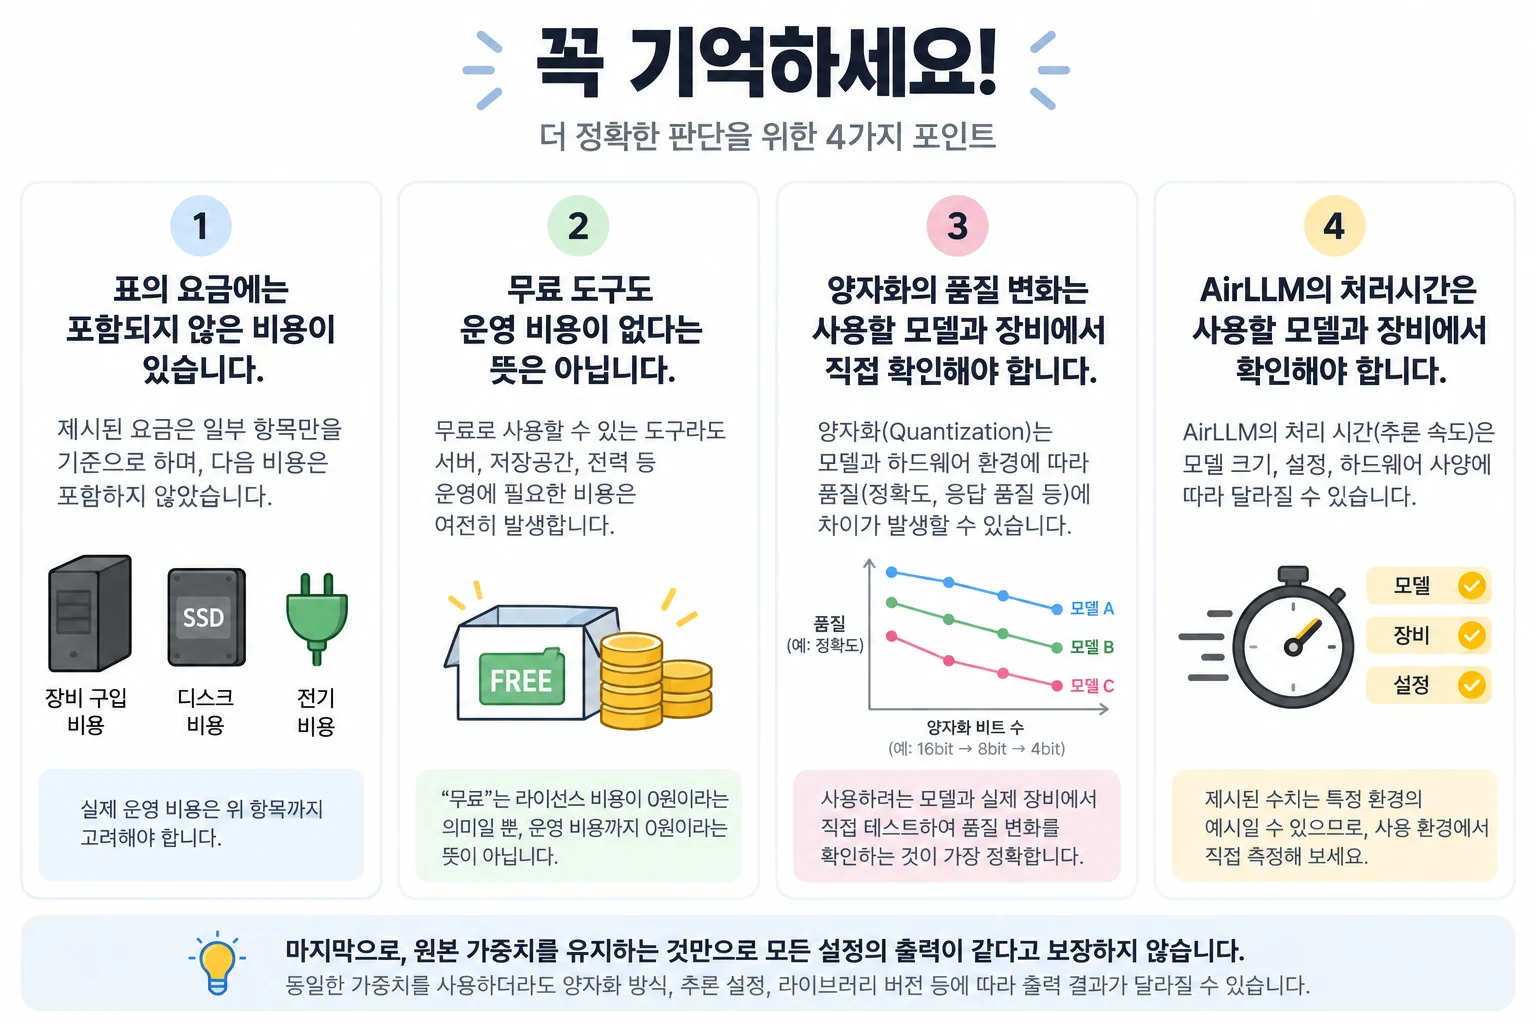
표의 요금에는 장비 구입·디스크·전기 비용을 넣지 않았습니다. 무료 도구도 운영 비용이 없다는 뜻은 아닙니다. 양자화의 품질 변화와 AirLLM의 처리시간은 사용할 모델·장비에서 각각 확인해야 합니다. 원본 가중치를 유지하는 것만으로 모든 설정의 출력이 같다고 보장하지 않습니다.
AirLLM을 추천하는 작업과 추천하지 않는 작업
이런 작업에는 잘 맞습니다
- 사내 GPU 구매를 결정하기 전에, 그 모델이 우리 데이터에서 쓸 만한지 먼저 확인해보는 일
- 표본 처리시간을 측정한 뒤 마감 시간 안에 끝낼 수 있다고 판단한 일괄 작업
- 양자화된 모델과 원본 모델의 출력 차이를 실제로 비교해봐야 하는 검증 작업
- 데이터를 외부로 보낼 수 없어서 애초에 API가 선택지가 아닌 경우
이런 작업에는 권하지 않습니다
- 사람이 앞에서 기다리는 모든 것 — 챗봇, 코드 어시스턴트, 서비스 API
- 처리량이 필요한 대량 실시간 작업
- 디스크 여유가 없는 노트북
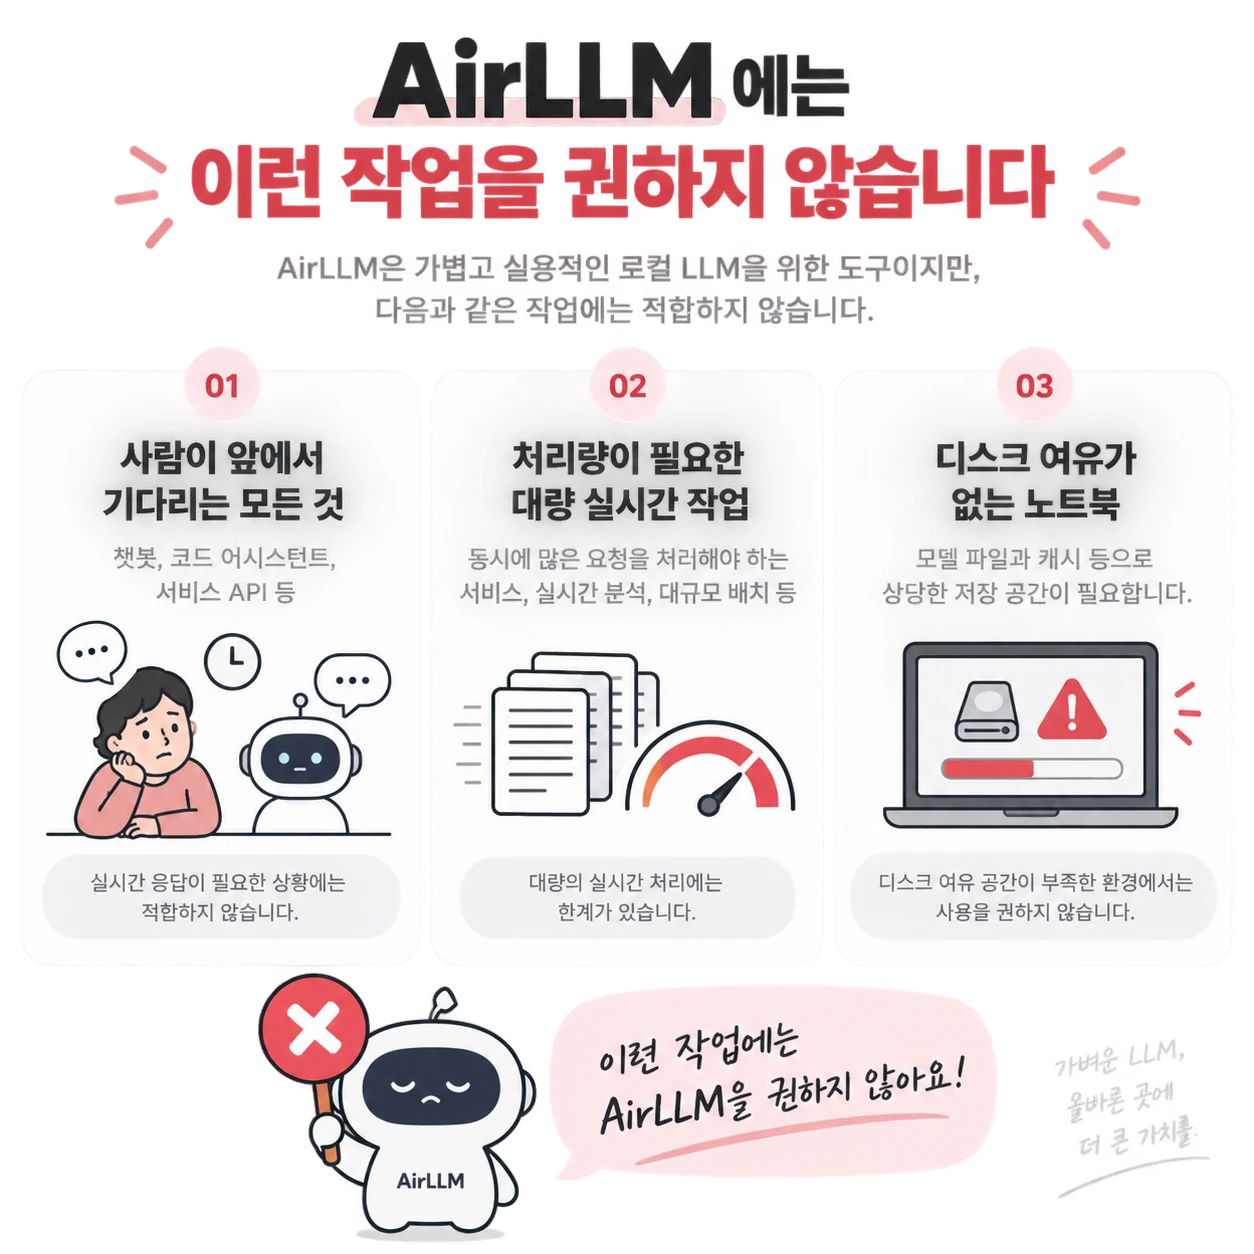
저장소는 초당 토큰 수를 공개하지 않습니다. 다만 구조상 토큰 하나를 만들 때마다 모델 전체 레이어가 디스크에서 GPU로 한 바퀴 지나갑니다. 병목이 계산이 아니라 디스크 읽기라는 뜻이고, 그래서 저자도 속도 개선책으로 “가중치만 압축해 읽을 양을 줄이는” 방법을 내놓았습니다. 실시간 용도로 보면 안 되는 이유가 여기 있습니다.
AirLLM 사용 전 확인할 GPU·저장공간 조건
| 항목 | 내용 |
|---|---|
| 디스크 | 레이어별로 쪼개 다시 저장. 원본과 변환본을 함께 들고 있게 되므로 여유 필요 |
| 디스크 부족 시 증상 | MetadataIncompleteBuffer safetensors 오류. 모델 문제로 착각하기 쉬움 |
| 절약 옵션 | 초기화 시 delete_original=True — 원본을 지워 절반 절약 |
| 속도 옵션 | compression='4bit' 또는 '8bit' — 최대 3배 빨라짐. bitsandbytes 설치 필요. 이때는 가중치를 줄이는 것이라 손실 발생 |
| macOS | Apple Silicon만 지원. mlx와 torch 필요 |
| Kimi K3 전용 조건 | compressed-tensors·flash-attn 필수, CUDA 12 빌드 torch(13용 휠 없음), transformers 4.56.x — 5.x에서는 로드 실패 |
마지막 줄이 실제로 제일 많이 걸립니다. 최신 모델을 최신 라이브러리로 돌리려다 실패하는 조합이라, 환경을 따로 만들어두는 편이 낫습니다.
처음 돌릴 때는 작은 검증셋부터 시작하세요
처음부터 긴 문서 수천 건을 넣으면 느린 이유가 모델인지, 디스크인지, 입력 길이인지 구분하기 어렵습니다. 먼저 실제 업무에서 자주 나오는 입력 10~20개를 골라 원본 모델의 출력 품질과 한 건당 처리 시간을 기록하세요.
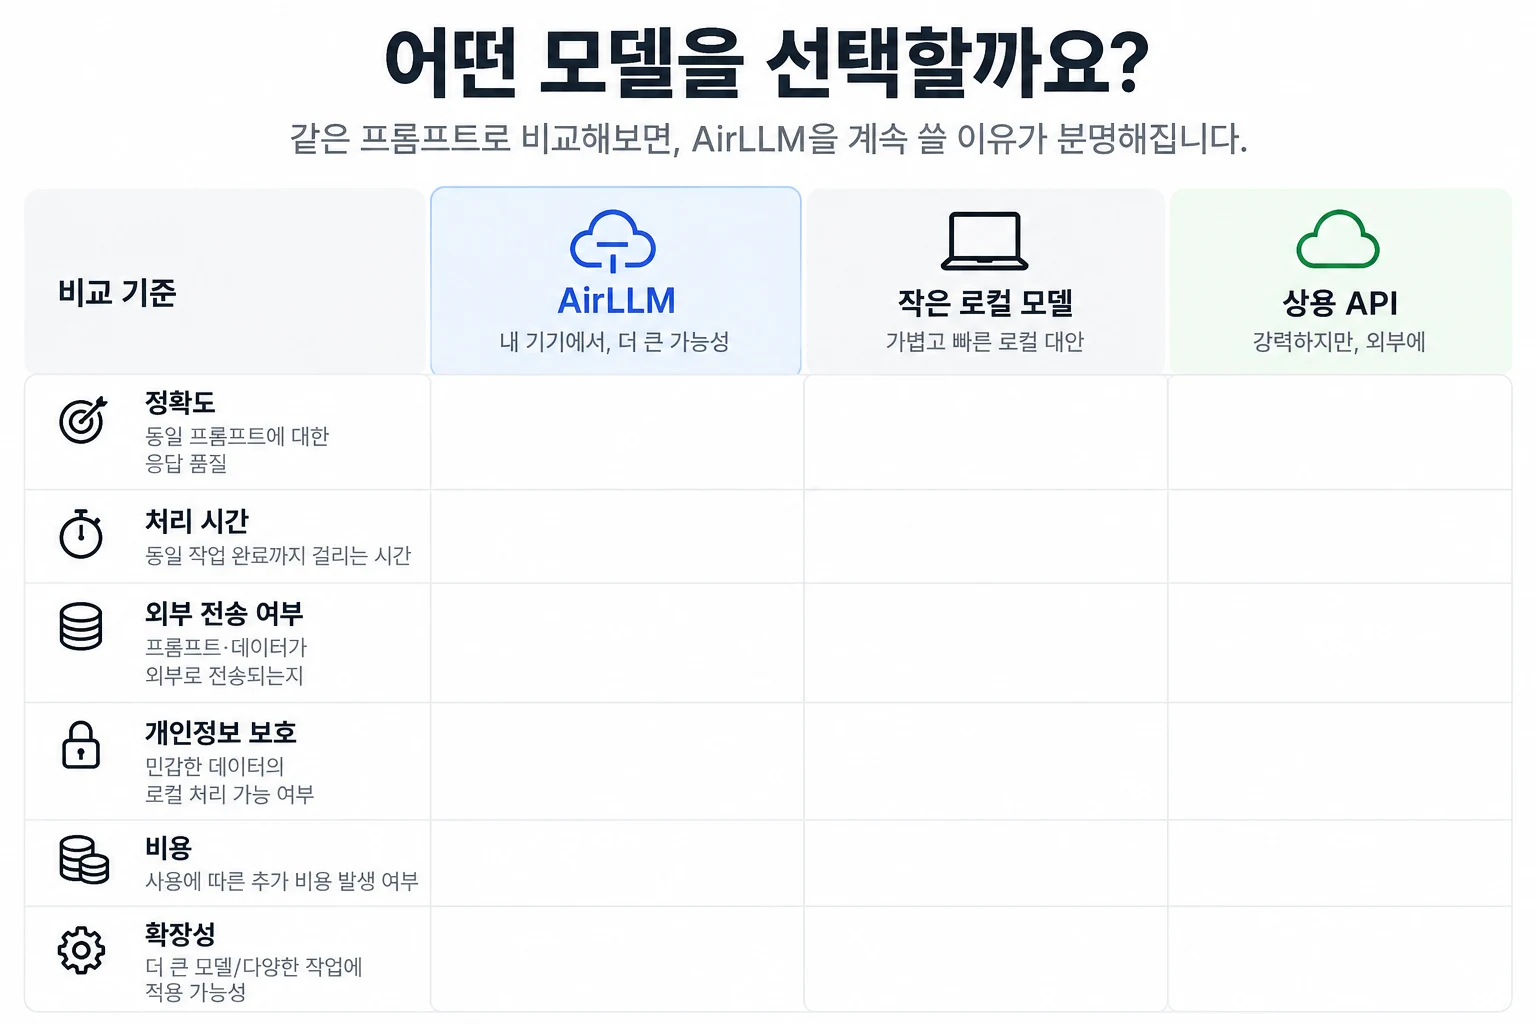
비교 대상도 하나는 있어야 합니다. 같은 프롬프트를 작은 로컬 모델이나 상용 API에 넣고 정확도·처리 시간·외부 전송 여부를 나란히 적으면 AirLLM을 계속 쓸 이유가 분명해집니다. 원본 70B가 작은 모델보다 별로 낫지 않다면 느린 실행을 감수할 이유도 없습니다.
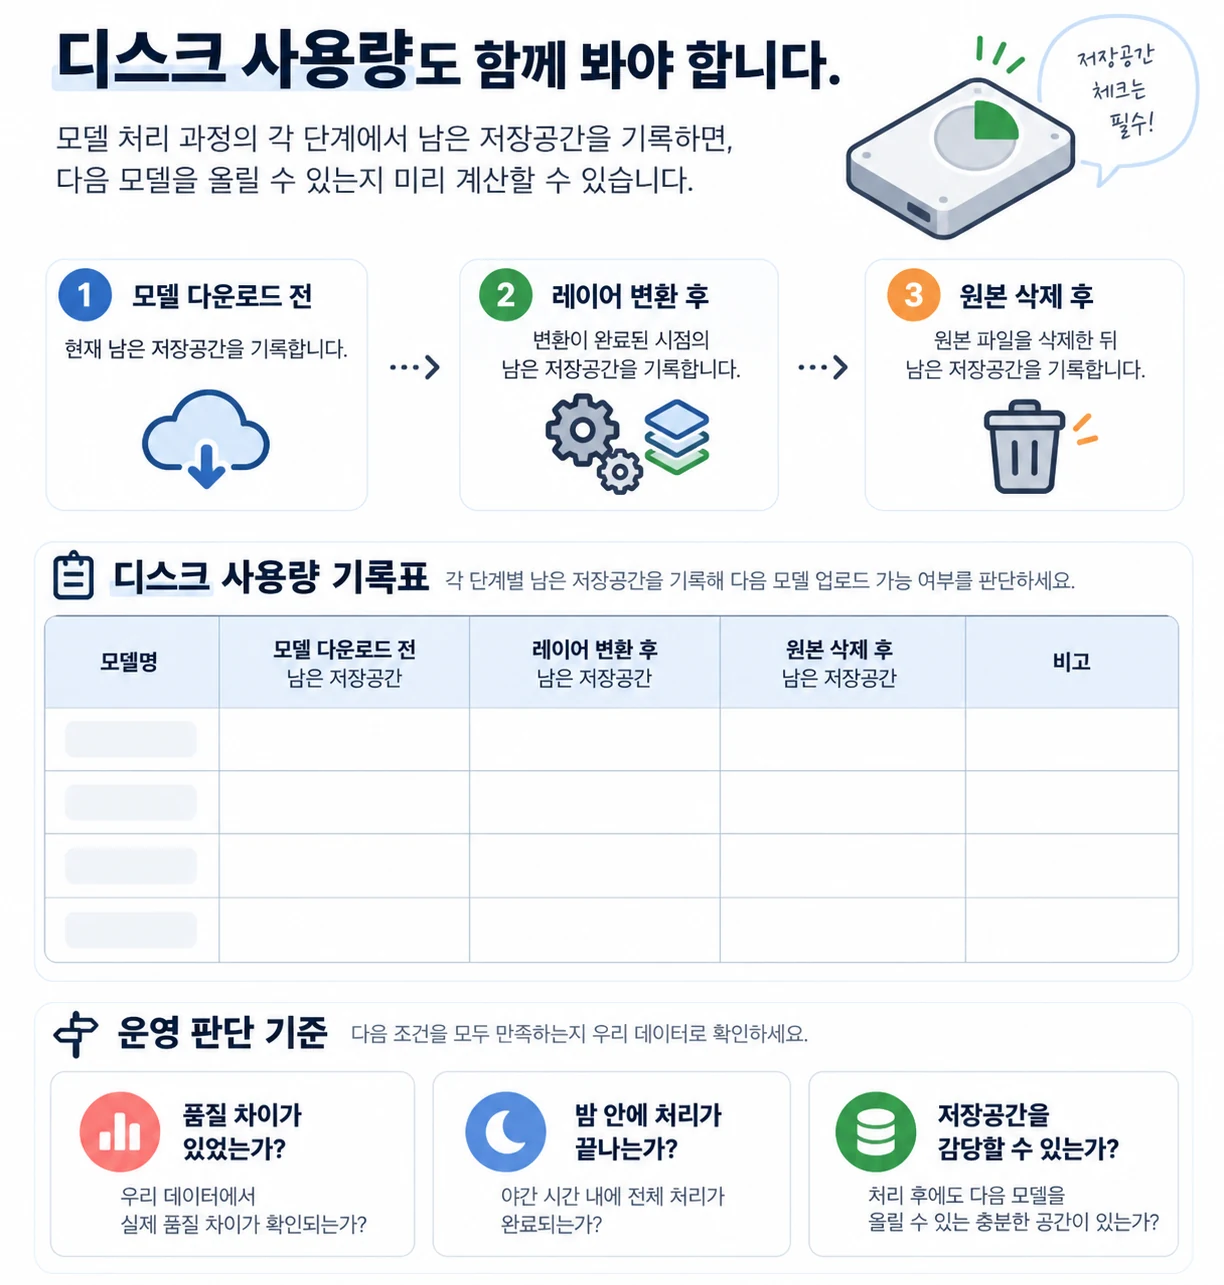
디스크 사용량도 함께 봐야 합니다. 모델 다운로드 전, 레이어 변환 후, 원본 삭제 후의 남은 공간을 각각 기록하면 다음 모델을 올릴 수 있는지 계산할 수 있습니다. 운영 판단은 “실행됐다”가 아니라 우리 데이터에서 품질 차이가 있었고, 밤 안에 처리가 끝나며, 저장공간을 감당할 수 있는가로 내려야 합니다.
정리
AirLLM은 “작은 GPU로도 큰 모델이 돌아간다”는 문장만 보면 만능처럼 들립니다. 실제로는 속도를 내주는 대신 대형 오픈소스 모델에 접근할 수 있게 만든 도구예요.
모델 품질 확인, 사내 데이터 검증, 밤샘 일괄 처리처럼 응답을 기다릴 필요가 없는 작업에는 잘 맞습니다. 반대로 실시간 챗봇이나 사용자용 API라면 양자화 모델, 클라우드 GPU, 전용 추론 서버가 더 나은 선택입니다.
먼저 정할 것은 하나입니다. 지금 필요한 게 답을 빨리 받는 것인지, 원본 모델의 답을 정확히 보는 것인지.
70B를 실행하기 전, 저장공간과 대기시간을 계산해 봅시다
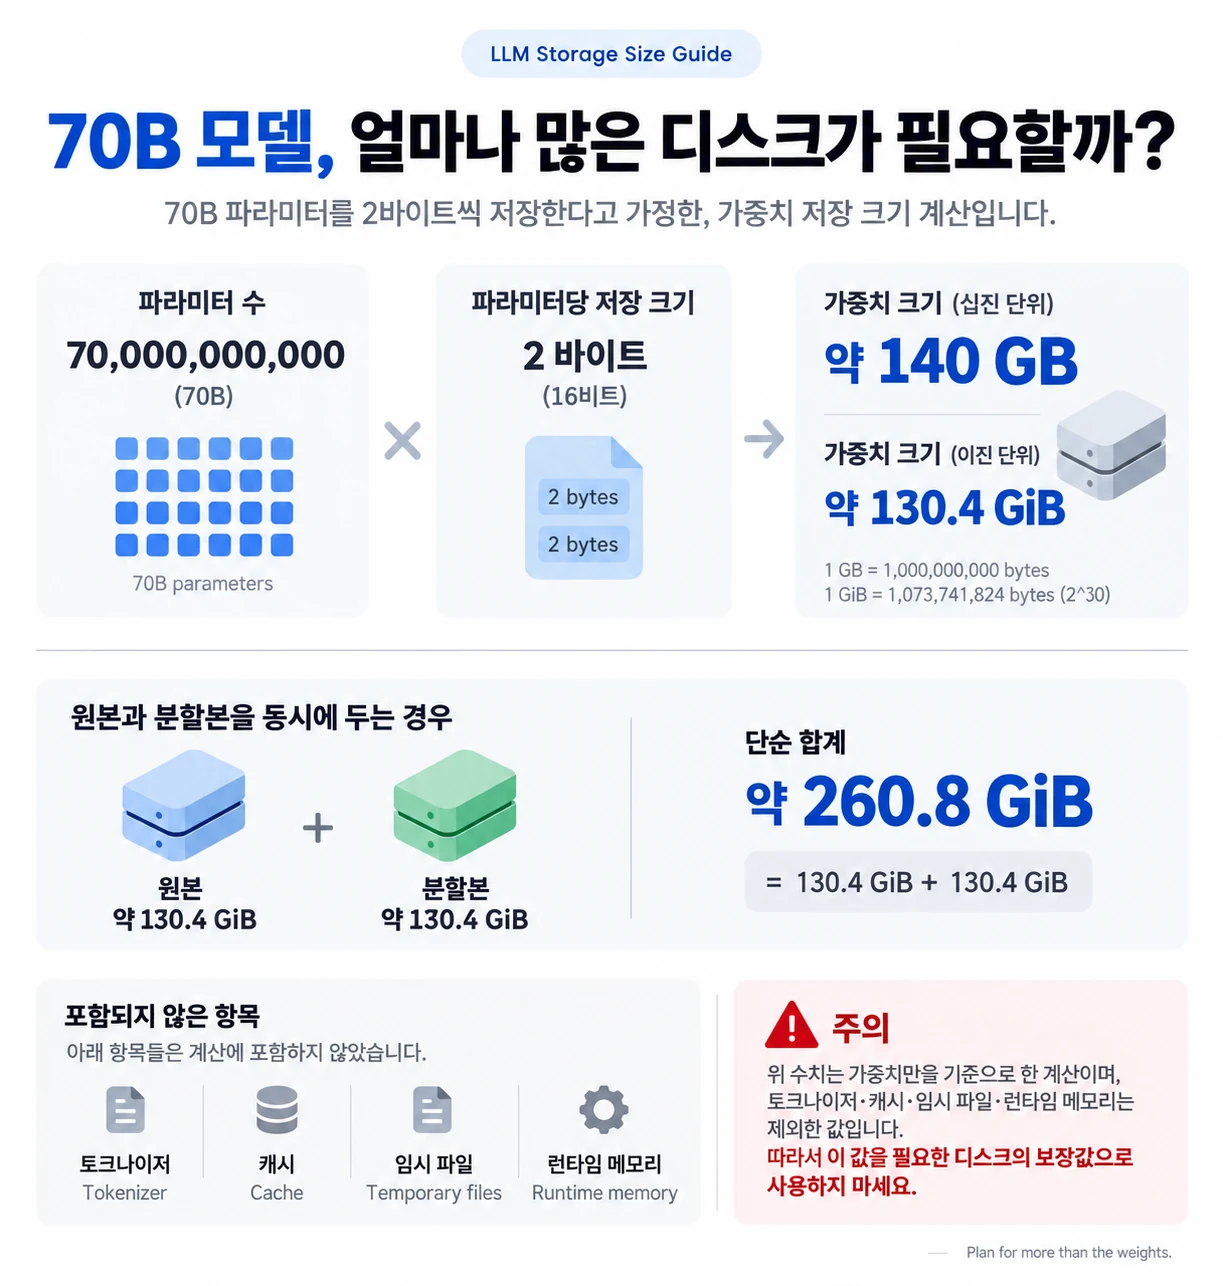
70B 파라미터를 2바이트씩 저장한다고 가정하면 가중치만 약 140GB, 이진 단위로 약 130.4GiB입니다. 원본과 분할본을 동시에 두는 경우 단순 합계는 약 260.8GiB가 됩니다. 토크나이저·캐시·임시 파일·런타임 메모리는 제외한 값이므로 필요한 디스크의 보장값으로 쓰면 안 됩니다.
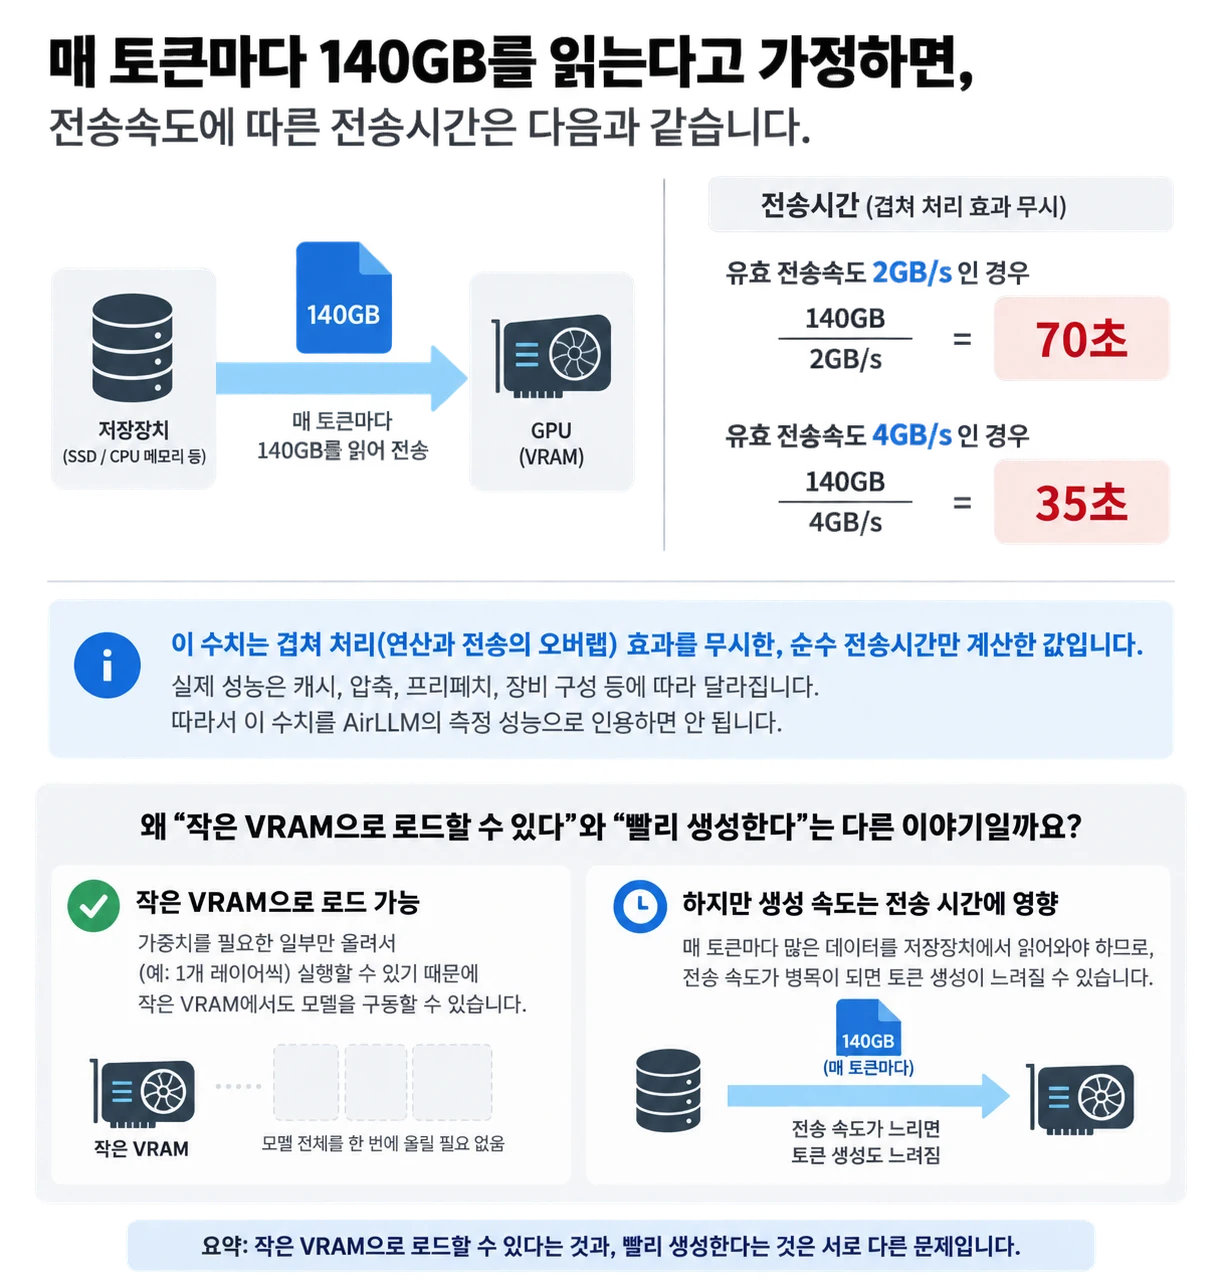
매 토큰마다 140GB를 읽어야 하고 유효 전송속도가 초당 2GB라고 가정하면, 겹쳐 처리하는 효과를 무시한 전송시간은 70초입니다. 4GB/s라면 35초입니다. 실제 캐시·압축·프리페치와 장비 구성에 따라 달라지므로 AirLLM의 측정 성능으로 인용하면 안 됩니다. 작은 VRAM으로 로드할 수 있다는 사실과 빨리 생성한다는 사실이 왜 다른지 보여주는 계산입니다.
계산 입력과 결과 CSV를 제공했습니다. 디스크 여유와 기다릴 수 있는 시간을 먼저 정하고, 허가된 장비에서 짧은 입력으로 첫 토큰 시간·전체 완료시간·최대 메모리를 재세요. 데이터 100건을 야간에 처리할 수 있는지는 이 표본 측정 뒤에 판단할 수 있습니다.
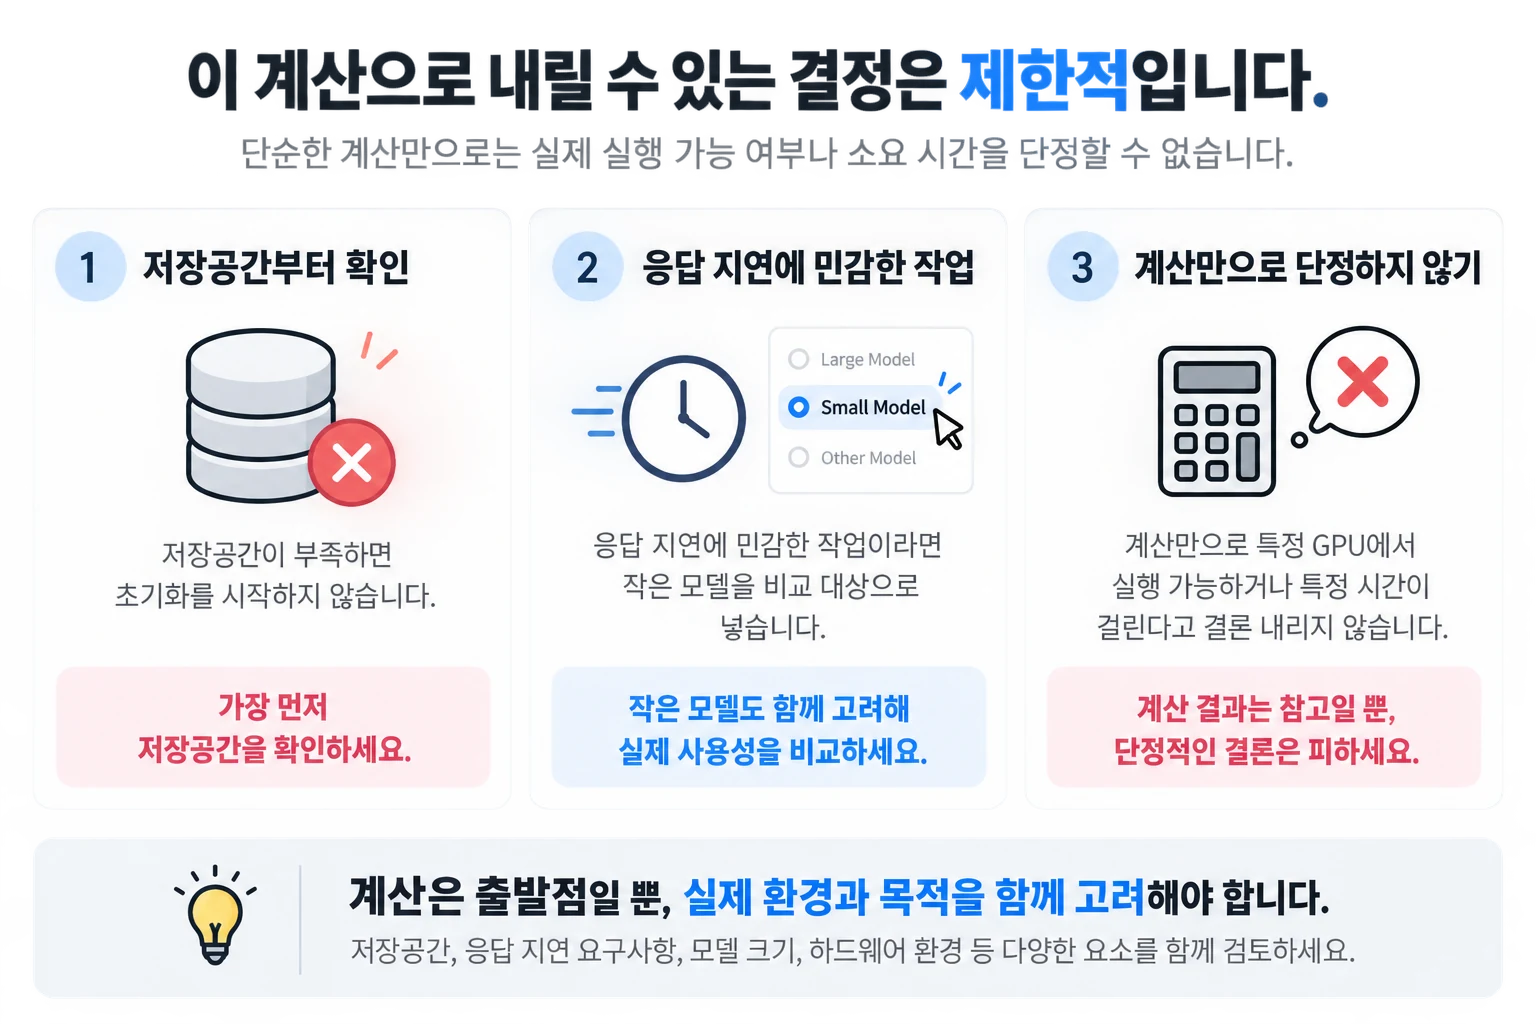
이 계산으로 내릴 수 있는 결정은 제한적입니다. 저장공간부터 부족하면 초기화를 시작하지 않고, 응답 지연에 민감한 작업이라면 작은 모델을 비교 대상으로 넣습니다. 계산만으로 특정 GPU에서 실행 가능하거나 특정 시간이 걸린다고 결론 내리지 않습니다.
출처
- lyogavin/airllm - GitHub README (Apache-2.0). 별 개수, VRAM 표, Kimi K3 측정치, 압축 옵션, macOS 조건은 모두 이 문서 기준입니다.
확인 날짜: 2026년 9월 14일. 기존 문서 설명과 이번 검증 범위는 본문에서 구분했습니다. 원문이 갱신되면 이 글의 수치도 달라질 수 있습니다.
자주 묻는 질문
- AirLLM을 쓰면 정확도가 떨어지나요?
- 원본 가중치를 이동하는 방식 자체는 양자화와 다릅니다. 다만 이 글에서 출력 품질이 동일한지 실험한 것은 아닙니다. 양자화·증류·프루닝처럼 가중치를 손대는 방식이 아니라, 원본 가중치를 그대로 두고 레이어를 순서대로 GPU에 올렸다 내리는 방식이기 때문입니다. 다만 속도를 올리려고 4bit/8bit 압축 옵션을 켜면 그때는 가중치를 줄이는 것이므로 손실이 생깁니다. 저자는 손실이 무시할 수준이라고 밝히고 있습니다.
- 실시간 챗봇이나 서비스 백엔드로 써도 되나요?
- 권하지 않습니다. 토큰을 하나 만들 때마다 모델 전체 레이어를 디스크에서 GPU로 순서대로 옮기는 구조라, 응답이 사람이 기다릴 수 있는 속도로 나오기 어렵습니다. 일괄 작업도 먼저 표본의 실제 처리시간을 측정해야 합니다. 이 글에는 해당 장비의 속도 실측값이 없습니다.
- 디스크는 얼마나 필요한가요?
- 모델 원본을 받은 뒤 레이어별로 쪼개 다시 저장하기 때문에 한동안 원본과 변환본을 둘 다 들고 있게 됩니다. 여유가 없다면 초기화할 때 delete_original 옵션을 켜서 원본을 지우고 변환본만 남길 수 있습니다. 디스크가 모자라면 safetensors 헤더 오류로 실패합니다.