DataFlow: An LLM-Driven Framework for Unified Data Preparation and Workflow Automation in the Era of Data-Centric AI — SFT 데이터 선별·생성 pipeline 분석
DataFlow의 storage·operator·pipeline·agent를 SQL 예제로 설명한다. pre-training·SFT 데이터 선별과 수학·코드·SQL·RAG benchmark를 원문 figure·table, 공개 구현과 함께 분석한다.
- #논문 리뷰
- #DataFlow
- #LLM 학습 데이터
- #data pipeline
- #synthetic data
- #DataFlow-Agent
1. DataFlow 요약: LLM 학습 데이터를 만드는 pipeline
DataFlow는 다섯 contributions를 제시한다. LLM 중심의 공통 data-preparation framework, 약 200개 operator와 6개 template pipeline으로 구성한 ecosystem, PyTorch형 API·IDE tooling·Python package 확장을 제공하는 programming model, 자연어로 pipeline을 구성하는 DataFlow-Agent, 여러 task의 실험 검증과 생성 데이터 공개다. 아래에서는 이들을 공통 구조, 데이터 처리와 downstream 결과, agent, 구현·재현 순서로 연결한다. 핵심 질문은 어떤 데이터 처리 과정이 어떤 학습 결과로 이어졌고, 이를 어떻게 다시 구성할 수 있는가다.
대표 결과는 통합 10K 데이터로 학습한 Qwen2.5-7B의 수학 평균 46.7이다. 같은 표의 기본 모델은 37.1, Infinity-Instruct 1M 비교 모델은 33.3이다. 각각 9.6점, 13.4점 차이다. 또한 독립 code 실험의 Qwen2.5-7B에서 동일한 1K 조건을 비교하면 Code Alpaca 42.1, Self-OSS 43.2, DataFlow 45.4다. 소량의 데이터를 어떤 방식으로 만들고 고르는지가 downstream 결과에 영향을 준다는 근거다.
DataFlow-Agent는 별도 성과로 읽는다. 18개 요청에서 text-based score는 easy 0.92, medium 0.86, hard 0.60이며, code-based score는 0.60, 0.59, 0.23이다. 요구를 구체적으로 주면 pipeline을 더 잘 구성하지만 높은 수준의 목표만 주면 격차가 커진다. 이 점수는 LLM judge의 구조 평가이지 실제 작업 성공률이 아니다.
본문은 공통 architecture → generate/evaluate/filter/refine이 데이터로 연결되는 과정 → task별 downstream 결과 → 자연어 workflow automation의 평가 → 구현과 재현 순으로 구성한다. 수학·코드·SQL·RAG·지식 추출의 원본 표를 각각의 실험 설명에 포함하며, 크게 개선된 조건과 개선되지 않은 조건을 함께 읽는다.
이 글은 DataFlow v1 원문의 본문, 참고문헌, 저자 기여 부록까지 36쪽을 읽은 학습용 리뷰다. 2025년 12월 18일 제출본이며 표지는 12월 19일이다. 원문 그림과 표의 숫자는 그대로 두고, 해석에서 발견한 조건 차이와 본문·표의 불일치를 설명한다. 공개 코드도 논문 시점에 가까운 고정 버전으로 따로 확인한다. 여기서 모델을 학습하거나 LLM API를 실행해 논문 점수를 재현한 것은 아니다.
2. LLM data preparation: 파일 처리와 의미 평가의 차이
2.1 Data preparation에서 semantic evaluation이 필요한 이유
일반적인 데이터 pipeline은 CSV의 빈 값을 채우고 날짜 형식을 맞추는 데 익숙하다. 입력이 같으면 규칙에 따라 결과를 쉽게 예상할 수 있다. 학습 데이터 준비에서는 “이 질문이 모호한가”, “이 답의 근거가 문서에 있는가” 같은 판단이 필요하다. 문자열 규칙만으로 해결하기 어려워 LLM이나 별도 평가 모델을 처리 중간에 넣는다.
예를 들어 “작년 매출을 알려줘”라는 질문에는 기준 연도가 빠져 있다. 형식상 JSON은 올바르지만 학습 문제로는 불완전할 수 있다. 질문을 새로 만들고, 모호성을 평가하고, 나쁜 예시를 제외하는 순환이 필요하다. DataFlow의 중심은 이런 의미 단위의 생성·평가·선별을 재사용 가능한 코드로 표현하는 것이다.
전통적인 대용량 처리 엔진도 사용자 함수를 통해 모델을 호출할 수 있다. 논문은 그것이 불가능하다고 증명하지 않는다. 대신 LLM 호출, prompt, 도메인별 operator를 한 체계로 제공할 때 작성과 교체가 쉬워진다는 설계 관점을 제시한다.
2.2 Framework 비교표의 근거와 범위
왼쪽 두 시스템은 정제와 대규모 데이터 관리에, DataFlow는 LLM을 이용한 합성과 수정에 무게를 둔다.
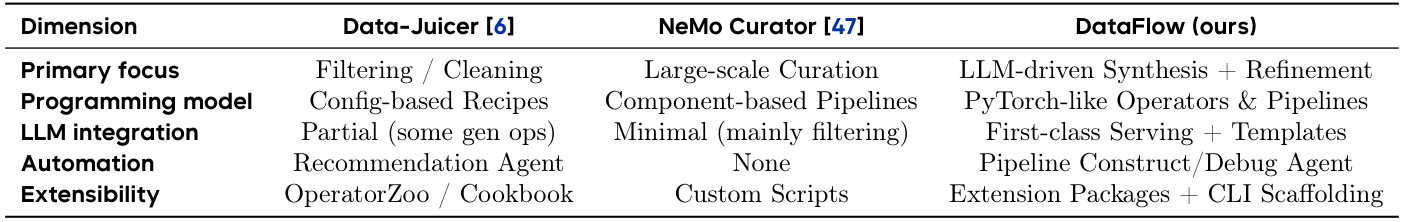
여기서 배울 것은 “어느 시스템이 무조건 더 좋다”보다 무엇을 코드의 기본 단위로 삼았는가다. DataFlow는 모델 호출과 prompt를 operator와 함께 조합하는 구성을 강조한다.
원문은 앞쪽 관련 연구에서 NeMo의 합성 데이터 기능과 Data-Juicer의 생성 operator도 설명한다. 따라서 이 표를 보고 기존 도구에는 생성 기능이 없다고 말하면 원문 자체와도 맞지 않는다. 표 1은 동일한 데이터·장비·작업량으로 속도와 품질을 측정한 실험이 아니다. “최초”나 “최고”라는 표현 역시 별도의 포괄적 비교로 검증된 사실로 확대하지 않는다.
3. DataFlow architecture: storage·serving·operator·prompt·pipeline
그림을 왼쪽에서 오른쪽으로 읽어 보자.
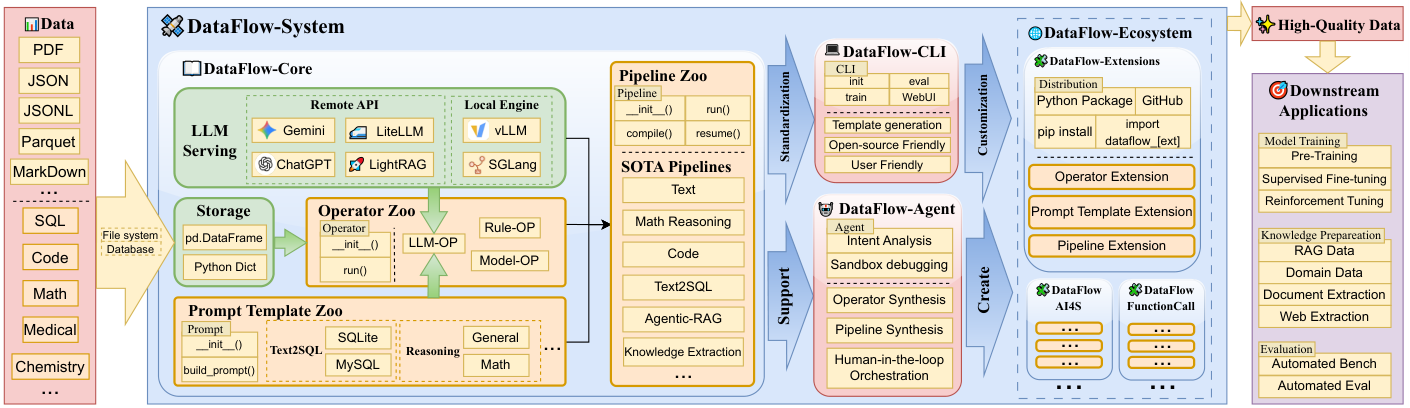
원자료는 PDF, JSON, SQL, 코드처럼 형태가 다르다. 중앙의 핵심 계층은 이 자료를 저장하고, 필요한 모델을 호출하고, 처리 결과를 다음 단계로 넘긴다. 오른쪽에는 완성된 데이터를 이용하는 학습과 검색 응용이 있다. 데이터 준비 framework와 최종 모델 학습은 이 구조에서 구분된다.
3.1 Storage·serving·operator·prompt·pipeline 역할
저장소는 현재 데이터가 무엇인지 관리한다.
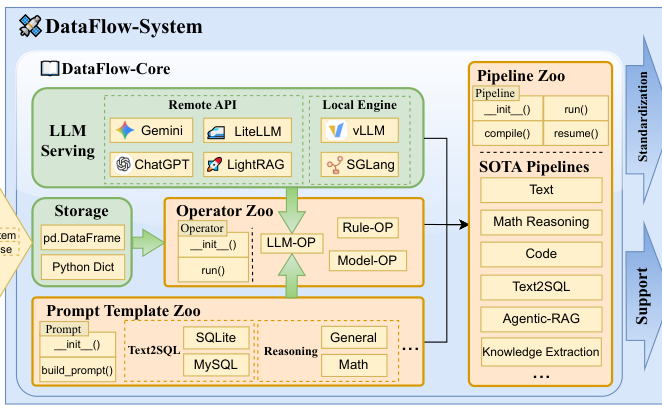
모델 호출 계층은 어느 LLM을 어떻게 부를지 맡는다. operator는 “질문을 생성한다”처럼 하나의 처리 역할을 한다. prompt 템플릿은 그 역할을 모델에 설명하는 문장을 만든다. pipeline은 이 operator를 어느 순서로 연결할지 정한다.
이렇게 나누면 “답을 검증하는 모델만 바꾸기”가 “문서 읽기부터 저장까지 전부 다시 작성하기”가 되지 않는다. 다만 인터페이스가 같다고 두 모델의 판단 기준까지 같아지는 것은 아니다. 모델을 바꿨을 때 통과 데이터의 비율과 종류도 다시 살펴야 한다.
3.2 CLI와 DataFlow-Agent의 실행 경로
명령행 도구인 CLI는 operator나 pipeline을 작성할 기본 파일 구조를 만든다.
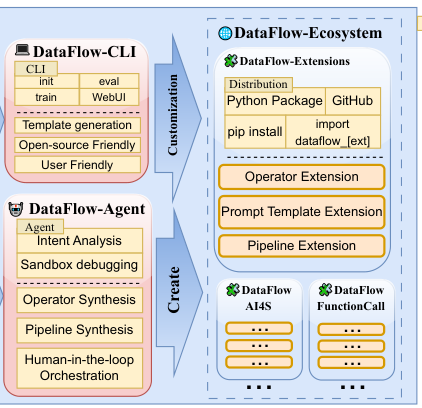
agent는 사람이 “문서를 질문·답으로 바꾸고 품질이 낮은 것을 제외해 줘”라고 요청했을 때 필요한 단계를 고른다. 확장 패키지는 도메인별 operator와 prompt를 별도 Python 패키지로 배포하는 통로다.
논문은 약 200개의 operator와 여러 prompt를 소개한다. 도입부에는 180개 이상·90개 이상의 템플릿, 결론에는 거의 200개·80개 이상이라는 표현이 나온다. 고정된 정확한 개수보다 당시 제공한 범위를 설명하는 근삿값으로 이해하는 편이 맞다. 실험은 텍스트, 수학, 코드, SQL, agent형 검색, 지식 추출을 다룬다.
4. Operator 유형: generate·evaluate·filter·refine
1,000행짜리 질문 표가 있다고 하자.
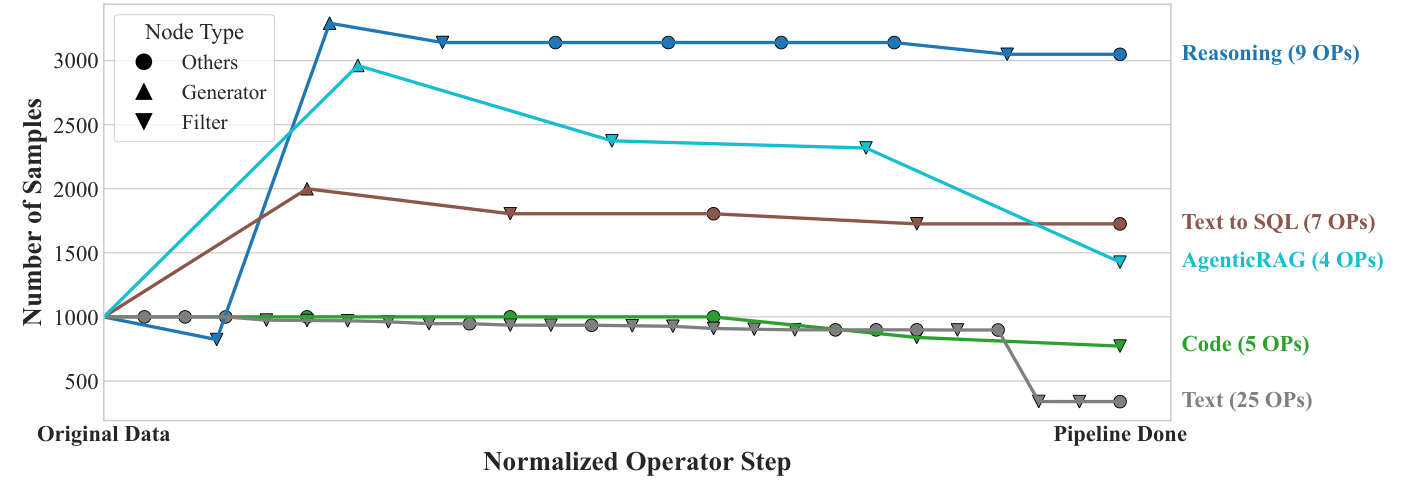
각 질문에 답 열을 붙이면 여전히 1,000행이다. 질문 하나에서 새 질문 세 개를 만들면 행이 늘 수 있다. 나쁜 문제를 제외하면 행이 줄어든다. 문장 안의 불필요한 URL을 지우는 수정은 보통 행 수를 바꾸지 않는다.
논문은 생성 operator를 새 필드를 만드는 Generator와 새 행을 만드는 RowGenerator로 구분한다. 평가 operator는 예시별 점수나 dataset 전체 통계를 만든다. 필터는 조건에 따라 행을 선택하고, 수정 operator는 행 안의 내용을 바꾼다. 이것이 생성·평가·필터·수정의 네 기능이다.
그림에서 수학 pipeline은 생성 단계 뒤 행이 크게 늘었다가 필터를 거친다. 텍스트 pre-training용 정제는 행이 줄어드는 쪽이 두드러진다. 수학은 9개, 코드는 5개, SQL은 7개, 텍스트는 25개, 검색 질문은 4개의 operator로 표시되어 있다. 가로 위치가 같다고 같은 개수의 연산이나 같은 계산 시간을 썼다는 뜻은 아니다.
원문 캡션은 텍스트와 코드 pipeline에 생성 요소가 없다고 표현하지만, 본문 분류는 기존 행에 새 필드를 만드는 것도 생성으로 다룬다. 행 수가 늘지 않았다는 사실만으로 LLM 생성이 없었다고 결론 내릴 수 없다. 그림의 표본 수 흐름과 뒤의 코드 데이터 합성 실험을 동일한 생성량 그래프로 단정하지 않는다.
이 설계에서 중요한 점검 대상은 최종 행 수뿐이 아니다. 어떤 질문이 빠졌는지, 점수 기준을 바꾸면 어떤 주제가 줄어드는지, 수정 전후 정답이 유지되는지도 봐야 한다. “데이터가 깨끗해졌다”는 말을 실제 학습 성능과 연결하려면 다음 실험처럼 같은 모델에 넣어 비교해야 한다.
5. DataFlow-Agent: 자연어 요청으로 pipeline 구성하기
그림의 역할들은 요청 해석부터 구성·검증까지 이어지는 작업 흐름을 나타낸다.
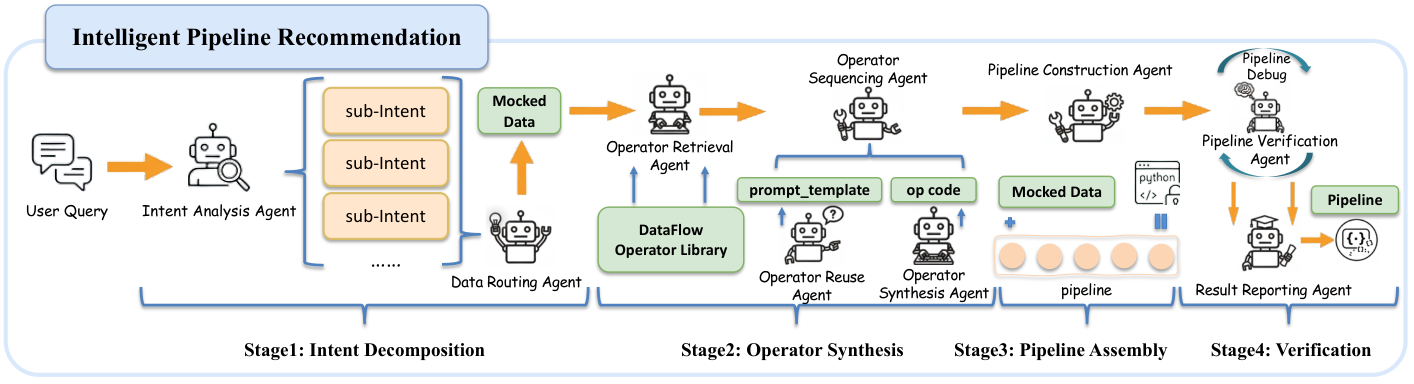
그림의 경로는 요청 해석에서 필요한 operator 탐색·재사용·생성으로 이어지고, pipeline을 조립한 뒤 검증 결과를 다음 수정에 전달한다. 자연어를 곧바로 한 번의 코드 생성으로 끝내지 않고 사용 가능한 operator와 실행 피드백에 연결하는 것이 DataFlow-Agent의 contribution이다. 이 구조가 실제로 얼마나 잘 작동하는지는 뒤의 18개 요청 평가에서 따로 확인한다.
아홉 역할이 모두 독립 모델로 동시에 실행된다는 설명은 아니다.
5.1 Agent가 요청을 operator 요구로 나누는 방법
“제품 문서를 학습 데이터로 바꿔 줘”는 그대로 실행할 수 있는 명세가 아니다.
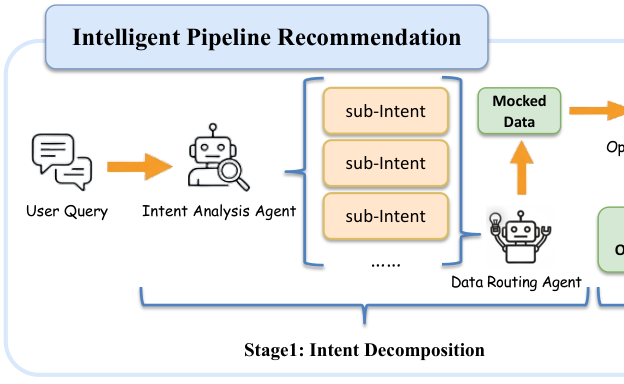
원문을 나누는 기준, 질문 생성 방식, 정답 근거 조건, 저장 열 이름이 빠져 있다. 의도 분석 역할은 요청을 작은 처리 요구로 나누고, 데이터 routing 역할은 입력 형태와 작업 종류를 파악한다. 입력이 없으면 시험용 데이터를 만드는 흐름도 논문에 있다.
시험용 데이터는 연결이 되는지 확인하는 데 유용하다. 그러나 실제 문서의 복잡한 표, 긴 문장, 누락된 값까지 대표하는 것은 아니다. 시험 입력에서 실행됐다는 결과와 실제 분포에서 정확한 학습 데이터를 만들었다는 결과를 구분해야 한다.
5.2 Operator retrieval·reuse·generation
operator 검색 역할은 라이브러리에서 요구와 비슷한 기능을 찾는다.
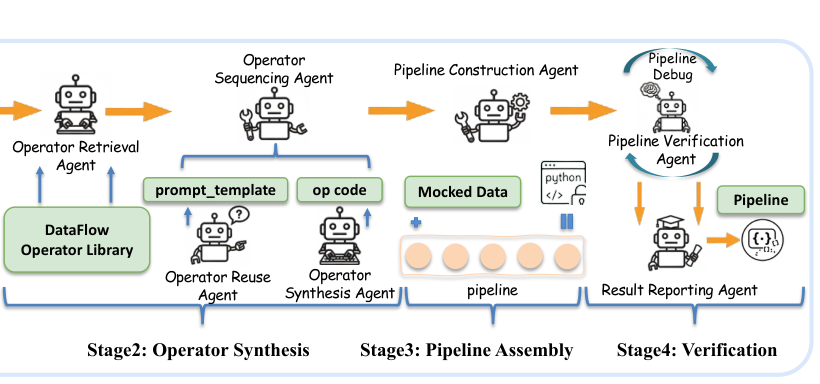
순서 결정 역할은 후보의 입출력이 맞는지 보고 어떤 것을 쓸지 정한다. 재사용 역할은 기존 코드와 prompt로 요구를 충족할 수 있는지 살핀다. 부족한 기능은 생성 역할이 작성하고 오류를 고치는 대상으로 삼는다.
여기에 의도 분석, 데이터 routing, pipeline 조립, pipeline 검증, 결과 보고를 더하면 논문이 열거한 아홉 역할이 된다. 아홉 개의 역할 이름이 곧 아홉 모델을 항상 병렬로 실행한다는 뜻은 아니다. 논문은 LangGraph로 상태와 흐름을 조정하는 구조를 설명한다.
원문 5.1절은 재사용 역할을 생성된 코드의 재사용 가능성을 평가하는 방식으로 쓰고, 5.2절은 새 코드를 생성하기 전에 기존 기능 재사용을 먼저 검토한다고 설명한다. 여기서는 “가능하면 기존 기능을 쓰고, 부족한 부분을 작성한다”는 설계 취지를 읽는다. 정확한 분기와 실행 횟수는 공개 코드의 확인 범위로 따로 남긴다.
5.3 Execution validation과 task correctness의 차이
조립 역할은 선택된 operator를 연결하고, 검증 역할은 sample 데이터로 실행하면서 연결이나 인자의 오류를 찾는다. 최종 보고 역할은 결과와 pipeline을 전달한다. 이 흐름이 줄이려는 것은 사람이 매번 같은 연결 코드를 쓰고 실행 오류를 고치는 부담이다.
그렇지만 예외 없이 실행된 코드가 올바른 질문을 만든다는 보장은 없다. “답에 원문 근거가 있다” 같은 의미 조건을 실제로 검사해야 한다. 또 논문의 sandbox 표현을 운영체제 수준의 완전한 격리로 자동 해석할 수 없다. 아래 코드 점검에서는 실제 실행 경계와 검증 범위를 확인하고, 실험에서는 자동 구성 성능이 얼마나 남아 있는 문제인지 본다.
6. Text-to-SQL 예제: 생성·실행·검증 흐름
새 SQL과 질문을 만드는 경로와 기존 자료를 확장하는 경로를 구분해 읽어야 한다.
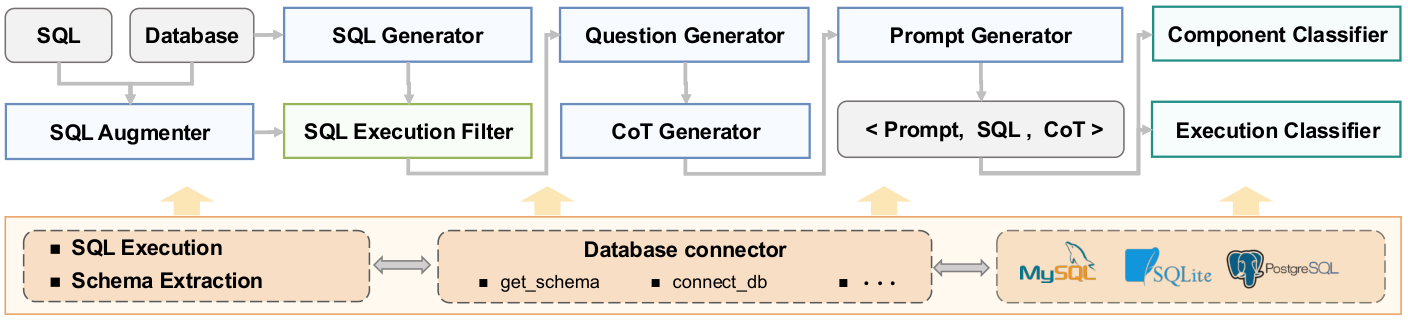
이 pipeline은 SQL에서 질문 후보를 만든 뒤 SQL 실행과 answer match, reasoning 검사를 거쳐 학습 쌍을 선별한다. 따라서 단순히 질문 수를 늘리는 방법이 아니라 실행 가능한 SQL과 답의 일치를 생성 과정에 넣는 설계다. 그 결과의 유용성은 뒤의 model별 Text-to-SQL benchmark로 확인한다.
SQL을 실행해 확인하는 단계가 있어도 질문과 SQL의 의미가 완전히 일치한다는 보장은 별도 문제다.
6.1 SQL에서 자연어 질문을 만드는 순서
상품과 주문 테이블이 있다고 가정하자. “지난달 제품별 주문 수”를 묻는 문제를 만들려면 존재하는 열을 쓰고, 테이블을 올바르게 연결하고, 날짜 조건을 정확히 정해야 한다. SQL 생성 operator는 테이블 정의와 일부 값 예시를 참고해 질의를 만든다. 난도와 사용할 기능을 바꿔 단순 조회뿐 아니라 집계나 중첩 질의도 포함하려는 것이다.
원문은 네 수준의 복잡도를 선택하고 예시와 추가 제약을 모델에 제공한다고 설명한다. 생성한 SQL이 유효한지는 다음 실행 필터에서 살핀다. 그 뒤 질문 생성 operator가 SQL의 의미에 맞는 자연어 질문을 만든다. SQL부터 시작하면 질문의 답을 데이터베이스 실행으로 확인할 기준을 확보할 수 있다.
질문 스타일은 정중한 문장, 일상적 표현, 명령형, 간결한 문장 등으로 바꾼다. 원문에는 모호하거나 비유적인 스타일도 포함되어 있다. 다양한 표현을 만드는 것과 학습 문제의 의미를 명확히 유지하는 것 사이에는 긴장이 있다. 형식 다양화가 곧 의미 정확성이라는 가정은 피해야 한다.
6.2 SQL question augmentation 전 일치 검사
SQL 증강 operator는 기존 SQL을 변형한다. 원문이 제시한 여섯 방향은 값 변경, 질의 구조 변경, 업무 논리 변경, 복잡도 상승, 고급 SQL 기능 도입, 성능 최적화다. 단순히 같은 질문의 어미만 바꾸는 것보다 다양한 계산과 구조를 포함하려는 목적이다.
기존 질문·SQL 쌍에서 시작하는 수정 pipeline은 실행 여부와 질문·SQL의 의미 일치를 먼저 확인한다. 의미 일치 필터는 LLM의 판단을 이용한다. 실행 가능하더라도 “합계”를 물었는데 “평균”을 계산하면 잘못된 예시이기 때문이다. 원래 데이터의 오류를 확인하지 않고 변형하면 그 오류가 새 데이터로 퍼질 수 있다.
새 SQL을 만드는 pipeline과 기존 SQL을 증강하는 pipeline은 출발점이 다르지만, 생성한 SQL을 걸러 내고 질문과 학습 입력을 구성하는 뒤쪽 단계는 공유한다. 이런 공통 부분을 operator로 분리하는 것이 framework의 재사용 사례다.
6.3 SQL 실행·answer match·reasoning 검사
실행 필터는 SQL이 해당 데이터베이스에서 실행되는지, 제한 시간 안에 끝나는지 확인한다. 이는 문법·테이블·열 오류를 줄이는 데 도움이 된다. 그러나 실행 성공만으로 질문과 의미가 맞는지 알 수는 없다.
풀이 설명 생성기는 질문, schema, SQL을 바탕으로 단계적인 설명과 최종 SQL을 생성한다. 원문은 최종 SQL의 실행 결과가 기준 SQL의 결과와 같은지 검사한다고 설명한다. 이것은 한 데이터베이스에서 결과가 일치했다는 검사다. 모든 가능한 데이터베이스에서 두 질의가 동치라는 증명이나 설명의 모든 중간 문장이 타당하다는 증명은 아니다. 생성한 설명은 모델 내부 사고를 직접 관찰한 기록도 아니다.
prompt 생성기는 질문과 schema, 작업 지시를 학습 모델의 입력으로 묶는다. SQL 구성 요소 분류기는 집계·중첩·집합 연산 같은 구문을 보고 구조적 난도를 나눈다. 실행 기반 난도 분류기는 특정 모델에 같은 문제를 여러 번 풀게 하여 성공 비율을 본다. 이 두 난도는 서로 다르다.
예를 들어 여덟 번 생성한 답 중 여섯 번이 맞으면 관측 성공 비율은 6/8이다. 논문 표기의 뜻을 식으로 쓰면 다음과 같다.
여기서 는 시도 횟수, 은 그중 성공 횟수다. 같은 SQL 구조라도 사용하는 모델과 sampling 설정이 달라지면 이 비율이 달라질 수 있다. 따라서 실행 기반 난도를 데이터에 영원히 고정된 속성으로 보기는 어렵다.
데이터베이스 연결 계층은 접속, 실행, schema 조회를 공통 인터페이스로 묶는다. SQL 문법은 prompt와 커넥터에 맞춰야 한다. 이 리뷰에서는 실제 데이터베이스에 질의를 보내거나 생성된 SQL을 실행하지 않았다.
7. 텍스트 데이터 benchmark: pre-training·SFT·대화 선별
7.1 Pre-training 데이터 선별: 같은 token budget 비교
pre-training은 모델이 많은 문장을 읽으며 언어와 지식을 배우는 단계다.
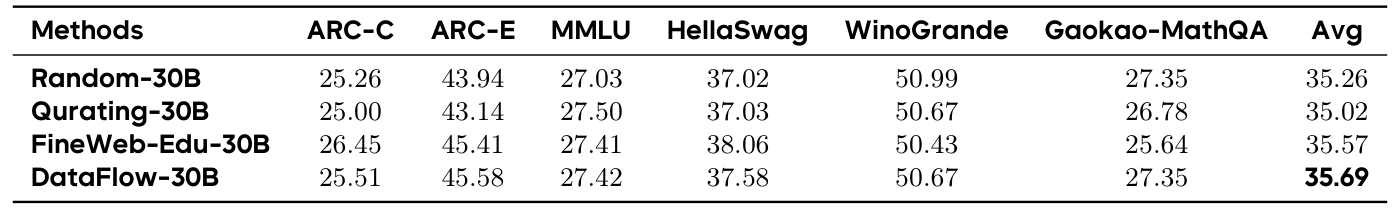
이 실험의 질문은 “같은 양을 읽힐 때 어떤 문장을 고르는 것이 좋은가”다. 저자들은 SlimPajama의 6,270억 token 가운데 1,000억 token 부분집합을 사용하고, 각 방식으로 300억 token을 골라 같은 크기의 모델을 처음부터 학습한다. 무작위 선택, Qurating, FineWeb-Edu, DataFlow 필터 교집합을 비교한다.
Qurating에는 교육적 가치 7.5, 사실·상식 4.0, 전문성 5.0, 문체 1.0 이상의 기준을 준다. DataFlow는 여러 pre-training 필터의 조건을 함께 적용한다. 이런 기준은 학습에 유익할 가능성을 골라내는 대리 지표다. 기준을 통과했다고 모든 문장이 참이거나 모든 주제가 균형 있게 남는 것은 아니다.
표의 평균은 DataFlow 35.69, FineWeb-Edu 35.57, 무작위 35.26, Qurating 35.02다. 가장 강한 비교 평균보다 0.12점 높다. 개선은 있지만 큰 폭의 전면적 우세라고 표현할 크기는 아니다. ARC-E는 45.58로 가장 높고 Gaokao-MathQA는 무작위와 같은 27.35다. 반면 ARC-C는 FineWeb 26.45가 DataFlow 25.51보다 높고, MMLU는 Qurating 27.50이 27.42보다 높다. HellaSwag도 FineWeb 38.06이 37.58보다 높다.
여섯 과제 평균이 약간 높아진 결과는 같은 token 예산에서 선별 방법이 영향을 준다는 근거다. 반복 학습의 분산이나 confidence interval은 표에 없어서 0.12점 차이가 항상 재현된다고 말할 수는 없다. 또 이 pre-training 실험은 Megatron-DeepSpeed를 쓴다고 7.1절에 명시되어 있다. 앞의 실험 개요에서 “검색 reinforcement learning 외에는 LLaMA-Factory”라고 요약한 문장을 모든 실험에 일괄 적용하면 안 된다.
7.2 SFT 데이터 선별: 같은 source 안의 전후 비교
supervised fine-tuning, SFT는 질문과 답의 예시를 보여 주며 원하는 응답 방식을 학습시키는 단계다.
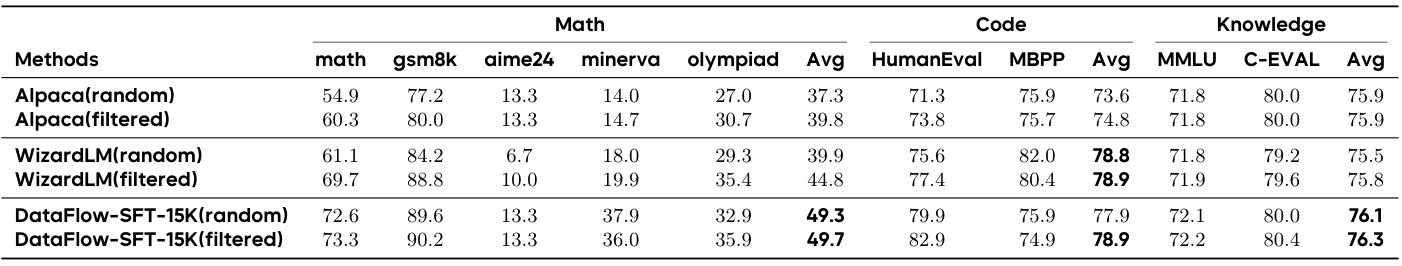
이 실험은 Qwen2.5-7B 기본 모델을 사용한다. Alpaca와 WizardLM은 각각 무작위 5,000개와 DataFlow로 선별한 5,000개를 비교한다. 별도로 Condor 생성·수정 pipeline으로 만든 15,000개 데이터의 선별 전후도 제시한다.
먼저 같은 출처의 두 행을 비교하면 선별 효과를 읽을 수 있다. Alpaca의 수학 평균은 37.3에서 39.8로, WizardLM은 39.9에서 44.8로 오른다. DataFlow 합성 데이터에서는 49.3에서 49.7로 증가폭이 작다. 이미 합성·수정을 거친 데이터에 추가 필터가 주는 변화가 다를 수 있다는 패턴이다. 하지만 초기 품질이 높아서라는 설명은 가능한 해석이며, 그 원인을 단독으로 제거한 실험은 아니다.
세부 과제를 보면 왜 평균만으로는 부족한지 알 수 있다. Alpaca의 MATH는 54.9에서 60.3, GSM8K는 77.2에서 80.0으로 오른다. WizardLM의 MATH는 61.1에서 69.7, GSM8K는 84.2에서 88.8이다. DataFlow의 MATH는 72.6에서 73.3, GSM8K는 89.6에서 90.2로 오른다. 그러나 DataFlow의 Minerva는 37.9에서 36.0으로 낮아지고 AIME24는 13.3으로 같다.
코드 평균은 Alpaca 73.6→74.8, WizardLM 78.8→78.9, DataFlow 77.9→78.9다. 이때 MBPP는 세 출처 모두 떨어진다. 각각 75.9→75.7, 82.0→80.4, 75.9→74.9다. HumanEval의 개선이 평균을 끌어올리는 구조다. 지식 평균은 Alpaca 75.9로 그대로, WizardLM 75.5→75.8, DataFlow 76.1→76.3이다. 선별이 모든 능력을 함께 높였다고 읽을 수 없다.
DataFlow 합성 데이터의 수학 평균이 다른 출처보다 높은 점은 흥미롭다. 다만 출처, 생성 모델, 정제 과정과 데이터 규모가 함께 다르다. 15K 행을 5K 행과 비교해서 framework만의 효과로 돌리면 안 된다. 원문은 DataFlow 합성 데이터의 SFT 필터에서 Instagram filter를 제외했다고 적지만, 정확한 실행 구성을 재현하려면 그 표현에 해당하는 실제 operator까지 확인해야 한다.
7.3 대화 데이터: target·general task의 변화
이 실험은 DataFlow-Chat 15,000개를 ShareGPT·UltraChat의 15,000개 부분집합과 비교한다.
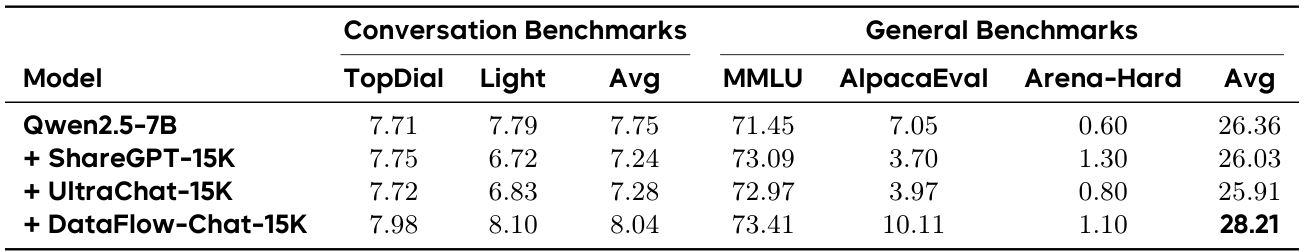
TopDial과 Light의 평균은 기본 모델 7.75, ShareGPT 7.24, UltraChat 7.28, DataFlow 8.04다. DataFlow는 TopDial 7.98, Light 8.10으로 두 대화 평가에서 모두 가장 높다. 반면 비교 데이터로 fine-tuning하면 Light가 7.79에서 6.72 또는 6.83으로 낮아진다. 단순히 대화 예시를 더 학습시키는 것만으로 목표 능력이 개선되지는 않는다는 사례다.
일반 평가에서는 MMLU가 기본 71.45에서 DataFlow 73.41로, AlpacaEval은 7.05에서 10.11로 오른다. Arena-Hard는 0.60에서 1.10으로 오르지만 ShareGPT의 1.30보다 낮다. 세 평가의 단순 평균 28.21만 보고 모든 과제에서 최고라고 말할 수 없는 이유다. 서로 다른 평가 척도를 평균한 값이라는 점도 기억해야 한다.
원문은 ShareGPT·UltraChat 전체 버전도 설정에서 언급하지만 표 4에는 15K 행만 제시한다. 이 표가 보여 주지 않는 전체 규모의 결과까지 채워 넣을 수는 없다. 확인되는 것은 이 조건에서 DataFlow의 대화 합성 결과가 유망했다는 것이다.
8. Math data benchmark: 문제 생성·검증·풀이 연결
8.1 Math sample 수와 데이터 생성 과정
수학 문제를 늘릴 때는 표현만 바꿔서는 충분하지 않다. 조건이 빠진 문제나 답이 여러 개인 문제를 많이 만들면 모델은 잘못된 지시를 배울 수 있다. 이 실험은 NuminaMath를 씨앗으로 삼고 o4-mini로 새 문제를 만든다. MathQ-Verify로 부정확하거나 모호한 문제를 확인한 뒤, DeepSeek-R1으로 단계적인 풀이를 생성한다. 이미 정제된 NuminaMath를 사용한다는 이유로 원래 pipeline의 씨앗 사전검사 단계는 생략했다고 설명한다.
최종 DataFlow 데이터 1만 개를 Open-R1과 Synthetic-1에서 각각 무작위로 고른 1만 개와 비교한다. 학습 대상은 Qwen2.5-32B-Instruct이고 한 번 또는 두 번 전체 데이터를 학습한다. 여기서 한 epoch는 dataset을 한 차례 보는 단위다. 같은 1만 개라도 두 epoch는 한 epoch보다 더 많은 학습 노출을 준다.
평가 생성 설정은 AIME 외에는 temperature 0, top-p 0.95다. AIME는 temperature 0.6, top-p 0.95, top-k 20을 사용한다. 표의 AIME24@32·AIME25@32를 다른 과제의 단일 생성 결과와 같은 절차로 취급하면 안 된다. 본문은 @32의 집계식을 충분히 정의하지 않으므로 “32번 중 한 번만 맞으면 정답인 pass@32”라고 임의로 풀어 쓰지 않는다.
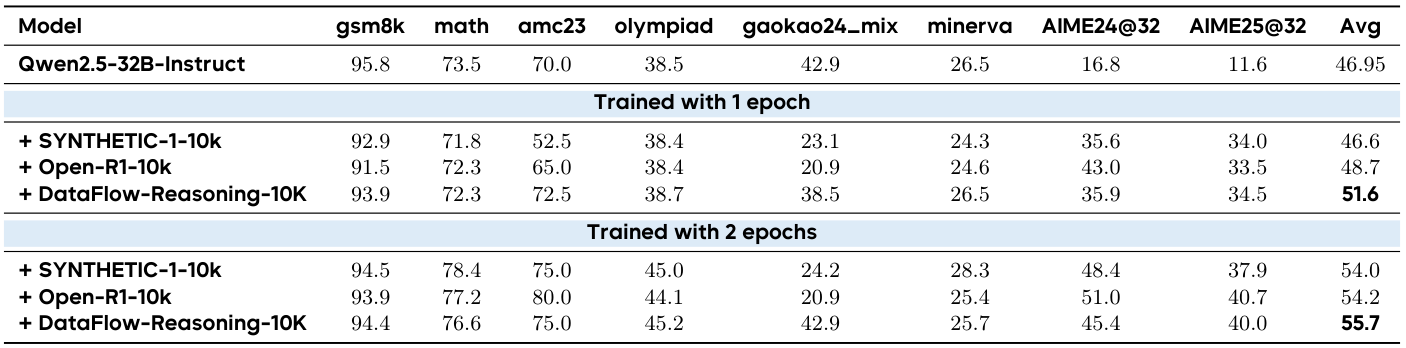
같은 10K 데이터 조건에서 epoch 수를 바꾼 비교다. 학습을 더 오래 했다는 이유만으로 모든 benchmark가 함께 개선되는지 확인해야 한다.
8.2 Math benchmark 평균과 task별 반례
기본 모델 평균은 46.95다. 한 epoch 후에는 Synthetic-1 46.6, Open-R1 48.7, DataFlow 51.6이다. 두 epoch 후에는 각각 54.0, 54.2, 55.7이다. 같은 10K·같은 epoch 조건에서 DataFlow가 가장 높은 평균을 보인다. 두 epoch 기준 Open-R1보다 1.5점, Synthetic-1보다 1.7점 높다.
어디서 차이가 나는지 보자. Gaokao24-Mix에서 DataFlow는 42.9, Open-R1은 20.9, Synthetic-1은 24.2다. 이 큰 차이가 평균 우세에 기여한다. Olympiad는 45.2로 44.1·45.0보다 조금 높다. 반면 MATH는 76.6으로 Synthetic-1의 78.4보다 낮고, AMC23은 75.0으로 Open-R1의 80.0보다 낮다. AIME24도 45.4로 Open-R1의 51.0보다 낮다. Minerva는 DataFlow 25.7, Synthetic-1 28.3이다.
기본 모델과의 비교도 필요하다. DataFlow의 두 epoch GSM8K는 94.4로 기본 95.8보다 낮다. Gaokao는 기본과 같은 42.9다. 전체 평균이 올랐다는 결과를 “모든 수학 평가에서 1–3점 향상”으로 바꾸면 표와 맞지 않는다.
원문 7.2.2절은 Synthetic-1의 두 epoch 결과를 설명하면서 평균이 기본과 비슷한 46.6이라고 적는다. 표에서 46.6은 한 epoch이고 두 epoch는 54.0이다. 이 글은 표 5의 값을 기준으로 해석했다. 또한 생성 모델, 씨앗, 검증기, 풀이 생성의 결합을 비교한 것이므로 MathQ-Verify 하나가 성능 차이의 원인이라고 단정하지 않는다. 각 요소를 하나씩 뺀 대조 실험은 제시되지 않는다.
9. Code data benchmark: 1K·5K·10K와 model size 비교
7B와 14B 모델을 나눈 뒤, 각 모델 안에서 1K·5K·10K 조건을 비교한다.
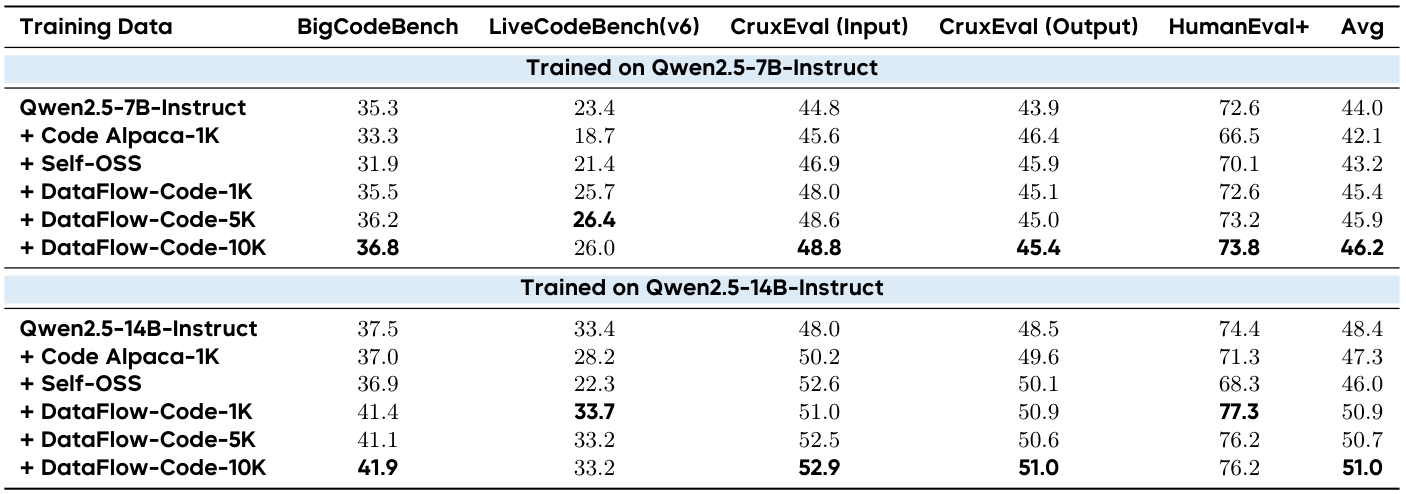
같은 1K 데이터로 Qwen2.5-7B를 fine-tuning한 행에서 평균은 Code Alpaca 42.1, Self-OSS 43.2, DataFlow 45.4다. DataFlow가 각각 3.3점과 2.2점 높다. DataFlow의 7B 평균은 1K→5K→10K에서 45.4→45.9→46.2로 오르지만, 14B에서는 50.9→50.7→51.0으로 단조롭지 않다. 아래에서는 이 데이터 크기 효과를 model별로 나누어 설명한다.
모델 크기와 데이터 수가 동시에 다른 행의 차이를 데이터 생성 방식 하나의 효과로 해석하면 안 된다.
9.1 Code data 1K 조건끼리 비교하기
코드 실험은 Ling-Coder-SFT에서 뽑은 2만 개를 씨앗으로 처리하고, DataFlow-Code 1K·5K·10K를 만든다. 비교 대상인 Code Alpaca와 Self-OSS 계열 데이터는 각각 1K 부분집합이다. 같은 크기로 비교할 수 있는 첫 질문은 DataFlow 1K가 다른 1K보다 나은가다. 학습은 Qwen2.5의 7B·14B Instruct 모델에 대한 전체 parameter fine-tuning이다.
평가는 BigCodeBench, LiveCodeBench v6, CruxEval, HumanEval+를 다룬다. 네 benchmark 계열이지만 CruxEval은 입력 reasoning과 출력 reasoning으로 나뉘므로 표의 점수 열은 다섯 개다. 평균을 읽을 때 CruxEval의 두 열이 각각 들어 있다는 점을 놓치면 안 된다.
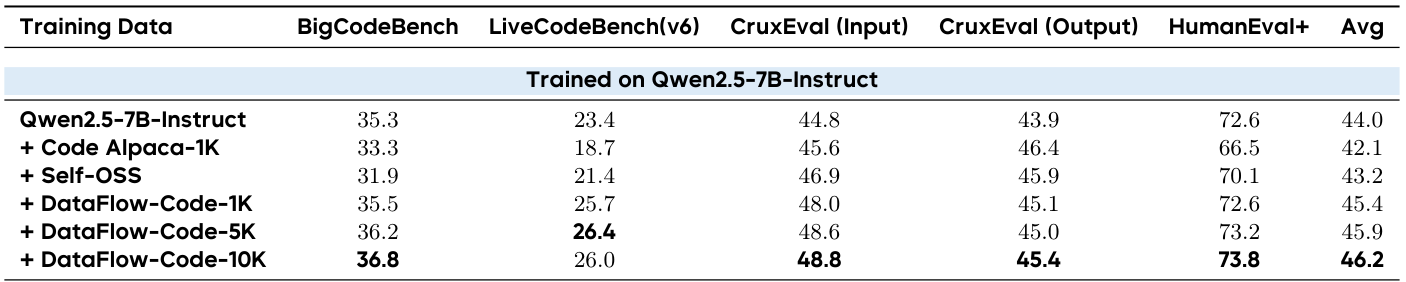
7B 기본 모델 평균은 44.0이다. Code Alpaca 1K는 42.1, Self-OSS 1K는 43.2로 오히려 낮아진다. DataFlow 1K는 45.4로 기본보다 1.4점, Alpaca보다 3.3점 높다. 3.3점을 Alpaca의 42.1로 나누면 약 7.8%의 상대 증가다. 이런 상대 증가와 정확도 7%포인트 증가는 다르다. 초록의 큰 백분율을 그대로 점수 차이로 옮기지 않는다.
7B DataFlow 1K에서는 BigCodeBench 35.5가 기본 35.3보다 약간 높고, LiveCodeBench 25.7은 23.4보다 높다. Crux 입력 48.0·출력 45.1도 기본 44.8·43.9보다 높다. HumanEval+는 72.6으로 기본과 같다. 개선 폭이 과제마다 다르다.
9.2 5K·10K code data의 task별 결과
7B DataFlow 평균은 1K 45.4, 5K 45.9, 10K 46.2로 오른다. 하지만 LiveCodeBench는 5K 26.4에서 10K 26.0으로 낮아진다. 10K의 BigCodeBench 36.8, Crux 입력 48.8, HumanEval+ 73.8은 각각의 기본 값보다 높다. “양을 늘리면 평균이 좋아진다”는 이 행들의 관측과 “모든 능력이 계속 좋아진다”는 주장은 구분해야 한다.
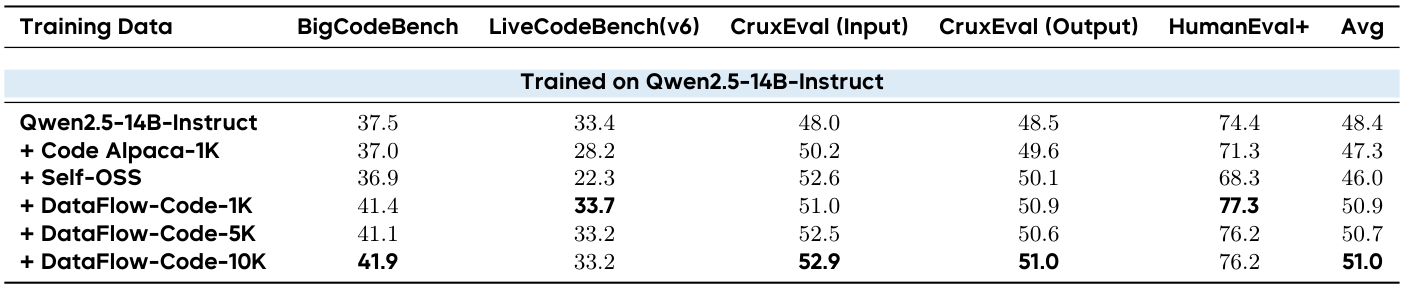
14B에서는 기본 평균 48.4, Alpaca 47.3, Self-OSS 46.0, DataFlow 1K 50.9다. 여기까지는 DataFlow 1K의 장점이 뚜렷하다. 그러나 5K에서는 50.7로 낮아지고 10K에서 51.0이 된다. 데이터 수에 따른 평균도 엄밀히 단조 증가하지 않는다.
세부적으로 14B DataFlow 1K의 LiveCodeBench는 33.7이지만 5K·10K는 33.2다. 기본 모델의 33.4보다도 조금 낮다. HumanEval+는 1K 77.3에서 5K·10K 76.2로 낮아진다. 반면 10K의 BigCodeBench 41.9와 Crux 입력 52.9·출력 51.0은 기본 37.5·48.0·48.5보다 높다. 같은 데이터 증가가 능력별로 다른 결과를 준다.
원문 설명에는 14B Code Alpaca의 LiveCodeBench가 21.9라고 나오지만 표는 28.2다. 또 DataFlow 10K와 비교 데이터 1K를 같은 규모라고 표현하는 대목도 표의 조건과 맞지 않는다. 이 글은 표의 모델·규모·수치를 기준으로 비교한다. 생성된 코드 예시가 왜 더 유용한지에 대한 설명은 가능하지만, framework를 제외한 모든 조건이 통제된 실험은 아니다.
10. Text-to-SQL benchmark: Qwen·Llama와 평가 split
10.1 SQL sample 수와 inference budget
DataFlow-Text2SQL-90K의 실제 예시는 89,544개다. Spider 학습 자료에서 37,517개, BIRD에서 37,536개, EHRSQL에서 14,491개를 만들어 합친다. 질문, SQL, 풀이 설명을 포함한다. 별도로 50K 부분집합을 만들고 SynSQL의 50K·90K 부분집합 및 250만 개 조건과 비교한다.
평가는 여섯 benchmark 계열의 일곱 분할이다. Spider가 dev·test 두 열로 나뉘고, BIRD-dev, EHRSQL, Spider-DK, Spider-Syn, Spider-Realistic이 뒤따른다. Gre는 temperature 0의 한 번 생성이고, Maj는 temperature 0.8로 여덟 후보를 만들고 실행 결과가 가장 자주 일치하는 후보를 고르는 방식이다. Maj가 높아져도 같은 inference 비용에서의 향상이라고 할 수는 없다.
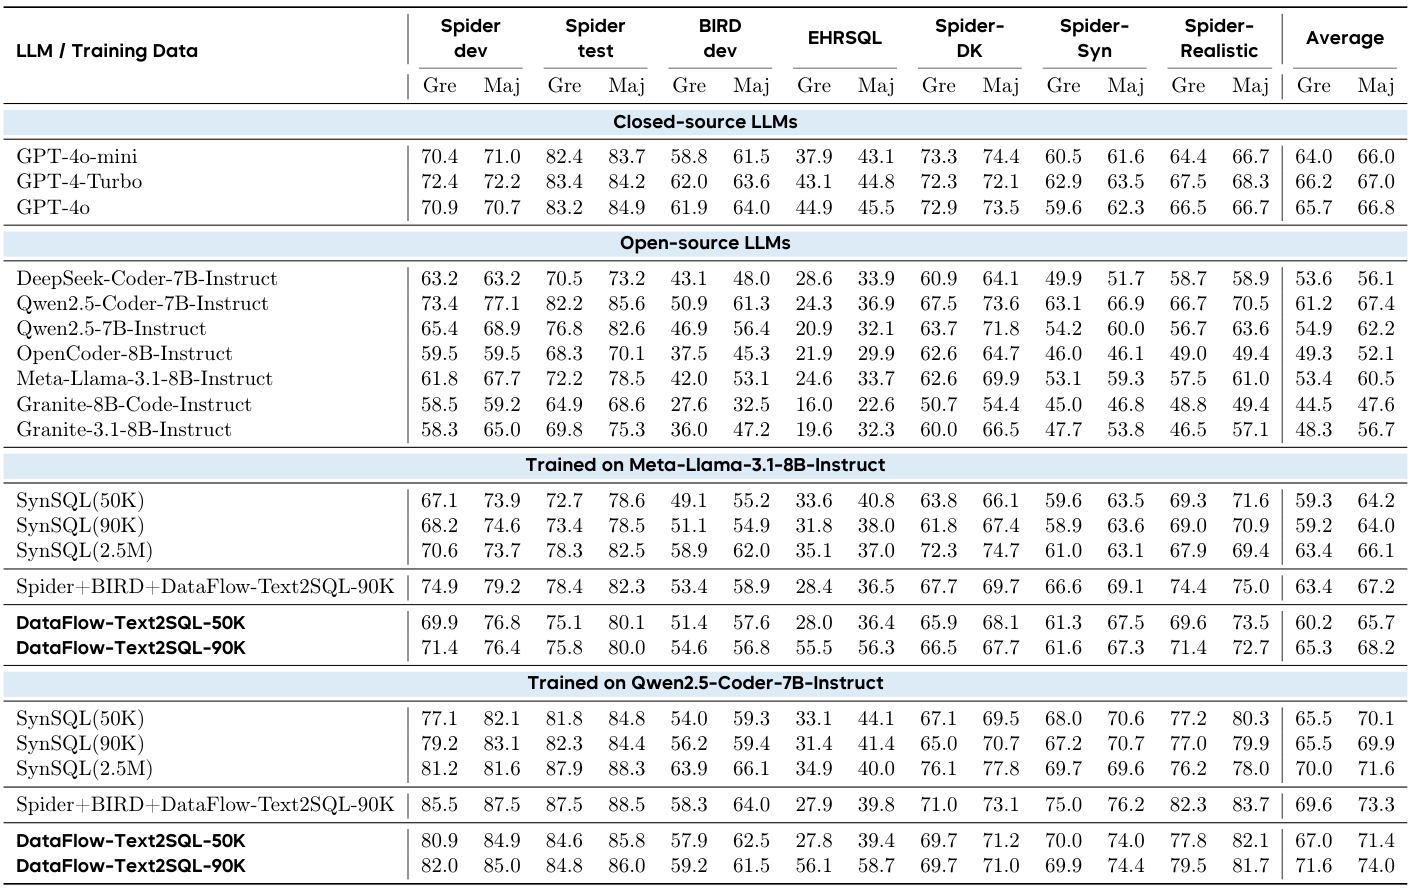
Greedy와 Majority voting은 답을 얻는 inference 방식부터 다르다. 먼저 아래 baseline 부분에서 모델과 decoding 조건을 맞춘 뒤 DataFlow 결과를 비교한다.
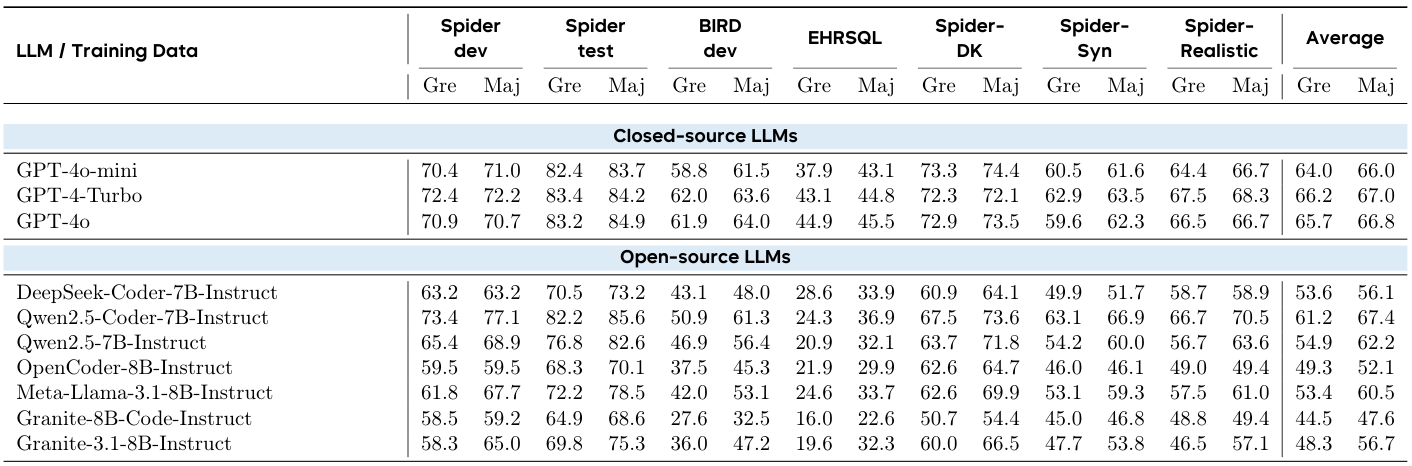
기본 Qwen2.5-Coder-7B-Instruct의 평균은 Gre 61.2, Maj 67.4다. 기본 Llama3.1-8B-Instruct는 53.4·60.5다. 같은 inference 전략에서도 출발점이 다르므로 두 모델의 최종 점수를 한 줄로 섞으면 안 된다. GPT-4 계열 등 다른 모델의 행은 결과의 위치를 보여 주지만, parameter·학습 데이터·호출 비용이 같은 대조군은 아니다.
10.2 Qwen SQL benchmark: EHRSQL과 평균
DataFlow 90K의 Qwen 평균은 71.6·74.0이다.
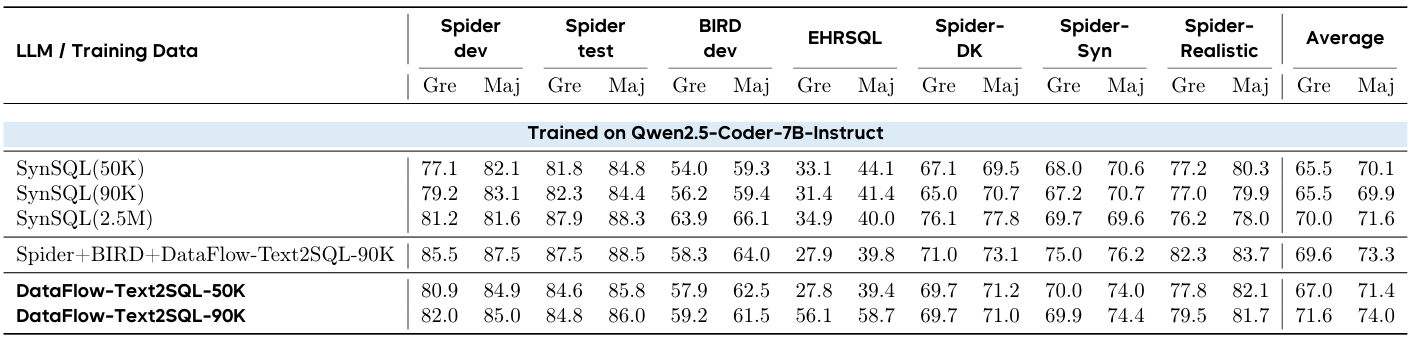
같은 90K SynSQL은 65.5·69.9이므로 각각 6.1점·4.1점 높다. 50K끼리는 DataFlow 67.0·71.4, SynSQL 65.5·70.1로 차이가 1.5점·1.3점이다. 데이터 수에 따라 우세의 크기도 달라진다.
기본 Qwen에서 DataFlow 90K로 바뀌었을 때 Gre를 분할별로 보면 Spider-dev 73.4→82.0, Spider-test 82.2→84.8, BIRD 50.9→59.2, EHRSQL 24.3→56.1이다. EHRSQL의 31.8점 향상이 특히 크다. 나머지 Spider-DK는 67.5→69.7, Syn은 63.1→69.9, Realistic은 66.7→79.5다. 이 조건에서는 일곱 Gre가 모두 기본보다 높다.
하지만 더 큰 SynSQL 2.5M과 비교하면 이야기가 달라진다. DataFlow 90K의 평균 71.6은 70.0보다 높아도 Spider-test는 84.8로 87.9보다 낮고, BIRD는 59.2로 63.9보다 낮다. Spider-DK도 69.7로 76.1보다 낮다. EHRSQL은 56.1로 34.9보다 높다. 따라서 적은 데이터의 평균 우세는 특히 강해진 영역과 약한 영역이 섞인 결과다.
Maj는 이 차이를 다시 바꾼다. DataFlow 90K의 BIRD는 61.5로 DataFlow 50K의 62.5보다 낮다. 90K가 50K보다 모든 분할에서 더 좋다는 규칙은 없다. 데이터의 구성과 후보 선택 과정이 함께 작용한다.
10.3 Llama SQL benchmark: 개선과 예외
Llama DataFlow 90K 평균은 Gre 65.3, Maj 68.2다.
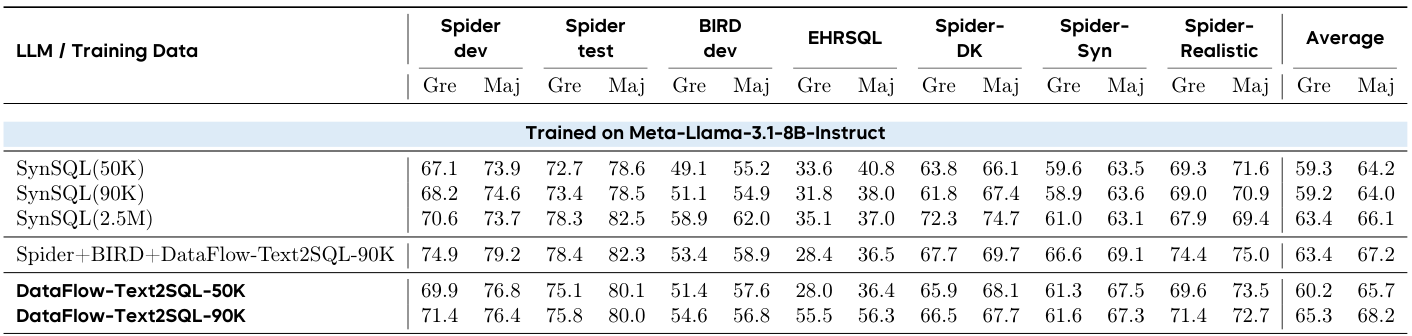
같은 90K SynSQL 59.2·64.0보다 각각 6.1점·4.2점 높다. DataFlow 50K는 60.2·65.7, SynSQL 50K는 59.3·64.2로 같은 규모에서 각각 0.9점·1.5점 차이다. 두 모델 모두 작은 규모의 공정한 비교에서 이득이 보이지만 이득의 크기는 일정하지 않다.
기본 Llama에서 DataFlow 90K로 바꾸면 Gre는 Spider-dev 61.8→71.4, test 72.2→75.8, BIRD 42.0→54.6, EHRSQL 24.6→55.5다. DK 62.6→66.5, Syn 53.1→61.6, Realistic 57.5→71.4도 오른다. 여기서도 EHRSQL 증가가 가장 크다.
SynSQL 2.5M의 Llama 평균 63.4·66.1보다 DataFlow 90K 평균은 높다. 그러나 SynSQL의 Spider-test Gre 78.3은 DataFlow 75.8보다 높고 BIRD 58.9도 54.6보다 높다. DK의 72.3도 DataFlow 66.5보다 높다. 일곱 분할 전체에 대한 우세로 단순화하면 안 된다.
10.4 Human data를 추가한 혼합 실험
표에는 Spider+BIRD+DataFlow 90K 조건도 있다. Qwen에서는 평균 69.6·73.3으로 DataFlow만 쓴 71.6·74.0보다 낮다. EHRSQL Gre가 56.1에서 27.9로 크게 낮아지는 반면 Spider-dev·test는 85.5·87.5로 높아진다. Llama 혼합 조건 역시 평균 63.4·67.2로 DataFlow만 쓴 65.3·68.2보다 낮다.
이를 “사람이 만든 데이터는 나쁘다”로 읽을 수는 없다. 전체 혼합 비율과 학습 분포가 바뀐 별도 조건이기 때문이다. 특정 데이터 출처를 늘리면 다른 영역의 성능이 달라질 수 있다는 증거로 읽는 것이 적절하다. 또한 SQL 생성, 실행 검사, 질문 생성, 풀이 생성 중 무엇이 어느 정도 기여했는지를 분리한 ablation은 이 표에 없다.
11. RAG 질문 생성: multi-hop QA와 OOD 평가
11.1 Multi-hop QA 질문을 만드는 과정
agent형 검색은 모델이 필요한 정보를 찾으며 여러 단계로 답하는 방식이다. 가상의 예로 “어떤 연구자가 졸업한 대학이 위치한 도시의 인구”를 묻는다면 사람→대학→도시를 연결해야 한다. 질문에 중간 답을 그대로 넣어 버리면 여러 단계 검색을 학습시키는 목적이 약해진다.
논문은 2018년 Wikipedia 문서에서 o4-mini로 다단계 질문을 만들고, 중간 질문 누출·논리 오류·지나치게 쉽거나 어려운 예시를 거른다. 평가 데이터에 나온 문서를 제외했다고 설명한다. 이는 저자의 오염 완화 절차이며 모든 의미 중복이나 pre-training 노출이 제거됐다는 독립 검증은 아니다.
최종 질문 10K로 Qwen2.5-7B-Instruct를 ReCall의 GRPO reinforcement learning 방식으로 학습한다. GRPO는 여러 후보의 상대적 reward를 이용하는 학습 방식이다. 여기서는 그 algorithm을 새로 제안한 것이 아니라 생성 데이터의 활용 수단으로 사용한다. 검색기는 E5-base-v2이고 문서 전처리·embedding은 FlashRAG를 사용한다. 평가 temperature는 0이며 검색 개수는 모델이 정하도록 하고 기본값 5를 둔다.
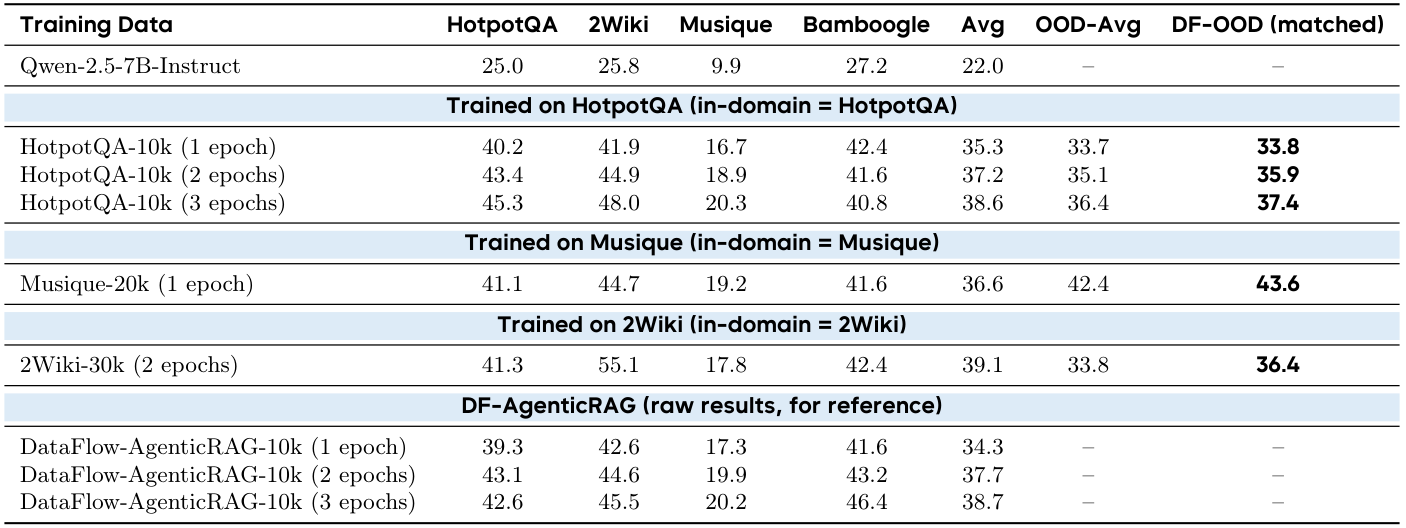
학습 task를 동일하게 제외한 OOD 비교에서 DataFlow는 HotpotQA 기준 0.1–1.0점, Musique 기준 1.2점, 2Wiki 기준 2.6점 높은 보고값을 보인다. 합성 multi-hop 질문도 출처 밖 task로 전이되는 학습 신호가 될 수 있다는 결과다. 아래의 matched 평균 계산은 비교하는 task 집합을 동일하게 맞추는 이유를 설명한다.
OOD 평균을 읽을 때는 원래 학습 대상 task가 평균에서 제외된다는 집계 범위를 확인해야 한다. 개별 행의 변화와 논문에 기재된 평균을 함께 보고, 둘이 맞지 않는 부분은 아래에서 구분한다.
11.2 OOD 평균에서 제외한 task 확인
OOD는 학습한 출처 밖의 데이터라는 뜻이다. HotpotQA로 학습한 모델의 OOD 평균에서는 HotpotQA를 뺀다. Musique로 학습한 모델에서는 Musique를 뺀다. 따라서 서로 다른 OOD 열 숫자를 그대로 순위표처럼 비교하면 평가 과제 자체가 달라진다.
논문은 오른쪽 DF-OOD (matched)에 DataFlow에서도 같은 과제를 뺀 평균을 둔다. 예를 들어 Musique를 제외한 DataFlow 두 epoch 평균은 HotpotQA 43.1, 2Wiki 44.6, Bamboogle 43.2를 평균한 약 43.6이다. Musique 학습 모델의 같은 세 과제 평균 42.4와 비교해야 한다. 이 계산을 독자가 재구성할 수 있도록 다음처럼 쓸 수 있다.
분자의 세 값은 Musique를 제외한 평가 점수이며 분모 3은 남은 과제 수다. 이것은 논문 표의 숫자를 이용한 해석용 산술이며 새 모델 실험이 아니다.
Hotpot 10K의 한·두·세 epoch OOD는 33.7·35.1·36.4이고, DataFlow의 같은 과제 제외 값은 33.8·35.9·37.4다. 차이는 각각 0.1·0.8·1.0점이다. Musique 기준은 42.4 대 43.6으로 1.2점, 2Wiki 기준은 33.8 대 36.4로 2.6점이다. 이 결과는 합성 질문으로도 출처 밖의 평가에서 경쟁력 있는 학습을 할 수 있음을 보여 준다.
11.3 Unique sample 수와 반복 학습 횟수
DataFlow 10K의 전체 평균은 표에 한 epoch 34.3, 두 epoch 37.7, 세 epoch 38.7로 적혀 있다. 다만 한 epoch의 네 점수 39.3·42.6·17.3·41.6을 단순 평균하면 35.2다. 인쇄된 34.3과 일치하지 않고 별도 weight가 설명되지 않아, 이 행의 전체 평균은 원문 보고값으로만 남긴다. 기본 모델의 인쇄 평균은 22.0이다. 각 과제의 개선 방향은 원래 네 열에서 확인할 수 있다.
학습을 더 한다고 모든 과제가 계속 좋아지는 것도 아니다. HotpotQA 점수는 두 epoch 43.1에서 세 epoch 42.6으로 떨어진다. 2Wiki로 학습한 모델의 해당 과제 점수 55.1은 DataFlow 세 epoch의 45.5보다 높다. OOD 경쟁력이 학습 영역 안에서도 항상 최고라는 뜻은 아니다.
계산 예산 비교에도 주의가 필요하다. Musique 20K를 한 번 본 것과 DataFlow 10K를 두 번 본 것은 예시 노출 수가 대략 20K로 같아도 고유 문제 수가 다르다. 더구나 표의 2Wiki-30K (2 epochs)는 표기대로라면 60K 노출이다. 이를 DataFlow 10K 세 epoch의 30K 노출과 같은 유효 학습 규모로 해석할 수 없다. 원문 설명과 표기의 이 차이는 미해결 조건으로 남겨야 한다.
12. Knowledge extraction: 문서 기반 QA 데이터 학습
12.1 Document parsing에서 QA generation까지
문서 기반 학습 데이터를 만들 때는 줄바꿈과 표를 읽는 단계부터 품질이 달라진다. 이 pipeline은 MinerU로 문서를 normalize하고 긴 내용을 나눈 뒤 잡음을 거른다. 각 조각에서 사실에 근거한 질문·답을 만들고 자동 품질 검사를 적용한다. 검색용 자료를 그대로 넣는 대신 학습할 예시로 바꾸는 구성이다.
실험의 원자료는 의료 분야 1억 4,000만 token이다. 18권의 교재, StatPearls 문서 9,330개, 16개 제공처의 지침 문서 45,679개에서 가져온다. Qwen2.5-7B-Instruct를 생성 데이터로 다섯 epoch, 37,500 step fine-tuning한다. 최종 질문·답의 정확한 개수와 모든 학습 설정은 본문만으로는 완전히 복원되지 않는다.
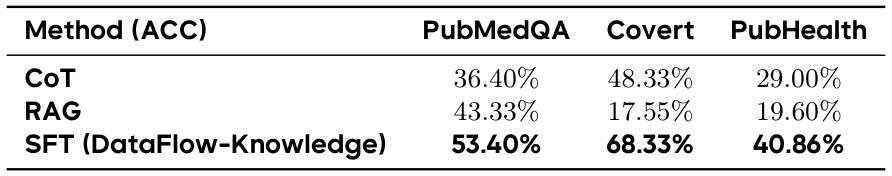
Qwen2.5-7B-Instruct에 DataFlow의 의료 QA 데이터로 추가 SFT를 하면 PubMedQA·Covert·PubHealth 점수가 53.40·68.33·40.86이다. 같은 표의 CoT 조건 36.40·48.33·29.00보다 각각 17.00·20.00·11.86점 높다. 이 결과는 문서에서 QA 학습 예시를 구성하는 pipeline의 downstream 활용을 보여준다.
추가 SFT와 CoT·RAG는 학습 및 inference 비용이 다른 방식이다. 이 표는 보고된 점수를 비교하지만 같은 총예산에서 어느 방식이 우수한지를 직접 증명하지는 않는다.
12.2 Knowledge benchmark와 model·data 조건
기본 모델에 풀이를 요청하는 CoT 조건은 PubMedQA 36.40, Covert 48.33, PubHealth 29.00이다. 검색을 붙인 RAG는 각각 43.33, 17.55, 19.60이다. DataFlow 데이터로 fine-tuning한 모델은 53.40, 68.33, 40.86으로 세 열 모두 높다.
CoT 대비 증가폭은 17.00·20.00·11.86점이다. RAG 대비는 10.07·50.78·21.26점이다. 특히 RAG가 Covert와 PubHealth에서 CoT보다 낮다는 점이 눈에 띈다. 사용한 검색기는 medcpt-query-encoder와 medcpt-article-encoder, 검색 문서 수는 10이다. 이 검색 구성의 결과를 모든 RAG의 한계로 다른 조건에도 그대로 적용할 수는 없다. 검색 문서의 적합성, 질문 형식, prompt에 따라 결과가 달라질 수 있다.
추가 학습은 비용과 목적이 다른 개입이다. 같은 의료 자료를 다른 방식으로 가공한 SFT 대조군이나 원자료 그대로 학습한 대조군이 없으므로, 성능 증가 중 얼마가 DataFlow의 정제 덕분이고 얼마가 도메인 추가 학습 덕분인지 분리되지 않는다. 여기서 검증된 것은 특정 공개 QA·분류 평가의 정확도이며 실제 임상 판단의 신뢰성을 측정한 결과는 아니다.
13. 통합 10K 데이터 benchmark: 수학·코드·지식의 개선과 예외
13.1 Math 3K·code 2K·instruction 5K 구성
한 모델을 여러 용도로 쓸 때는 한 과제만 잘하는 데이터보다 혼합 데이터가 필요하다. DataFlow-Instruct-10K는 수학 3,000개, 코드 2,000개, 일반 지시 5,000개를 합친다. 이 실험의 수학 씨앗은 MATH다. 앞의 독립 수학 실험에서 쓴 NuminaMath와 다르다. 같은 “DataFlow 수학 데이터”라는 말로 두 설정을 합치면 안 된다.
코드는 Ling-Coder 계열의 씨앗에서 준비하고, 일반 지시는 Condor 생성·수정과 SFT 품질 필터를 거친다. Qwen2-7B-Base와 Qwen2.5-7B-Base를 전체 parameter fine-tuning하고 Infinity-Instruct의 10K·1M 부분집합 및 공식 Instruct 모델과 비교한다. 데이터 고유 개수의 차이는 분명하지만 생성 API 비용·씨앗 제작 비용·token 길이까지 동일한 것은 아니다.
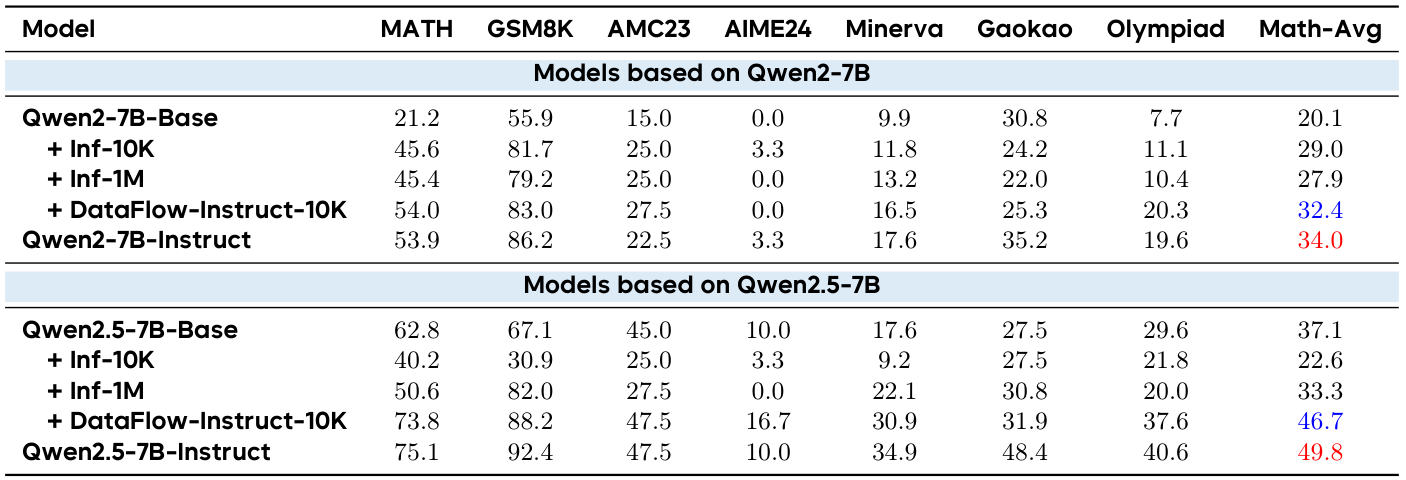
Qwen2.5-7B의 수학 평균은 DataFlow 10K에서 46.7로, 기본 37.1과 Infinity 1M의 33.3보다 높다. Qwen2-7B에서도 DataFlow 32.4가 기본 20.1과 Infinity 1M의 27.9보다 높다. 두 base model에서 같은 방향의 평균 개선을 보였다는 것이 이 통합 데이터 실험의 대표 claim이다.
두 Qwen 계열은 baseline 점수가 서로 다르다. 각 모델 안에서 DataFlow 적용 전후를 비교해야 하며, 다른 모델의 높은 점수를 그대로 데이터 효과로 계산하면 안 된다.
13.2 Qwen2.5의 math benchmark 변화
Qwen2.5 기본 수학 평균은 37.1이다.
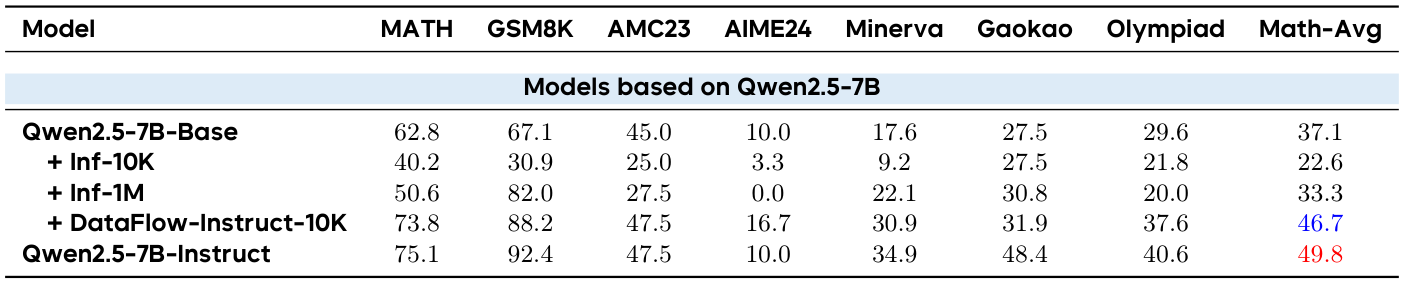
Infinity 10K는 22.6으로 낮아지고 Infinity 1M은 33.3이다. DataFlow 10K는 46.7로 기본보다 9.6점, Infinity 1M보다 13.4점 높다. 공식 Instruct 49.8에는 3.1점 못 미친다. 이 조건은 소량의 목표 지향 데이터가 무조건 많은 일반 예시보다 유용할 수 있음을 잘 보여 준다.
세부적으로 기본에서 DataFlow로 MATH 62.8→73.8, GSM8K 67.1→88.2, AMC23 45.0→47.5, AIME24 10.0→16.7, Minerva 17.6→30.9, Gaokao 27.5→31.9, Olympiad 29.6→37.6이 된다. 일곱 열이 모두 기본보다 높다. 다만 공식 Instruct와는 AIME24에서 높고 AMC23에서 같으며 나머지 다섯 열은 낮다. 따라서 “공식 지시 모델을 전부 대체한다”는 결론은 아니다.
13.3 Qwen2의 math benchmark 변화
Qwen2 기본 평균은 20.1, Infinity 10K는 29.0, Infinity 1M은 27.9, DataFlow는 32.4, 공식 Instruct는 34.0이다.
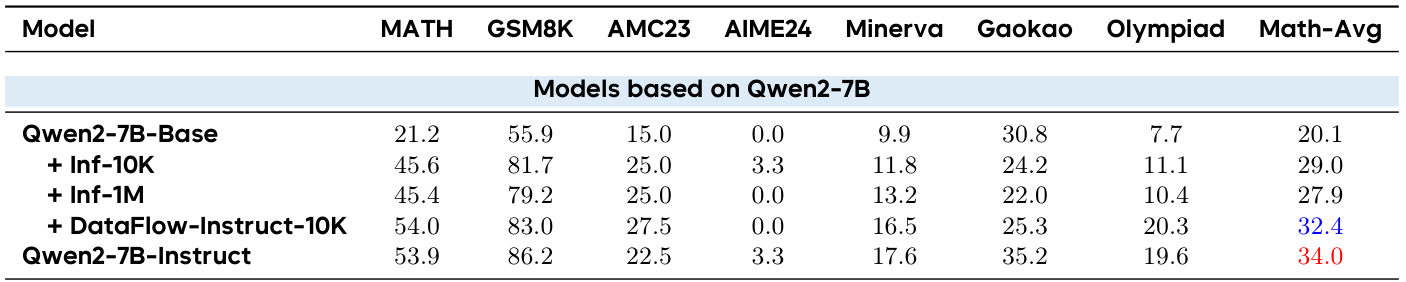
DataFlow가 비교 fine-tuning 모델 가운데 높은 평균을 보이는 방향은 같다. 그러나 Qwen2.5와 달리 Infinity 10K도 기본보다 좋아진다. 같은 데이터의 효과가 시작 모델에 따라 달라지는 것이다.
DataFlow의 Qwen2 MATH는 54.0, GSM8K는 83.0, AMC23은 27.5로 기본 21.2·55.9·15.0보다 높다. Minerva도 9.9→16.5, Olympiad는 7.7→20.3이다. 하지만 Gaokao는 30.8에서 25.3으로 낮아지고 AIME24는 0.0으로 같다. 평균 개선을 모든 문제 유형의 향상으로 다시 확대해서 설명하지 않는다.
13.4 Code·knowledge benchmark의 예외
같은 통합 학습 데이터가 code·knowledge benchmark에도 도움이 되는지 살피는 표다.
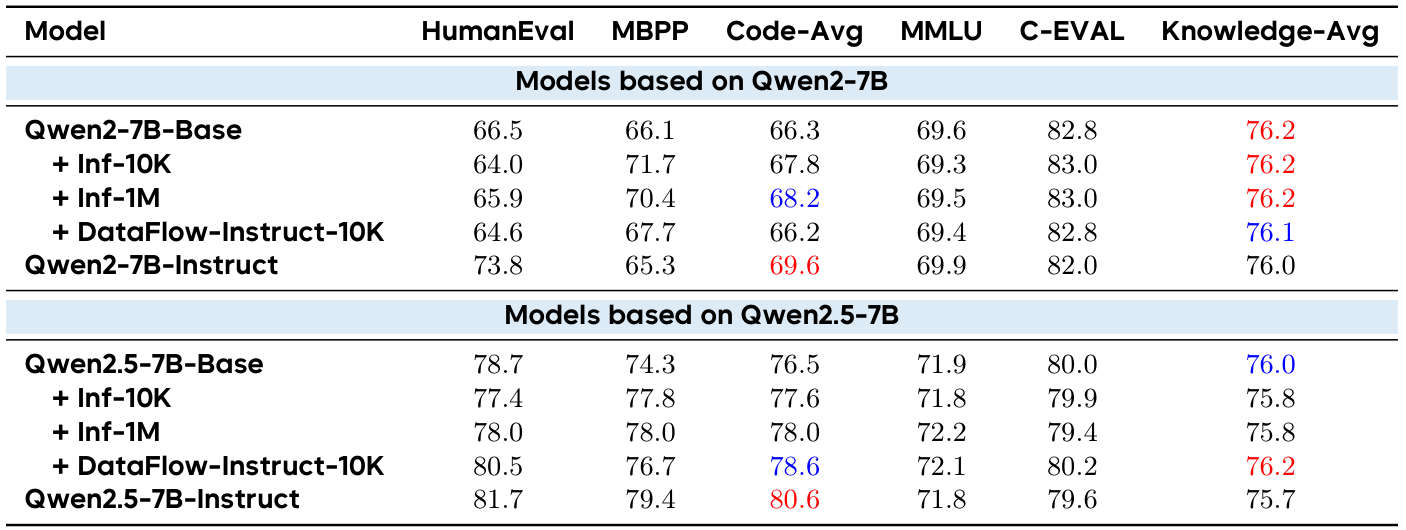
통합 데이터의 효과는 model과 능력에 따라 갈린다. Qwen2.5의 code 평균은 기본 76.5에서 DataFlow 78.6으로 높아지지만, Qwen2는 66.3에서 66.2로 거의 유지된다. knowledge 평균도 각각 76.0→76.2와 76.2→76.1이다. 따라서 앞의 큰 수학 개선을 code·knowledge 전체의 개선으로 확대할 수 없다.
모든 영역이 함께 좋아지는 결과는 아니므로 이어지는 model별 비교에서 개선과 하락을 모두 읽는다.
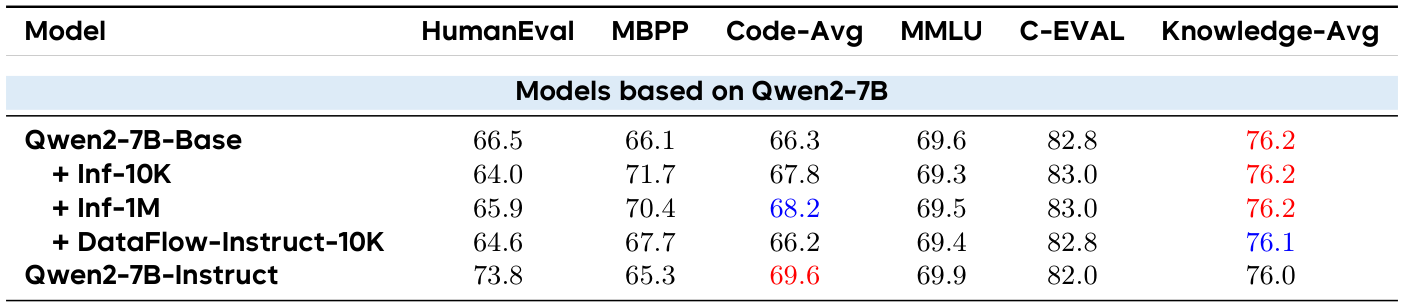
Qwen2의 코드 평균은 기본 66.3, Infinity 10K 67.8, Infinity 1M 68.2, DataFlow 66.2다. DataFlow가 기본보다도 0.1점 낮고 Infinity 1M보다 2.0점 낮다. HumanEval은 기본 66.5에서 64.6으로 낮아지며, MBPP는 66.1에서 67.7로 오른다. 두 능력의 방향이 갈린다.
지식 평균도 Qwen2에서는 기본·Infinity 두 조건이 76.2, DataFlow가 76.1이다. MMLU는 69.6에서 69.4로 조금 낮아지고 C-EVAL은 82.8로 같다. 원문 7.7.2절의 “코드에서도 Infinity 기준을 맞추거나 넘는다”는 설명은 이 Qwen2 행들과 맞지 않는다. 데이터 양을 100분의 1로 줄여 모든 능력에서 이겼다는 주장은 이 표로 뒷받침되지 않는다.
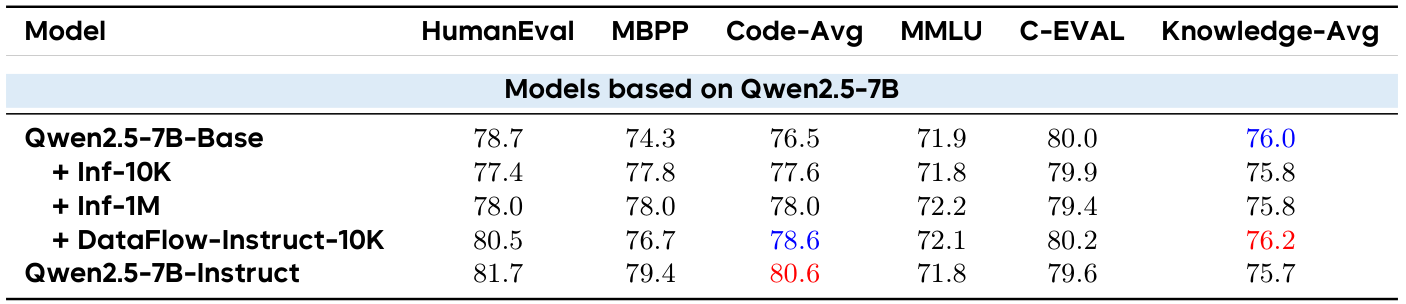
Qwen2.5에서는 코드 평균이 기본 76.5, Infinity 10K 77.6, Infinity 1M 78.0, DataFlow 78.6이다. DataFlow가 이들보다 높지만 공식 Instruct 80.6보다 2.0점 낮다. HumanEval은 80.5로 Infinity 1M 78.0보다 높지만 MBPP는 76.7로 Infinity 1M 78.0보다 낮다. 평균의 우세 안에도 교환 관계가 있다.
지식 평균은 DataFlow 76.2로 기본 76.0, Infinity 두 조건 75.8보다 조금 높다. MMLU 72.1은 Infinity 1M 72.2보다 약간 낮고 C-EVAL 80.2는 79.4보다 높다. 이 정도 차이는 반복 측정이 없는 상태에서 강한 보편 법칙으로 읽기 어렵다.
이 통합 실험이 주는 가장 유용한 교훈은 데이터의 양만으로 결과를 예측하기 어렵다는 것이다. 모델, 목표 과제, 데이터 혼합을 함께 평가해야 한다. 동시에 한쪽 수학 평균의 큰 개선을 다른 모델의 코드 결과까지 대표하는 제목으로 쓰면 중요한 정보가 사라진다.
14. DataFlow-Agent 평가: pipeline 구성 정확도
14.1 Pipeline generation을 평가한 18개 요청
논문은 대표 pipeline 여섯 개마다 쉬움·중간·어려움 세 수준의 설명을 사람이 만든다. 총 18개 요청이다. 쉬운 설명은 필요한 operator 기능과 주요 단계를 직접 알려 준다. 중간은 목표와 제약만 주고, 어려운 설명은 높은 수준의 최종 목표만 준다. 예를 들어 “질문을 만들고 중복을 지워라”와 “학습에 좋은 데이터를 만들어라”는 시스템에 남기는 reasoning 부담이 다르다.
생성한 pipeline은 외부 LLM 평가자가 두 방식으로 채점한다. 하나는 자연어 요구를 만족하는 구조인지 보는 텍스트 명세 평가다. 다른 하나는 기준 Python 구현과 operator 사용·순서가 논리적으로 맞는지 보는 코드 기준 평가다. 점수는 0–1 범위의 LLM 판정값이다.
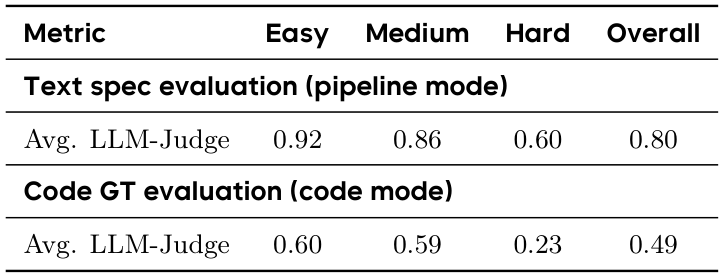
요청이 easy에서 hard로 바뀔 때 text-based score는 0.92→0.60, code-based score는 0.60→0.23으로 낮아진다. 구체적인 operator 요구가 사라질수록 기준 workflow를 구성하는 난도가 높아진다는 경향이다. DataFlow-Agent의 자동 조립 가능성과 남아 있는 planning 문제를 동시에 보여준다.
여기서 LLM이 매긴 점수는 pipeline의 실제 실행 성공률과 다르다. 항목별 점수와 평균의 계산 범위도 구분해야 한다.
14.2 요청의 구체성이 pipeline 구성 점수에 미치는 영향
텍스트 명세 기준은 쉬움 0.92, 중간 0.86, 어려움 0.60이며 인쇄된 전체 점수는 0.80이다. 코드 기준은 0.60, 0.59, 0.23이고 인쇄된 전체 점수는 0.49다. 요청이 추상적일수록 기준 구현과 일치하는 흐름을 찾기가 훨씬 어려워진다. 사용자가 operator와 처리 기준을 구체적으로 알려 주는 것이 여전히 큰 차이를 만든다는 결과다.
전체 점수에는 추가 확인이 필요하다. 인쇄된 난도별 점수의 단순 평균은 텍스트 약 0.793, 코드 약 0.473이다. 특히 코드의 0.49는 소수 둘째 자리의 일반적인 반올림만으로 맞지 않는다. 원문이 별도 weight나 원시 점수를 제공하지 않아 여기서는 0.49를 재계산해 검증한 전체 평균으로 사용하지 않는다. 난도별 감소 방향과 어려운 요청의 0.23이라는 관측을 중심으로 해석한다.
0.49를 “업무의 49%를 성공했다”로 읽을 수는 없다. 평가자가 operator 범위와 순서의 일치를 판정한 평균이지, 모든 예시를 실행해 정답률을 센 값이 아니기 때문이다. 반대로 기준 코드와 다른 유효한 처리 순서를 택한 경우도 점수가 낮아질 수 있다. 저자도 대체 가능한 구성이 단일 기준 구현과 달라지는 문제를 언급한다.
18개 요청은 작은 평가 집합이며 본문에는 판정 모델·prompt·반복 횟수·분산이 충분히 제시되지 않는다. 따라서 “자연어 한 줄로 어떤 데이터 작업이든 자동 완성”을 입증한 실험으로 볼 수 없다. 확인되는 것은 요구가 자세할수록 점수가 높고, 엄격한 코드 기준과 어려운 설명에서는 큰 격차가 남는다는 사실이다.
15. DataFlow storage와 operator: 입력·출력 key 연결
15.1 Operator의 read·transform·write
질문과 답이 들어 있는 한 행을 생각해 보자.
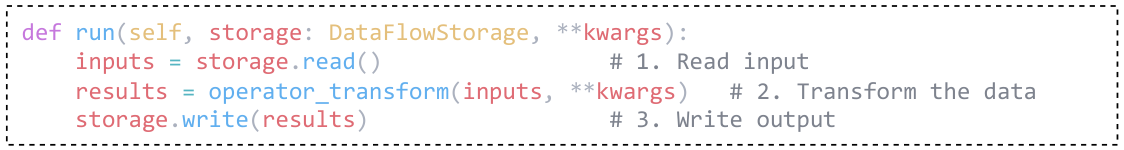
평가 operator는 그 행을 읽고 점수를 계산한 뒤 quality_score 같은 열을 추가한다. 다음 필터는 그 점수가 기준보다 낮은 행을 제외한다. 각 단계가 같은 저장소 인터페이스를 통해 읽고 쓰면 중간 결과를 확인할 위치가 분명해진다.
논문의 기본 구현은 pandas의 표 형태 데이터를 사용하고 JSON·JSONL·CSV·Parquet 같은 형식을 다룬다. 원자료가 PDF라는 사실과 모든 operator가 PDF 바이너리를 직접 받는다는 말은 다르다. 문서 파싱처럼 앞단의 변환을 거쳐 operator가 사용할 내용이 준비되어야 한다.
여기서 “저장소를 추상화했다”는 것은 저장 방법을 바꿀 접점을 마련했다는 뜻이다. 그 자체가 메모리를 넘는 모든 규모를 자동 처리하거나 분산 저장소에서 같은 성능을 낸다는 측정 결과는 아니다. 파일 저장과 처리 중간 상태를 어떻게 유지하는지는 코드와 실제 작업 크기에 따라 확인해야 한다.
15.2 Input·output key로 column 이름 연결하기
한 팀은 질문 열을 question, 다른 팀은 prompt라고 부를 수 있다.
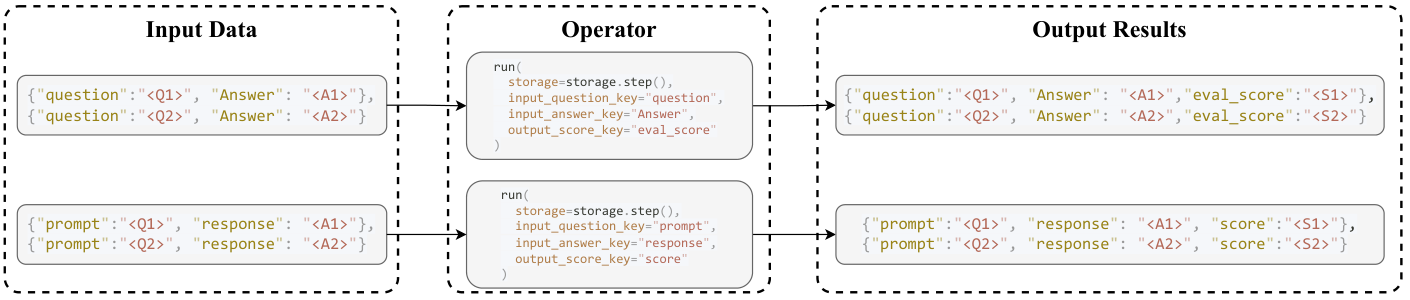
operator 내부에 특정 열 이름을 고정하면 두 번째 팀은 데이터를 미리 변환하거나 코드를 고쳐야 한다. 그림 3은 입력 키를 인자로 받아 같은 처리 논리를 서로 다른 표에 연결한다.
중요한 것은 이름의 대응뿐 아니라 의미다. input_answer_key에 질문 열을 잘못 넣어도 문자열 형태라는 이유만으로 통과할 수 있다. 키가 존재하는지 검사하는 것과 그 열이 정말 정답을 담았는지 확인하는 것은 다른 검증이다. API의 구조 검사가 의미 정확성까지 보장한다고 읽으면 안 된다.
15.3 Model serving과 prompt template 분리
논문은 generate_from_input을 공통 모델 호출 진입점으로 설명한다. operator가 만든 여러 입력 문장과 선택적인 시스템 지시, 출력 구조 요구를 모델 호출 계층에 넘긴다. 이 계층 뒤에는 로컬 inference engine이나 외부 API가 올 수 있다. operator마다 재시도·병렬 호출 처리를 다시 작성하지 않게 하려는 설계다.
prompt 템플릿은 문제 지문이나 데이터베이스 구조를 넣어 실제 지시문을 만드는 역할이다. SQL 생성 논리를 유지한 채 SQLite용 문법 안내를 다른 데이터베이스용 안내로 바꾸는 것이 예다. 다만 출력 구조를 JSON으로 제한해도 JSON 안의 답이 맞는지는 별도 문제다. 같은 인터페이스, 같은 키, 같은 JSON 형식은 품질 검사의 출발점이다.
16. Pipeline 실행: initialization·run·compile의 역할
코드는 operator를 준비하는 부분과 데이터를 처리하는 forward 부분으로 나뉜다.
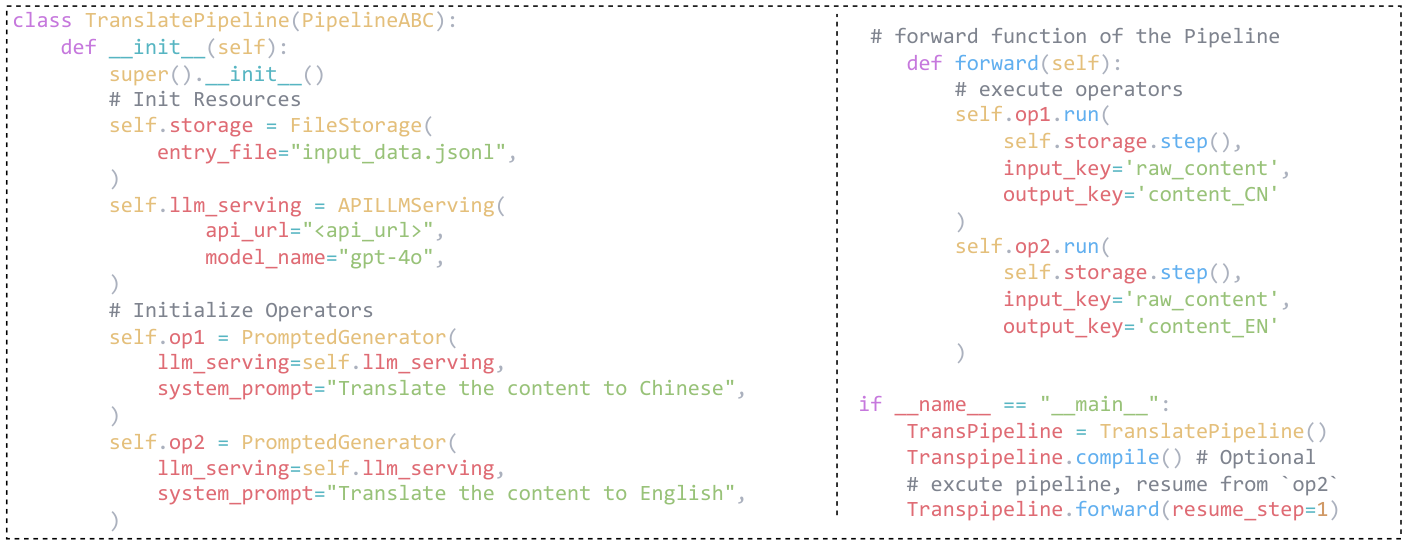
이 예시는 같은 storage 객체에서 operator가 필요한 column을 읽고 결과 column을 추가하는 흐름을 보여준다. 그래서 데이터의 저장 형식과 각 변환의 구현을 분리하면서 중간 결과를 점검할 수 있다. 그림의 역할은 성능 입증이 아니라 공통 operator API가 pipeline 조립을 가능하게 하는 구조를 설명하는 것이다.
원문의 예시에는 실제 실행 전에 확인해야 할 표기 문제가 있으므로 그림을 그대로 복사해 실행 가능한 코드로 취급하지 않는다.
16.1 Operator initialization과 run의 차이
초기화에서는 어떤 파일을 읽고 어느 모델을 사용할지 정한다.
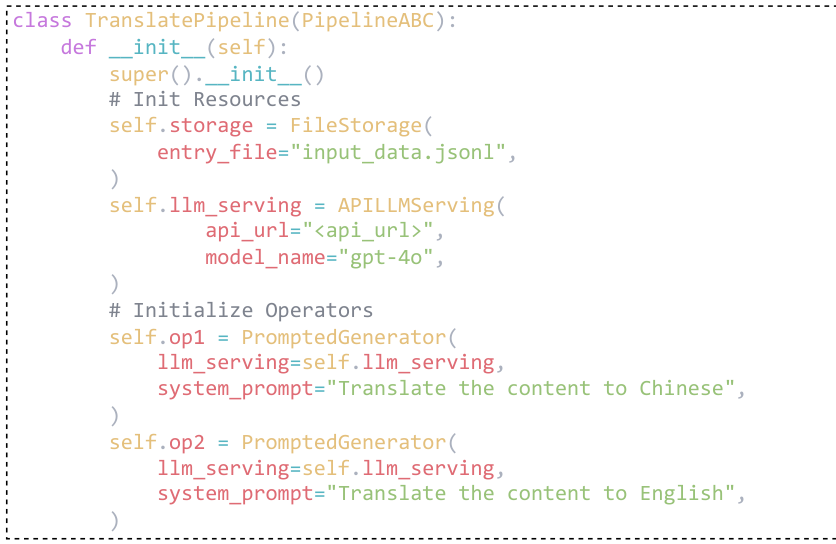
실행에서는 준비한 operator를 호출한다. 모델을 만드는 일과 그 모델로 입력을 처리하는 일을 나누는 방식과 비슷하다. 저장소·모델·prompt를 한 번 구성해 여러 단계에서 공유할 수 있다.
이 원문 예시는 중국어 번역과 영어 번역을 각각 만든다. 두 operator는 모두 raw_content를 입력으로 읽는다. 따라서 그림 그대로는 중국어 번역 결과를 다시 영어로 번역하는 연쇄 작업이 아니다. 한 원문에서 두 결과 열을 만드는 구조다. 실행 코드의 줄 순서와 실제 데이터 의존성을 구분해야 한다.
16.2 Pipeline compile의 구조 검사
논문은 compile()이 operator 연결을 분석하고 필요한 키, 타입, 의존 관계를 점검한다고 설명한다.
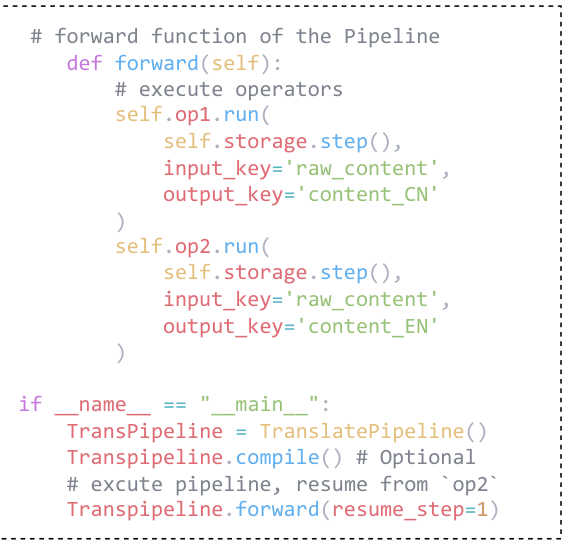
처리 단계를 꼭짓점, 데이터 연결을 화살표로 생각하면 방향성 비순환 그래프, 즉 DAG가 된다. 앞으로 진행하는 연결만 있는 작업 지도를 미리 만들면 “없는 열을 읽는 단계” 같은 구조적 문제를 실제 모델 호출 전에 찾을 여지가 생긴다.
그림에는 실행 재개를 뜻하는 resume_step=1도 있다. 비싼 생성 작업이 끝난 뒤 저장 단계에서 실패했다면 처음부터 생성하지 않고 다음 단계부터 시작하고 싶은 것이다. 재개가 올바르려면 이전 단계의 결과와 설정이 맞게 남아 있어야 한다. 숫자 하나를 넘기는 문법만으로 모든 중간 상태의 일관성이 해결되는 것은 아니다.
원문의 TransPipeline과 Transpipeline은 서로 다른 Python 이름이다. FileStorage의 인자도 확인한 코드에서는 entry_file이 아니라 first_entry_file_name이다. 한편 그림의 forward(self)에 resume_step이 없다는 점은 코드 확인 뒤 더 정확히 설명할 수 있다. compile()이 호출되면 forward를 그 인자를 받는 내부 실행 함수로 바꾸므로, 컴파일 후에는 재개 인자가 가능하다. 컴파일을 생략한 원래 함수에는 그대로 적용되지 않는다. 따라서 그림의 오탈자와 실제로 지원되는 기능을 구별해야 한다.
17. DataFlow 코드: compile·response parsing·SQL 검증
17.1 검토한 DataFlow commit과 code 범위
공개 저장소는 계속 바뀐다. 이 글은 2025년 12월 19일의 고정 코드를 읽었다. 논문 시점에 가까운 공개 구현을 확인하기 위한 선택이며 논문 실험이 반드시 이 커밋으로 실행됐다는 증거는 아니다. 설치·학습·외부 API 호출·생성 코드 실행은 하지 않았다. 아래는 파일을 읽어 확인한 구현과 그 동작에서 확인한 한계다.
저장소에는 모델과 데이터 처리 예시가 있지만 표 2–12를 한 번에 정확히 재생성하는 고정 실험 묶음을 확인하지 못했다. 논문과 README의 결과 표가 같다는 사실은 재현에 필요한 모든 데이터 분할·checkpoint·생성 로그가 제공됐다는 뜻이 아니다. AIME의 @32 집계나 DataFlow 15K와 표의 5K 설명 차이도 코드에서 완전히 해소되지 않았다.
17.2 Compile의 operator 기록과 column 연결
PipelineABC의 compile 구현은 operator를 기록용 wrapper로 바꾸고 사용자가 작성한 forward()를 호출한다. 이때 AutoOP는 원래 operator를 실행하는 대신 인자를 맞춰 보고 호출 정보를 저장한다. 이후 원래 forward를 컴파일된 실행 함수로 교체한다.
이 방식은 실행 순서에 따른 operator 연결을 수집한다. 연결 정보 추출 코드는 input_·output_으로 시작하는 인자 중 문자열 값을 열 이름으로 취급한다. 앞서 존재하거나 생성된 키가 다음 입력에 있는지 검사한다. 문자열 열인지 숫자 열인지의 일반적인 타입 검증이나 질문·답의 의미 대응까지 확인하는 코드는 이 부분에서 보이지 않는다.
또 사용자 forward() 자체는 호출되고 최초 저장소의 키를 읽는다. 따라서 컴파일을 모든 부수 효과가 제거된 순수한 정적 분석이라고 표현하면 부정확하다. 제공된 operator 호출을 기록하는 흐름과 사용자가 함수 안에 추가한 다른 작업을 구별해야 한다.
컴파일된 실행 함수는 순서대로 노드를 실행하고 resume_step 이전 단계를 건너뛴다. FileStorage는 단계 번호에 따른 cache 파일을 사용한다. 재개 시 그 파일이 실제로 있고 이전 설정과 일치하는지 별도로 확인해야 한다. 이 코드를 범용 병렬 DAG optimizer의 성능 입증으로 해석하지 않는다.
17.3 Model response parsing과 filtering 조건
API 호출 구현은 여러 입력을 병렬 요청하고 재시도하며 원래 순서로 결과를 돌려놓는다. 재시도가 모두 실패하면 None이 남을 수 있다. 출력 타입 표기만 보고 항상 유효한 문자열이 온다고 가정하면 안 된다. 이런 실패가 다음 필터에서 제외되는지, 오류로 남는지에 따라 최종 데이터가 달라진다.
수학 질문 필터는 LLM 판정문에서 judgement_test를 읽고, 형식이 맞지 않으면 문자열 안의 true를 기준으로 해석하는 대체 경로가 있다. 이는 정형적인 수학 증명 검증기와 다르다. prompt의 판단 내용뿐 아니라 응답을 해석하는 규칙도 데이터 선별 품질의 일부다.
SQL 일치 필터 역시 모델 응답의 코드 블록에 yes가 있는지를 본다. 의미가 맞는지 모델에 묻는 절차와 그 답을 안정적으로 파싱하는 절차가 모두 필요하다. 이름에 consistency가 들어갔다고 형식과 의미 오류가 자동으로 사라지는 것은 아니다.
17.4 SQL execution·reasoning 검사의 경계
SQLExecutionFilter는 초기 질의 종류 검사로 모은 인덱스를 뒤의 실행 목록에 적용하지 않고 전체 행을 실행 대상으로 만든다. 확인한 버전에서 최종 선택은 실행 결과의 success에 의존한다. 따라서 함수 앞쪽의 검사 이름만 보고 전체 동작을 판단할 수 없다.
DatabaseManager의 일괄 실행은 묶음 대기 시간과 실행 결과를 처리한다. 개별 질의를 데이터베이스 수준에서 반드시 정해진 시간에 중단한다는 보장으로는 읽기 어렵다. 논문의 “실행 가능하고 제한 시간 안인 질의를 남긴다”는 설명을 재현하려면 해당 커넥터의 시간 제한 동작도 확인할 필요가 있다.
풀이 생성기의 정상 일괄 경로는 비교 결과의 equal 값을 읽는다. 하지만 오류 후의 개별 대체 경로는 비교 결과 딕셔너리 자체의 참·거짓을 검사한다. 내용에 equal: false가 있어도 비어 있지 않은 딕셔너리는 Python에서 참이므로 같은 검증이라고 볼 수 없다. 이 차이가 논문의 점수에 영향을 주었는지는 실행 기록이 없어 알 수 없다.
결과 비교 함수 자체도 행 수와 열 이름을 확인하고 normalize한 행을 정렬해서 비교한다. 행 순서는 이 비교에서 유지되지 않고 None은 빈 문자열로 바뀐다. 따라서 여기서의 결과 일치는 특정 구현의 동치 기준이지 모든 SQL 의미를 엄밀히 증명한 결과가 아니다.
17.5 Code execution score와 agent 구현 범위
코드 데이터 예시 pipeline은 지시 확장, 코드 생성, 품질 평가, 점수 필터, 실행 평가를 연결한다. 예시에는 GPT-4o가 설정되어 있지만 이것만으로 논문 모든 코드 실험의 정확한 생성 모델과 설정을 확정할 수는 없다. 파일의 생성자에 전달한 모델 객체가 실제 사용되는지까지 확인해야 하는 이유도 있다.
실행 평가 operator는 코드가 종료됐는지에 따라 상태·로그 열을 붙인다. 이 함수 자체는 실패 행을 제거하지 않고, 별도의 문제별 정답 테스트를 입력받지도 않는다. 따라서 실행이 끝났다는 PASS를 모든 테스트를 통과한 정답으로 읽어서는 안 된다. 문서의 “sandbox”라는 이름만으로 완전한 실행 격리를 확인했다고 주장하지도 않는다.
한편 이 고정 저장소의 README에는 DataFlow-Agent 소개와 데모 링크가 있지만, 논문 그림 6의 아홉 역할을 구현한 LangGraph 전체 흐름은 확인하지 못했다. 저장소에서 StateGraph와 관련 의도·검증 구성요소를 찾은 범위에서도 구현 위치를 특정하지 못했다. 이는 해당 시점에 기능이 어디에도 없었다는 증명이 아니다. 이 글의 코드 확인 범위가 operator와 pipeline 코어까지라는 뜻이다. agent의 자동 수정·격리·18개 요청 평가를 직접 재현했다고 쓰지 않는다.
18. DataFlow의 한계와 pipeline 재현 순서
18.1 한 sample의 operator 입출력부터 재현하기
실제 재현을 준비한다면 한 번에 모든 데이터 분야를 돌리는 것보다 질문 하나가 어떻게 바뀌는지 추적할 수 있는 작은 실험이 필요하다. 예를 들어 원문 조각, 생성 질문, 답, 평가 점수, 제외 이유를 같은 식별자로 연결한다. 이렇게 해야 점수가 올랐을 때 어떤 단계가 어떤 예시를 바꿨는지 살필 수 있다. 이는 이 리뷰의 제안이며 여기서 실행한 결과가 아니다.
그다음 같은 모델, 같은 학습 token·epoch, 같은 평가 설정을 두고 데이터 준비만 바꾼다. 원자료 선택 효과를 보려면 생성 모델을 고정하고, 검증 효과를 보려면 같은 생성 후보를 두고 검증기만 적용하거나 제외한다. 최종 개수가 달라질 경우 같은 수를 다시 표집한 비교와 자연스럽게 남은 수를 사용한 비교를 구분한다. 이렇게 해야 “더 좋은 데이터”와 “더 많은 학습”의 효과가 섞이지 않는다.
18.2 Component ablation과 data generation cost의 공백
원문에는 여러 출처·규모·모델·epoch를 바꾼 비교가 풍부하다. 하지만 생성기, 검증기, 수정기를 하나씩 제거한 대조 실험은 제시되지 않는다. 따라서 “좋은 결과가 나온 데이터 제작법의 묶음”은 확인되지만 어떤 구성 요소가 필수인지는 더 시험해야 한다.
또 최종 데이터 수가 적다는 사실은 제작 비용이 적다는 뜻과 다르다. 높은 성능의 모델로 많은 후보를 만들고 상당수를 버렸을 수 있다. 전체 생성 token, API 비용, 실패·재시도 수, 처리 시간, 최종 유효 예시당 비용이 없으면 1만 개와 100만 개의 경제성을 단순 비교하기 어렵다. Figure 5의 행 수 흐름도 이 비용을 대신하지 않는다.
여러 실험은 반복 횟수와 오차 막대를 제시하지 않는다. 작은 평균 차이는 설정을 조금 바꾸면 달라질 수 있다. 크게 개선된 영역에서도 평가 데이터와 씨앗의 관계, 생성 모델의 사전 지식, 교사 모델이 만든 답의 오류가 남는다. 자동 선별을 많이 거친다는 사실만으로 이런 문제가 제거됐다고 할 수는 없다.
18.3 Data pipeline의 중간 결과를 확인하는 방법
DataFlow의 설계에서 가져올 만한 점은 데이터 준비를 저장소·모델 호출·operator·prompt·연결 순서로 분리했다는 것이다. 같은 작업을 다시 구성하고, 한 요소를 바꾸고, 중간 결과를 비교할 접점을 만든다. 논문의 여러 영역 실험은 이런 공통 인터페이스로도 도메인별 제작 과정을 표현할 수 있음을 보여 준다.
성능에 관한 기억은 조건과 함께 남겨야 한다. Qwen2.5 수학의 통합 10K는 강했지만 Qwen2 코드는 그렇지 않았다. SQL 평균은 개선됐지만 모든 평가 분할에서 큰 dataset을 이긴 것은 아니다. 자동 pipeline 구성은 자세한 지시에서 더 잘했고 어려운 요청의 코드 기준 점수는 낮았다. 이 세 가지를 기억하면 framework의 가능성과 현재의 한계를 동시에 읽을 수 있다.
19. 출처
이 리뷰의 원문은 Hao Liang, Xiaochen Ma, Zhou Liu 등 연구진의 DataFlow: An LLM-Driven Framework for Unified Data Preparation and Workflow Automation in the Era of Data-Centric AI다. arXiv v1 정보와 36쪽 PDF를 기준으로 썼다. 부록 A는 저자 기여를 설명하며 별도의 추가 실험 표는 없다.
그림 1–7과 표 1–12는 원문에서 직접 발췌했다. 작은 글씨를 읽기 위한 확대본 중 표는 원문 열 제목과 특정 모델 블록을 흰 간격으로 결합했고 그 사실을 각각 표시했다. 숫자·열 제목·강조 색상은 수정하지 않았다. 원문 배포 조건은 CC BY 4.0이며 각 도판에 원문 페이지 링크와 원본 이미지 링크를 제공한다.
구현은 고정 커밋 df4f689, 최신 이용 안내는 공식 문서, 공개 데이터는 DataFlow-Instruct-10K에서 따로 확인할 수 있다. 최신 문서와 이후 기능을 이 v1 논문의 실험 조건과 섞지 않아야 한다. 본문의 점수는 저자 보고값이고 단순한 차이·비율 계산은 이 글의 해석이다. 실제 학습·inference·데이터 생성 결과를 새로 측정했다고 주장하지 않는다.
자료 확인·수정: 2026년 9월 16일. 검토한 원문과 공개 구현의 버전은 위에 고정했다. 이번 수정에서는 전문 용어, 설명 문장, 검색 주제가 드러나는 제목과 이미지 배치를 보완했다.
관련 글
Paper Review
A Defense of the Quadratic Model — LLM 학습의 Gauss–Newton 근사와 안정성 분석
A Defense of the Quadratic Model의 Gauss–Newton 근사, Lanczos spectrum과 학습 안정성을 설명한다. batch 64 예제, 원문 figure·table, 공개 코드로 근사가 맞는 조건과 반례를 분석한다.
Paper Review
IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System — voice cloning·병음 발음 제어 분석
IndexTTS v1의 SEQ3 입력, Conformer·Perceiver와 BigVGAN2 구조를 설명한다. 병음 교정률 94%의 분모, CER·WER·SS·MOS와 inference 속도를 원문 figure·table과 코드로 분석한다.
Paper Review
IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech — 감정·발화 길이 제어 원리 분석
IndexTTS2의 T2S·S2M, GRL 감정 분리, GPT latent와 duration control을 설명한다. WER·SS·MOS, ablation과 공개 inference 코드의 제한을 원문 figure·table로 분석한다.