A Defense of the Quadratic Model — LLM 학습의 Gauss–Newton 근사와 안정성 분석
A Defense of the Quadratic Model의 Gauss–Newton 근사, Lanczos spectrum과 학습 안정성을 설명한다. batch 64 예제, 원문 figure·table, 공개 코드로 근사가 맞는 조건과 반례를 분석한다.
- #논문 리뷰
- #Quadratic Model
- #LLM 학습
- #Gauss–Newton
- #Lanczos
- #learning rate
원문: Alexandru Meterez, Pranav Ajit Nair, Depen Morwani, Cengiz Pehlevan, Sham Kakade, Alex Damian, A Defense of the Quadratic Model. Harvard·Kempner Institute 및 MIT 연구진의 arXiv 사전 공개 논문이다. 이 글은 2026년 7월 23일 공개된 2607.21716v1, 전체 34쪽을 기준으로 한다. 확인한 자료에서 학회 채택 여부는 확정하지 않았다.
원본 그림·표·algorithm은 저자들의 PDF에서 잘라 사용했다. 출처는 각 그림에 표시했으며 원문 라이선스는 CC BY 4.0이다. 실험을 새로 실행해 얻은 성능이 아니라 논문의 보고 결과와 공개 코드의 관찰을 해설한다. 복잡한 원본 그림은 옆으로 이동하거나 ‘원본 크게 보기’로 읽을 수 있다.
1. Quadratic Model 요약: LLM 학습 후반의 loss를 어디까지 근사할 수 있나
이 논문은 LLM의 복잡한 학습 경로를 local quadratic model로 설명할 수 있다는 주장을 세 단계로 검증한다. 먼저 실제 loss 경로와 근사 경로가 얼마나 오래 맞는지 측정한다. 그다음 그 근사를 구성하는 curvature spectrum과 남은 오차를 분석하고, 마지막으로 batch size에 따른 stochastic stability를 확인한다.
첫 결과는 150M model을 3B token으로 학습한 조건에서 근사가 최대 전체 학습량의 10% 구간까지 실제 경로를 따라간다는 것이다. Table 1의 batch 64·90% checkpoint에서 quad의 유효 구간은 8.4%, 즉 252M token이다. 같은 batch의 80% checkpoint에서는 5.2%였다. 초기보다 후기 checkpoint에서 더 오래 맞는 경향이 핵심이며, 학습 전체가 하나의 quadratic function이라는 주장은 아니다.
두 번째 결과는 curvature tail과 남은 오차에 반복되는 구조가 있다는 것이다. Figure 3에서 eigenvalue 순위의 기준 높이를 맞추면 대략 ~ 구간의 tail이 가까워진다. 감소 지수는 Gauss–Newton에서 약 0.96, Hessian에서 약 0.65다. 또 source exponent는 β < 1로 추정되어 기존 이론에서 흔히 쓰는 summability assumption과 충돌한다. 따라서 큰 curvature 방향의 유사성만으로 두 행렬의 tail을 같다고 보거나, 실제 학습이 통상적인 source condition을 만족한다고 가정할 수 없다.
세 번째 결과는 small·medium batch에서는 noise가 지배하는 stochastic edge of stability, large batch에서는 deterministic edge of stability에 가깝게 학습한다는 것이다. Figure 6·7의 local stability probe는 같은 learning rate라도 batch를 줄이면 불안정해질 수 있고, 평균 제곱의 안정성과 개별 경로의 안정성이 구별됨을 보여준다. 따라서 이 글은 근사의 유효 구간 → 그 구간을 설명하는 spectrum/source condition → learning rate·batch의 안정성 순서로 읽는다. Constant learning rate와 일부 checkpoint의 예외는 각 claim을 설명한 뒤 함께 확인한다.
2. Quadratic approximation 배경: gradient·curvature·Hessian
2.1 Quadratic function에서 gradient와 curvature의 역할
현재 parameter에서 오른쪽으로 조금 움직였더니 loss가 줄었다고 하자. gradient는 어느 쪽으로 가야 하는지를 알려준다. 그런데 같은 크기로 한 번 더 움직이면 계속 좋아질지는 알 수 없다. 지형이 얼마나 빨리 휘는지까지 알아야 한다. 이 휘어짐을 curvature가라고 부른다.
한 변수의 quadratic function는 gradient가 일정한 비율로 바뀐다. 여러 변수에서는 방향마다 휘어짐의 세기가 다르다. 가장 가파르게 휘는 방향에서는 큰 learning rate가 골짜기를 건너뛰게 만들 수 있고, 아주 평평한 방향에서는 loss가 천천히 줄어든다. 방향별 휘어짐을 분해한 값이 뒤에서 읽을 eigenvalue이다.
현재 parameter를 , 여기서 이동한 양을 라고 하면 익숙한 Taylor approximation는 다음과 같다.
는 현재 gradient이고, 는 loss를 두 번 미분한 Hessian 행렬이다. 마지막 항이 방향별 휘어짐을 담는다. 이 식이 유용하려면 parameter가 움직이는 동안 더 높은 차수의 변화가 작아야 한다. 신경망에서는 이 조건을 처음부터 믿을 수 없다. 따라서 이 논문은 근사를 먼저 선언하는 대신 같은 출발점에서 실제 모델과 근사 모델을 각각 학습시켜 비교한다.
2.2 Gauss–Newton과 full Hessian approximation의 차이
중요한 구분이 있다. 저자들이 계속 학습시키는 quad는 위 식에 전체 Hessian 를 그대로 넣은 모델이 아니다. 먼저 모델의 출력 점수를 선형화한 prox를 만들고, 그 모델의 loss를 다시 이차식으로 근사한다. 이때 curvature는 Gauss–Newton 행렬 가 된다.
전체 Hessian에는 음의 eigenvalue가 있을 수 있다. 그 방향으로 quadratic function를 계속 따라가면 아래로 끝없이 내려가는 형태가 생긴다. 반면 여기서 사용하는 Gauss–Newton 행렬은 양의 준정부호이다. 즉 어느 방향의 이차항도 음수가 되지 않는다. 이 성질 덕분에 볼록한 이차 문제의 이론과 비교할 수 있다. 대신 실제 모델의 중요한 비선형 curvature 일부를 버린다는 대가가 있다.
3. Gauss–Newton 근사: logit linearization에서 quadratic loss까지
3.1 Logit linearization: checkpoint에서 Jacobian 고정하기
문장 뒤에 올 token을 예측할 때 LLM은 vocabulary의 각 token에 점수를 준다. 이 점수를 logit이라고 한다. parameter 하나를 바꿨을 때 모든 logit이 얼마나 변하는지 계산한 표가 Jacobian이다. 현재 지점에서 이 표를 고정하면, 이후 parameter 변화에 따른 출력 변화를 일차식으로 계산할 수 있다.
입력 의 logit을 라 할 때 선형화는 다음과 같다.
가 고정된 Jacobian이다. 예를 들어 두 parameter를 조금 바꾸었을 때 ‘고양이’ token 점수가 각각 얼마나 움직일지 현재 지점에서 계산해 두고, 이후에는 두 변화량을 더해 예측한다. 이 예는 작동 방식을 설명하기 위한 예시이며, 논문이 공개한 특정 문장 실험은 아니다.
prox는 이 선형 logit에 원래의 cross-entropy loss를 적용한다. cross-entropy는 정답 token에 부여한 확률이 낮을수록 커지는 오차다. 입력에 대한 특징 변화 규칙은 고정되고, 그 위에서 multiclass logistic regression와 같은 볼록 문제를 푸는 셈이다. 모델 출력을 선형화했다고 loss까지 quadratic function가 된 것은 아니다.
3.2 Quadratic loss: Gauss–Newton curvature 고정하기
quad는 prox의 loss를 같은 기준점에서 한 번 더 근사한다. 출력 점수에 대한 loss의 curvature를 라고 쓰면 다음 관계가 핵심이다.
는 parameter 변화가 logit에 미치는 영향, 는 logit 변화가 loss에 미치는 휘어짐이다. 두 변환을 연결한 가 parameter 공간의 Gauss–Newton curvature다. 전체 Hessian에는 여기에 모델 출력 자체의 이차 미분에서 나오는 항이 더해진다. quad는 그 추가 항을 포함하지 않는다.
이제 실제 LLM, 출력만 선형화한 prox, loss까지 이차화한 quad라는 세 경로가 생긴다. prox가 맞고 quad가 틀리면 loss의 고정 curvature 근사가 추가로 잃은 것이 있다는 뜻이다. 둘 다 틀리면 출력 변화 규칙을 고정한 단계부터 충분하지 않았을 수 있다. 단, 이것만으로 각 오차의 원인을 완전히 분리한 것은 아니다.
3.3 원래 LLM의 validation loss로 근사 경로 평가하기
전체 학습의 10%마다 기준 checkpoint를 잡고, 여기서 전체 예산의 10%만큼 더 학습한다. 출발 parameter뿐 아니라 Adam의 상태, learning rate 일정, parameter 평균화 조건도 맞춘다. 시작점마다 별도의 근사를 새로 만든다. 하나의 quadratic model로 처음부터 끝까지 학습하는 실험이 아니다.
평가에서 더 중요한 것은 근사 모델 자체의 loss를 성과로 사용하지 않는다는 점이다. 근사 경로로 얻은 parameter를 원래 비선형 LLM에 넣고 검증 loss를 측정한다. 근사식 안에서는 좋아 보이지만 실제 모델에는 나쁜 이동을 걸러내기 위해서다. 따라서 아래의 곡선이 비슷하다는 말은 실제 모델의 평가에서도 학습 경로가 유용한 구간이 있다는 뜻이다.
4. OLMO 학습 설정: FineWeb·Adam·learning rate sweep
4.1 OLMO model size·tokenizer·Adam 설정
논문은 non-embedding parameter 약 150M, 전체 약 168M의 OLMO 계열 언어 모델을 사용한다. 폭은 1024, 깊이는 12, attention head는 16이며 sequence 길이는 1024이다. vocabulary는 8192개 BPE token으로 줄였다. 큰 일반 vocabulary를 사용하면 embedding 관련 parameter가 전체에서 너무 큰 비중을 차지하므로, curvature의 대부분이 그 구조에 좌우되는 문제를 줄이려는 선택이다. 따라서 이 모델의 curvature 모양을 큰 vocabulary를 가진 모든 LLM에 그대로 옮기면 안 된다.
원문은 학습 데이터를 FineWeb, 총예산을 3B token으로 설명한다. 공개 저장소의 다운로드 스크립트는 더 구체적으로 HuggingFaceFW/fineweb-edu의 sample/100BT를 가리킨다. 코드에서는 정렬된 데이터 샤드의 마지막 것을 평가용으로 분리한다. 데이터 재현에서는 이 두 표기를 같은 것으로 대충 넘기지 말고 실제 다운로드 대상과 평가 분할을 고정해야 한다.
Adam은 weight decay 없이 사용하며 첫 번째 moment 계수는 0.9, 분모 안정화 상수는 이다. 두 번째 moment 계수는 시간에 따라 바뀐다. 처음 10%는 warmup이며, 주요 실험의 cosine schedule은 마지막 learning rate를 최고값의 10%까지 내린다. 비교 실험에서는 warmup 이후 일정한 learning rate를 유지한다. parameter와 두 번째 moment의 평균화도 결과 해석에 관여한다.
성능 지표는 다음 token 예측의 검증 loss다. 질문 응답, 코딩 문제 정답률, 사용자 선호 같은 downstream benchmark는 이 실험의 평가 대상이 아니다. 검증 loss 차이에서 챗봇 사용성 향상을 직접 주장할 수 없다.
4.2 Learning rate sweep의 최저 loss와 선택된 run 비교
Figure 8은 batch와 learning rate를 바꾸었을 때의 최종 EMA 검증 loss다. 같은 열 안에서 밝고 낮은 값을 찾아야 한다. 행의 learning rate 는 CompleteP parameter화에 따른 값이다. 보통 사용하는 Adam 설정에 숫자 1이나 16을 그대로 복사하라는 뜻이 아니다. 논문은 이 parameter화에서 1이 통상적인 약 0.001 규모와 대응한다고 설명한다.
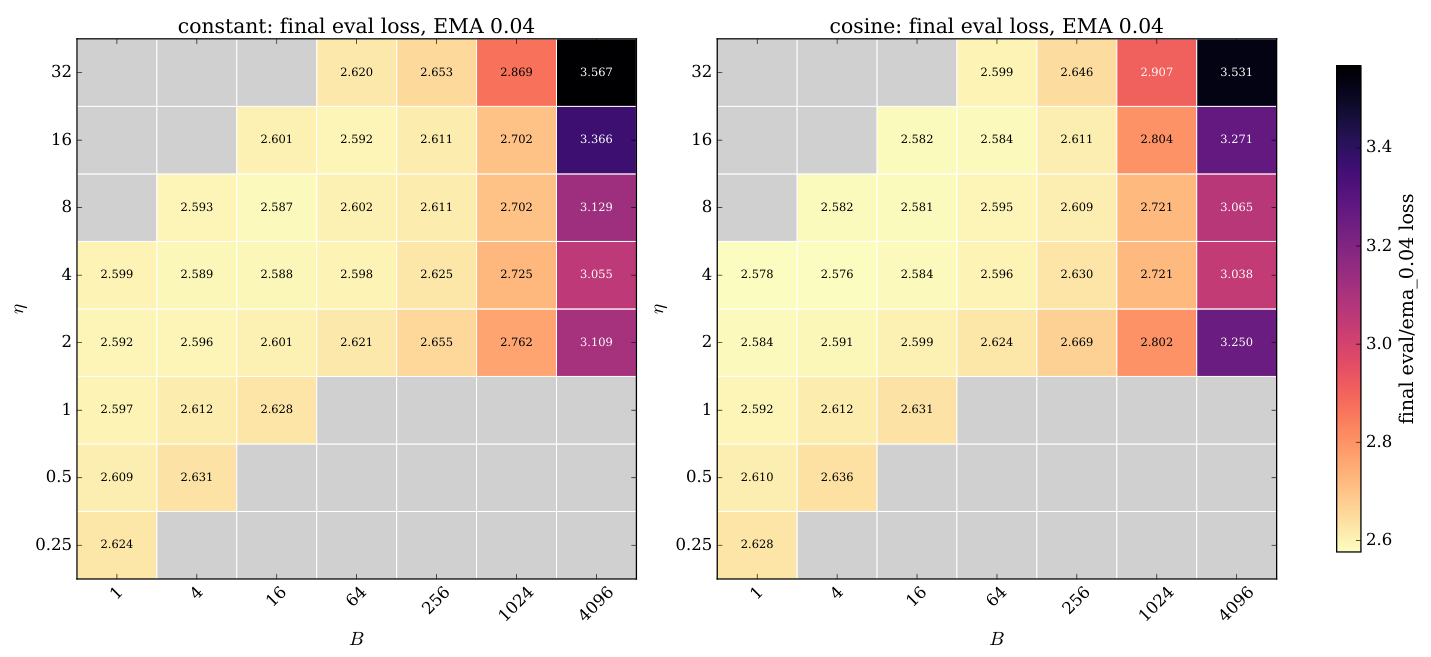
공개 CSV에서 선택한 세 batch의 최솟값을 추리면 다음과 같다. 원본 그림은 소수 셋째 자리로 표시하므로 반올림하면 같은 값으로 보이는 조합도 있다.
| 일정 | batch | 탐색 내 최저 learning rate | 최종 검증 loss |
|---|---|---|---|
| cosine | 1 | 4 | 2.578488 |
| cosine | 64 | 16 | 2.584473 |
| cosine | 1024 | 4 | 2.720546 |
| 일정 유지 | 1 | 2 | 2.592361 |
| 일정 유지 | 64 | 16 | 2.591741 |
| 일정 유지 | 1024 | 8 | 2.701634 |
같은 cosine schedule에서도 batch 1의 최적 값은 4, batch 64는 16이다. batch가 커질 때 learning rate를 늘리는 관행과 어느 정도 맞지만, batch 1024에서 다시 4가 최저다. 이 표만으로 무조건적인 선형 learning rate 확대 법칙을 만들 수 없는 이유다.
공개 코드에서 추가로 확인한 점: 이후 근사 경로를 비교하는 데이터가 이 표의 최저 실행을 항상 사용하지는 않는다. 예를 들어 cosine·batch 1024의 continuation 데이터는 , 최종 loss 2.804079인 실행을 사용한다. 탐색 최저 2.720546보다 약 0.083533 높다. cosine·batch 1과 일정 유지·batch 1024에서도 선택 실행이 최저 실행과 다르다. 따라서 이 논문의 후속 곡선을 ‘모든 batch에서 가장 잘 튜닝된 실행의 결과’라고 부르지 않는다. 이 차이가 결론에 얼마나 영향을 주는지는 별도 비교가 필요하다.
5. Batch 64의 quadratic approximation: 유효 구간이 252M token까지 늘어나는 조건
5.1 후기 checkpoint에서 quadratic approximation이 더 오래 유지되는 이유
batch 64로 학습한 모델의 90% checkpoint를 생각하자. 총예산은 30억 token이므로 기준점은 약 27억 token 지점이다. 원래 학습 경로와 quadratic approximation 경로를 각각 더 진행한다. 두 경로의 실제 모델 검증 loss 차이가, 원래 경로가 줄인 loss의 10% 이내인 동안을 ‘잘 맞는 구간’으로 센다.
논문의 Table 1은 이 구간이 전체 예산의 몇 %인지를 기록한다. 8.4라면 다음과 같이 token 수로 읽는다.
이는 2억 5,200만 token 동안의 근사 유효 길이이지 정확도나 loss의 개선율이 아니다. 같은 batch에서 80% checkpoint의 quad는 5.2, 즉 1억 5,600만 token이다. 늦은 기준점에서 더 길게 맞는 사례를 직접 비교할 수 있다. 다만 모든 batch·checkpoint에서 길이가 단조롭게 증가하지는 않는다.
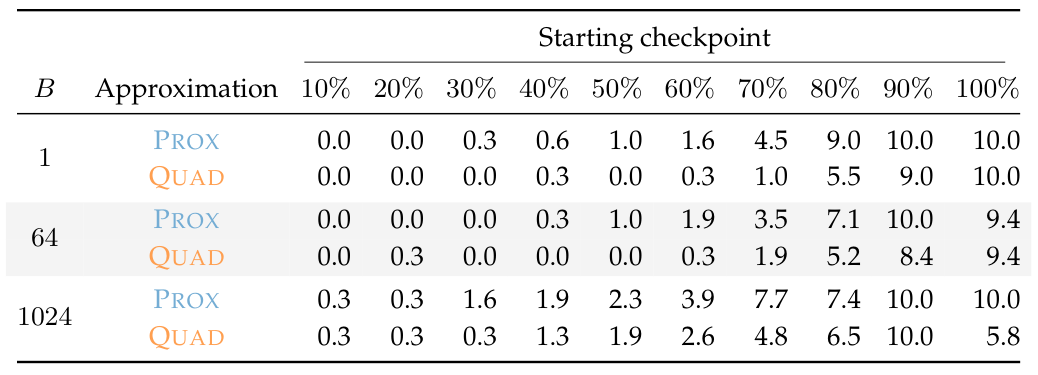
초기 구간의 0.0도 함께 읽어야 한다. batch 1의 quad는 10·20·30% 출발점에서 모두 0.0이고, batch 64는 50%에서도 0.0이다. 반대로 batch 1의 마지막 두 값은 9.0과 10.0이다. batch 1024에서는 90%의 10.0이 100%에서 5.8로 줄어든다. ‘학습 후반이면 무조건 정확하다’는 규칙으로 바꾸면 이 차이를 놓친다. 표의 10.0은 실험이 측정한 상한에 도달했다는 뜻이며 그 이후도 계속 맞는다는 보장은 없다.
5.2 Batch·preconditioner·spectrum·source condition 용어
| 용어 | 이 논문에서 실제로 가리키는 것 | 읽을 때의 주의점 |
|---|---|---|
| batch | 한 업데이트에 사용하는 길이 1024의 sequence 개수 | 는 64token이 아니다 |
prox | logit을 현재 Jacobian으로 선형화하고 cross-entropy는 유지한 모델 | loss가 quadratic function는 아니다 |
quad | prox의 loss까지 Gauss–Newton 이차식으로 근사한 모델 | 전체 Hessian 근사와 구별한다 |
| preconditioner | 좌표별 업데이트 크기를 조정하는 행렬 | 여기서 preconditioning은 데이터 정제가 아니다 |
| spectrum | curvature 행렬의 eigenvalue들을 순서대로 본 것 | 큰 값 몇 개와 작은 값이 많은 꼬리를 나누어 본다 |
| EMA | 최근 parameter 등에 더 큰 비중을 주는 이동 평균 | 평가 parameter와 학습 중 원시 parameter는 다를 수 있다 |
| source condition | curvature 방향별로 남은 오차가 어떻게 분포하는지에 관한 조건 | curvature eigenvalue의 감소율과 별개의 양이다 |
| 안정성 경계 | 설정을 더 공격적으로 바꾸면 반복 업데이트가 발산하기 시작하는 경계 | 평균 loss의 안정성과 개별 경로의 안정성을 구별한다 |
이 표에서 가장 쉽게 혼동하는 것은 spectrum과 source condition이다. 전자는 지형이 얼마나 휘는지 묻는다. 후자는 현재 위치가 각 방향에서 얼마나 더 내려갈 여지를 가지고 있는지 묻는다. 같은 그릇이라도 출발 위치가 다르면 내려갈 거리는 다르다.
6. Quadratic approximation 결과: cosine과 constant learning rate 비교
6.1 Cosine schedule에서 prox·quad의 유효 구간
Figure 1에서 검은 점선은 실제 LLM의 계속 학습 경로다. 위쪽 파란 선은 prox, 아래쪽 주황 선은 quad로 학습한 parameter를 실제 LLM에서 평가한 loss다. 세 열은 각각 batch 1·64·1024다. 여러 곡선이 있는 이유는 checkpoint마다 새로운 근사 모델을 만들었기 때문이다.
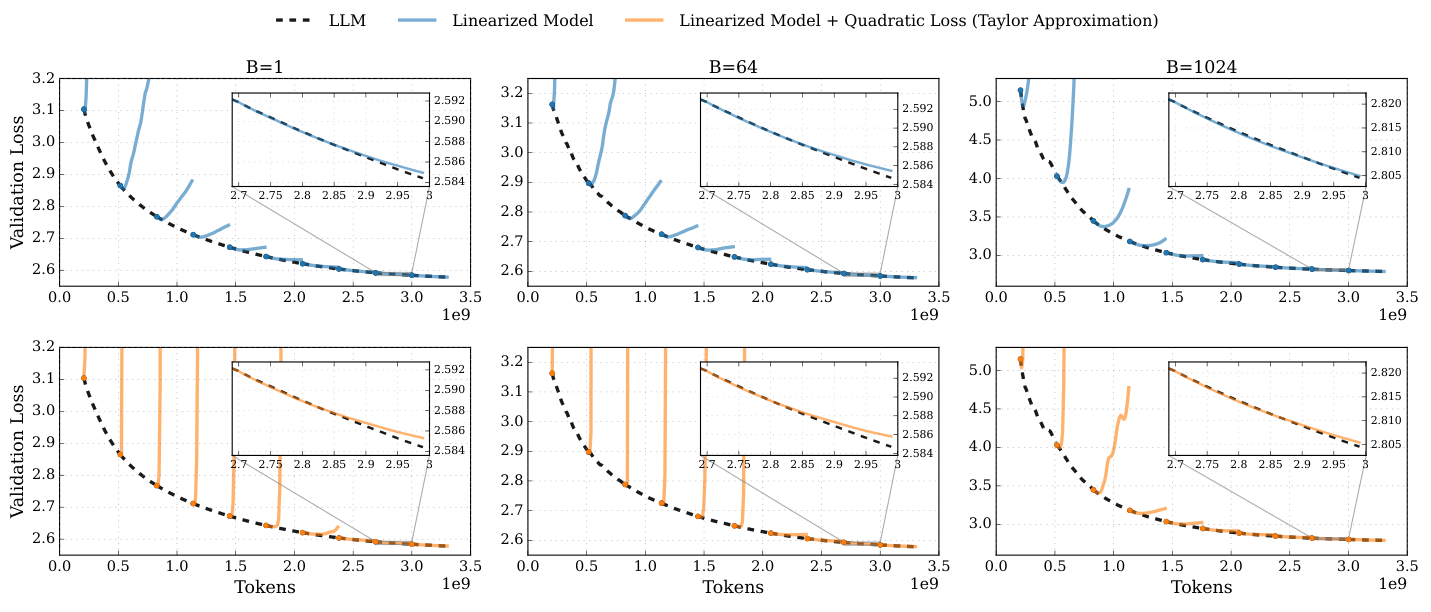
초기의 주황 선은 파란 선보다도 빠르게 위로 튄다. 출력 변화 규칙을 고정하는 것에 더해 loss curvature까지 고정하면 잃는 정보가 늘어난다는 관찰과 맞는다. 후반에는 두 색 모두 점선을 가깝게 따라가는 구간이 생기지만, 특히 quad는 어느 시점부터 다시 벗어난다. 앞의 Table 1이 이 시각적 인상을 오차 기준으로 수치화한 것이다.
이 비교가 뒷받침하는 결론은 ‘cosine schedule으로 학습한 이 모델의 후반에 유효한 국소 근사 구간이 있다’이다. 모델 전체가 quadratic function라거나 초기 표현 학습이 필요 없다는 결론은 아니다. 근사 모델을 더 오래 학습해도 된다는 보장도 없다.
6.2 Constant learning rate에서 근사가 실패하는 반례
같은 질문을 learning rate를 일정하게 유지한 모델에 물으면 결과가 달라진다. Figure 12는 같은 방식으로 파란 prox, 주황 quad, 검은 실제 모델 경로를 비교한다. 마지막 checkpoint의 확대창에서도 근사 경로가 실제 모델과 갈라지고 loss가 올라간다.
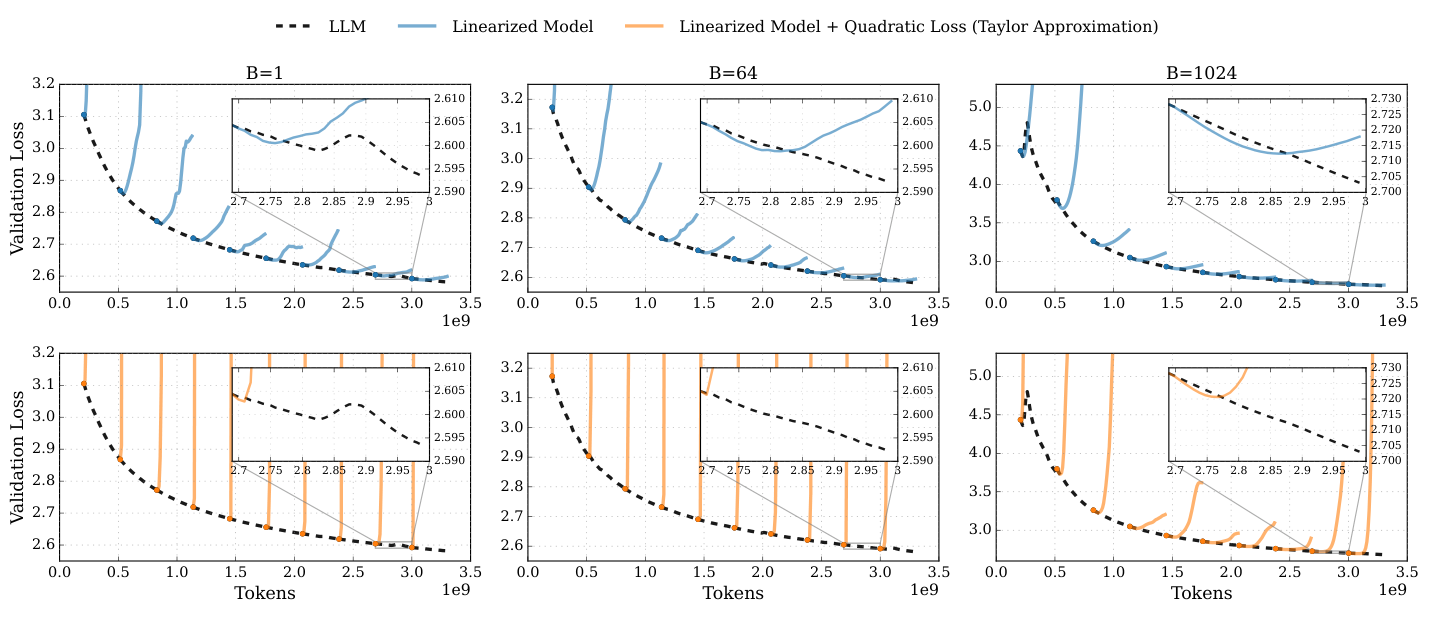
Constant learning rate에서는 cosine schedule에서 길게 유지되던 proxy와 원래 학습 경로의 일치가 약해진다. 같은 방식으로 quadratic approximation을 만들더라도 schedule에 따라 loss trajectory를 예측하는 유효 구간이 달라진다는 결과다. 곡선은 schedule 의존성을 보여주지만 정확한 차이의 크기를 별도 원자료 없이 새 수치로 추정하지 않는다.
이 대조는 learning rate 일정이 근사 유효성에 관련 있음을 보여준다. 저자들은 안정성 경계 근처에서 작동하는 현상과의 관련성을 추정한다. 그러나 일정 변경은 학습 경로와 도착점도 함께 바꾼다. 따라서 이것을 특정 내부 메커니즘 하나만 제거한 엄밀한 단일 요소 ablation으로 읽지는 않는다. quadratic model이 실패하는 이유를 완전히 증명한 결과도 아니다.
6.3 학습 후반 loss와 token 수의 power law
Figure 9는 마지막 다섯 checkpoint에 공통 loss 바닥을 두고 거듭제곱 곡선을 맞춘 결과다. 직관은 간단하다. 확률적 업데이트의 잡음을 평균내는 효과가 지배적이라면, 데이터를 더 처리할수록 남은 오차가 누적 token 수의 역수처럼 줄 수 있다.
는 처리한 학습 token 수, 는 여섯 곡선에 함께 맞춘 바닥 값, 는 크기, 는 감소 속도다. 이면 token 수를 두 배로 늘릴 때 바닥보다 높은 부분이 절반이 된다. 이 관계는 예측 공식으로 검증된 것이 아니라 선택한 후반 구간에 맞춘 곡선이다.
같은 loss 바닥을 사용해도 곡선의 기울기는 조건마다 다르다.
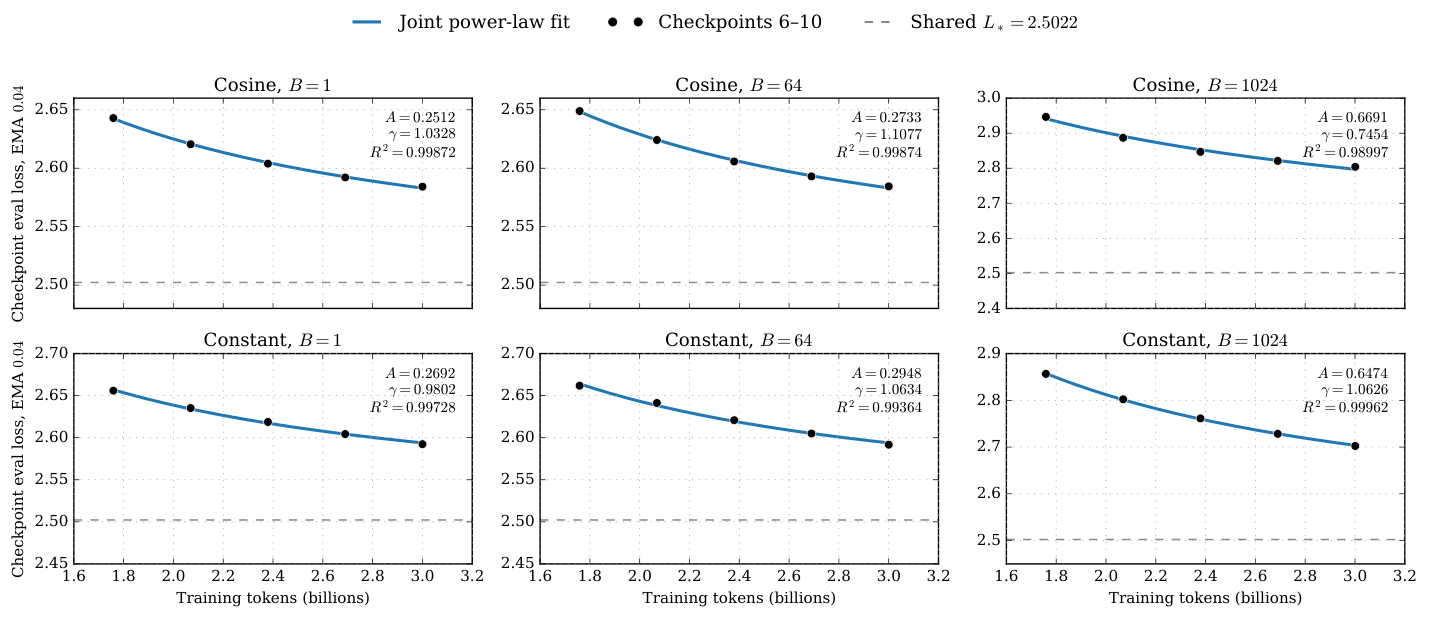
특히 cosine·batch 1024의 지수는 나머지 다섯 조건보다 낮으며, 아래 표에서 그 차이를 확인할 수 있다.
| 일정 | batch 1의 | batch 64의 | batch 1024의 |
|---|---|---|---|
| cosine | 1.0328 | 1.1077 | 0.7454 |
| 일정 유지 | 0.9802 | 1.0634 | 1.0626 |
다섯 조건은 1 부근이지만 cosine·batch 1024는 분명히 낮다. 이 조건의 적합도 는 약 0.98997이며 나머지도 약 0.994 이상으로 높다. 높은 적합도는 다섯 관측점을 잘 설명한다는 뜻이다. 평균화가 유일한 원인이라는 증명이나 훨씬 큰 모델·더 긴 학습에 대한 외삽 근거는 아니다. 일정한 learning rate에서도 loss 곡선의 지수는 1에 가깝지만 국소 근사 경로는 실패했다는 점도 기억해야 한다. 두 관찰은 같은 명제가 아니다.
7. Lanczos 원리: curvature matrix를 저장하지 않고 spectrum 측정하기
7.1 Matrix-vector product로 curvature 방향 측정하기
1억 개가 넘는 parameter의 모든 쌍에 대한 이차 미분을 표로 저장하면 너무 크다. 하지만 특정 방향 에 대해 를 계산하는 것은 자동 미분으로 처리할 수 있다. 이는 그 방향으로 gradient가 어떻게 바뀌는지 묻는 연산이다. Lanczos 방법은 이러한 행렬·vector 곱을 반복해 작은 행렬에 원래 행렬의 spectrum 정보를 담는다.
Algorithm 1의 입력은 큰 행렬 자체가 아니라 vector를 넣으면 curvature 행렬과의 곱을 돌려주는 연산, 시작 방향, 반복 깊이 이다. 매번 새 방향을 만들고 이전 방향의 성분을 빼서 서로 다른 정보를 수집한다. 이렇게 얻은 기저로 작은 삼중 대각 행렬을 만들고, 그 행렬의 eigenvalue와 weight를 구한다. eigenvalue의 추정값을 Ritz 값이라고 부른다.
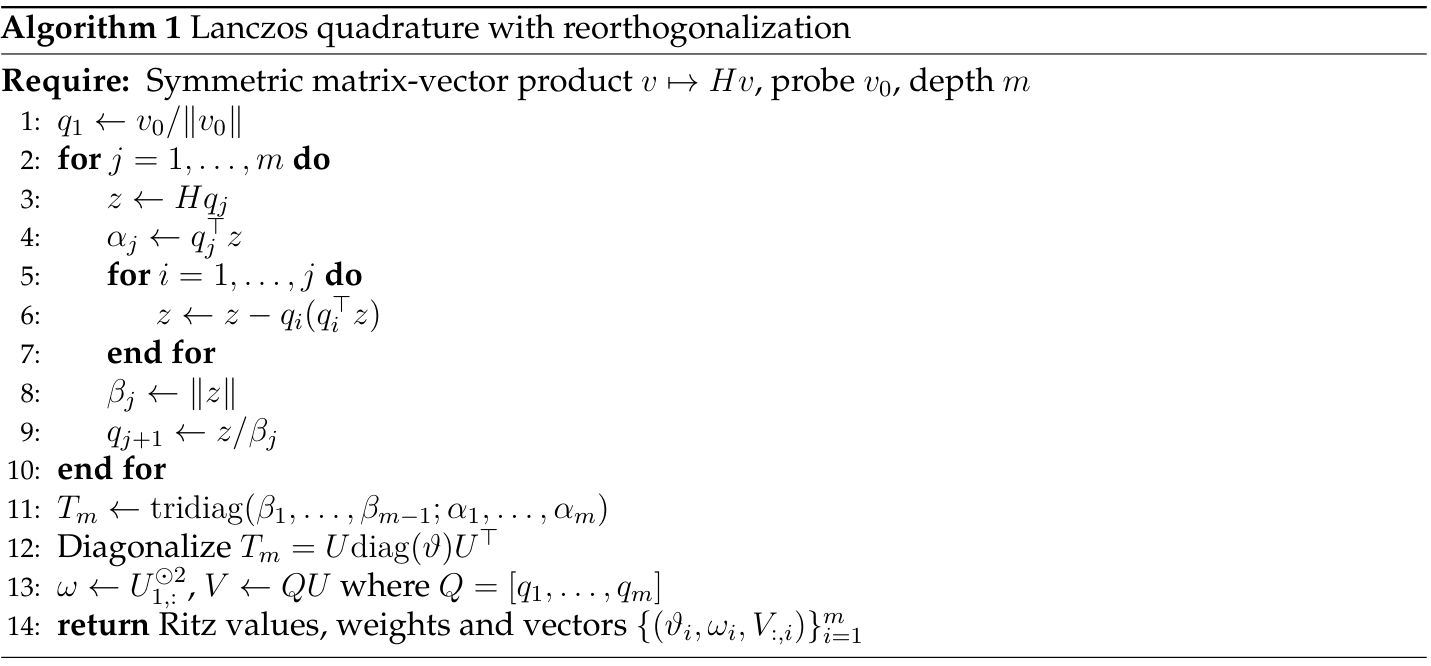
왜 이전 방향을 다시 빼야 할까. 컴퓨터의 유한 정밀도 때문에 이론상 직교해야 하는 방향이 조금씩 겹치기 때문이다. 큰 eigenvalue 방향이 반복해서 섞이면 같은 큰 값을 여러 번 본 것처럼 되고 작은 값의 분포를 놓친다. 저자들은 짧은 3항 점화만 사용하는 방식이 약 100단계 부근에서 정확도를 잃는다고 보고한다. 저장한 전체 기저로 재직교화하는 이유다.
이 실험은 깊이를 1200까지 늘리고 기저를 float32로 보관했다. 논문이 보고한 이 기저의 메모리는 약 750GB이며 16대의 H100에 걸쳐 사용했다. 이는 저자들의 실행 조건이며 이 글에서 같은 하드웨어 실험을 수행한 것은 아니다. float16 기저는 정확도를 해쳤고 float32에서 float64로 올려도 의미 있는 개선이 없었다는 정밀도 대조도 포함한다. 다만 본문은 이 대조에 대한 단일 오차 표를 제시하지 않으므로 임의의 개선율을 붙이지 않는다.
7.2 Random start와 gradient-direction start의 차이
무작위 방향으로 시작하면 행렬 전체에 eigenvalue가 얼마나 분포하는지 추정할 수 있다. 현재 gradient 방향으로 시작하면 eigenvalue마다 현재 gradient가 얼마나 실려 있는지를 추정한다. 전자가 지형의 모양이고 후자가 현재 위치와 지형의 관계다. 뒤의 source condition 계산에는 두 정보가 모두 필요하다.
논문은 Hessian과 Gauss–Newton 각각에 대해 Adam의 좌표별 조정을 적용한 경우와 적용하지 않은 경우를 조사한다. Adam curvature의 eigenvalue는 비대칭 표현 대신 다음의 대칭 행렬로 계산할 수 있다.
는 좌표별 크기를 조정하는 양의 대각 행렬이다. 두 행렬은 같은 eigenvalue를 가지므로 대칭 행렬용 Lanczos를 쓸 수 있다. 공개 코드의 raw도 완전한 항등 좌표계라는 뜻은 아니다. CompleteP의 기본 learning rate 배율은 남아 있다. 따라서 raw와 Adam 곡선을 비교할 때는 어떤 좌표 단위를 사용했는지를 함께 봐야 한다.
7.3 작은 eigenvalue를 읽을 때의 Lanczos 오차
1200개의 작은 행렬 eigenvalue를 얻었다고 1억 개가 넘는 원래 eigenvalue를 모두 정확히 구한 것은 아니다. 저자들은 Gauss–Radau 구적법으로 특정 eigenvalue보다 큰 값이 몇 개쯤 있는지에 대한 구간을 만든다. Algorithm 2는 Lanczos가 만든 작은 행렬과 마지막 잔차를 받아, 검사할 값의 가능한 순위 구간을 돌려준다.
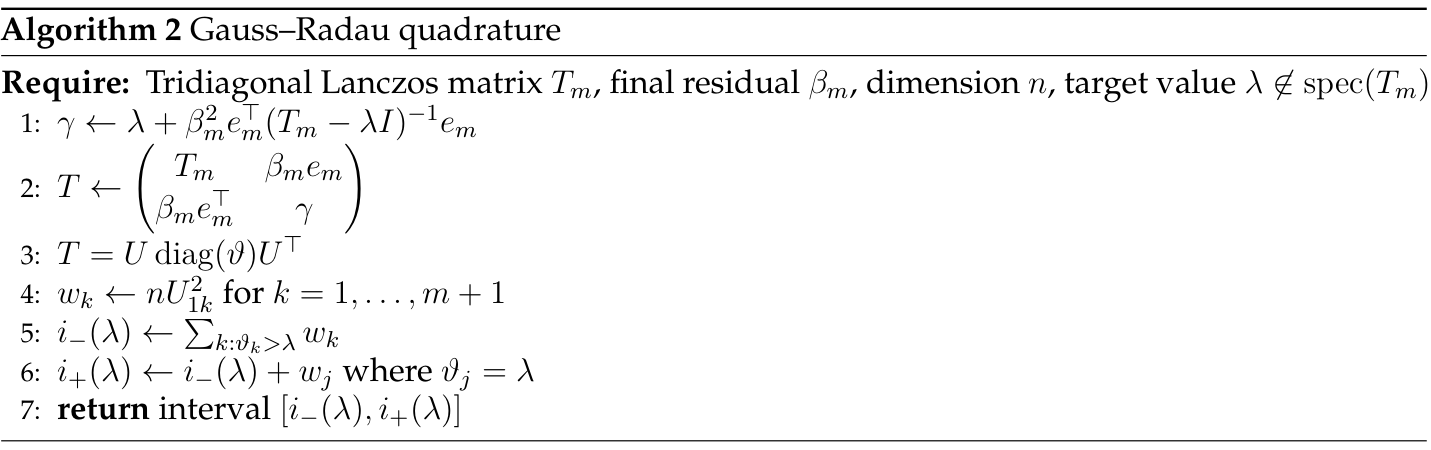
반복 깊이가 일 때 대략 규모까지 볼 수 있다는 해석을 사용하면, 1200단계는 약 144만 배의 eigenvalue 범위를 가리킨다. 논문이 여섯 자릿수에 걸친 꼬리를 조사하려는 이유다. 이는 모든 spectrum에 대해 오차가 똑같다는 보장은 아니다. 특히 전체 Hessian은 큰 양수와 음수 eigenvalue를 함께 가지므로 작은 꼬리의 해상도를 확보하기 더 어렵다.
Figure 18은 이 방법의 동작을 별도로 점검한다. 처음 두 열은 진짜 eigenvalue를 알고 있는 거듭제곱 모양의 합성 예다. 뒤의 두 열은 실험에서 추정한 spectrum을 기반으로 만든 일관성 점검이다. 뒤의 검은 선을 실제 LLM의 거대한 전체 행렬을 정확히 대각화한 정답이라고 오해하면 안 된다.
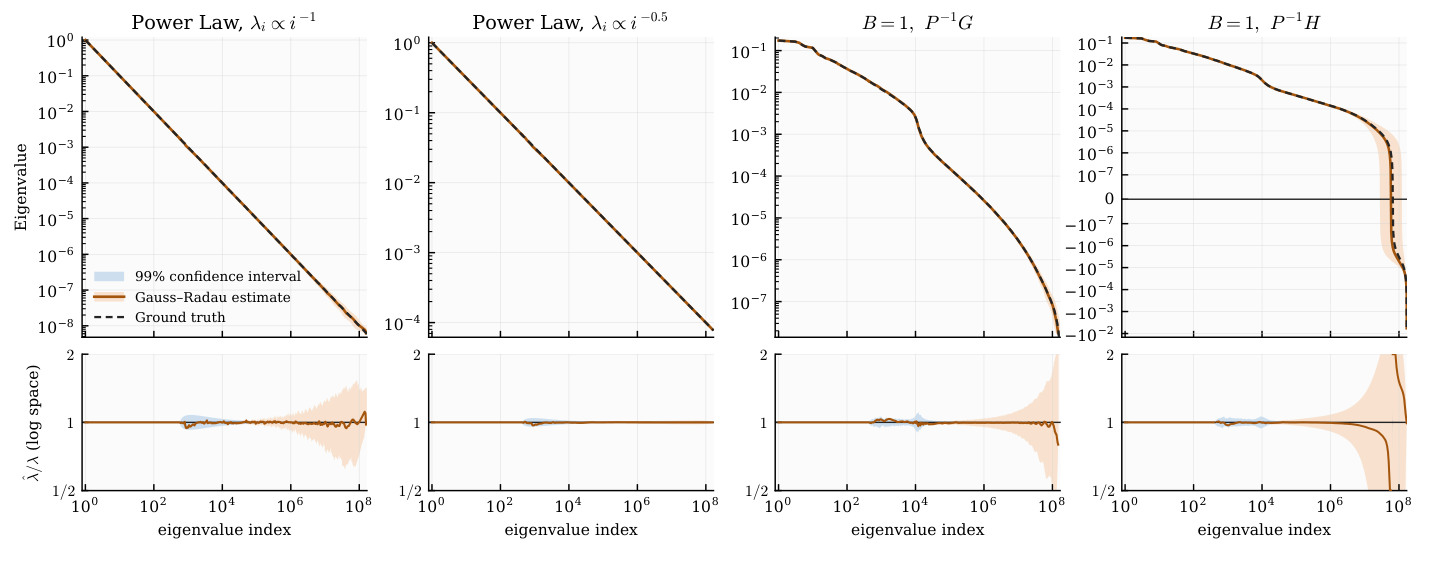
아래 패널에서 비율이 1에 가까우면 기준과 잘 맞는다. 꼬리 끝에서 주황 영역이 넓어지는 것은 깊이 제한으로 정보가 부족해지는 구간이다. 파란 99% confidence interval은 무작위 탐침 때문에 생기는 불확실성이다. 모든 색 영역을 같은 종류의 confidence interval이라고 부르면 안 된다.
8. Curvature spectrum 결과: 큰 eigenvalue와 작은 eigenvalue의 차이
8.1 Batch·checkpoint·preconditioning에 따른 spectrum tail
Figure 2의 가로축은 추정한 eigenvalue 순위, 세로축은 eigenvalue 크기다. 왼쪽은 가장 큰 curvature 방향이고 오른쪽으로 갈수록 더 평평한 방향이다. 행은 batch 1·64·1024, 열은 학습 10·50·100%다. 파란 선은 Gauss–Newton, 빨간 선은 Hessian이며 실선과 점선으로 Adam 조정 여부를 구분한다.
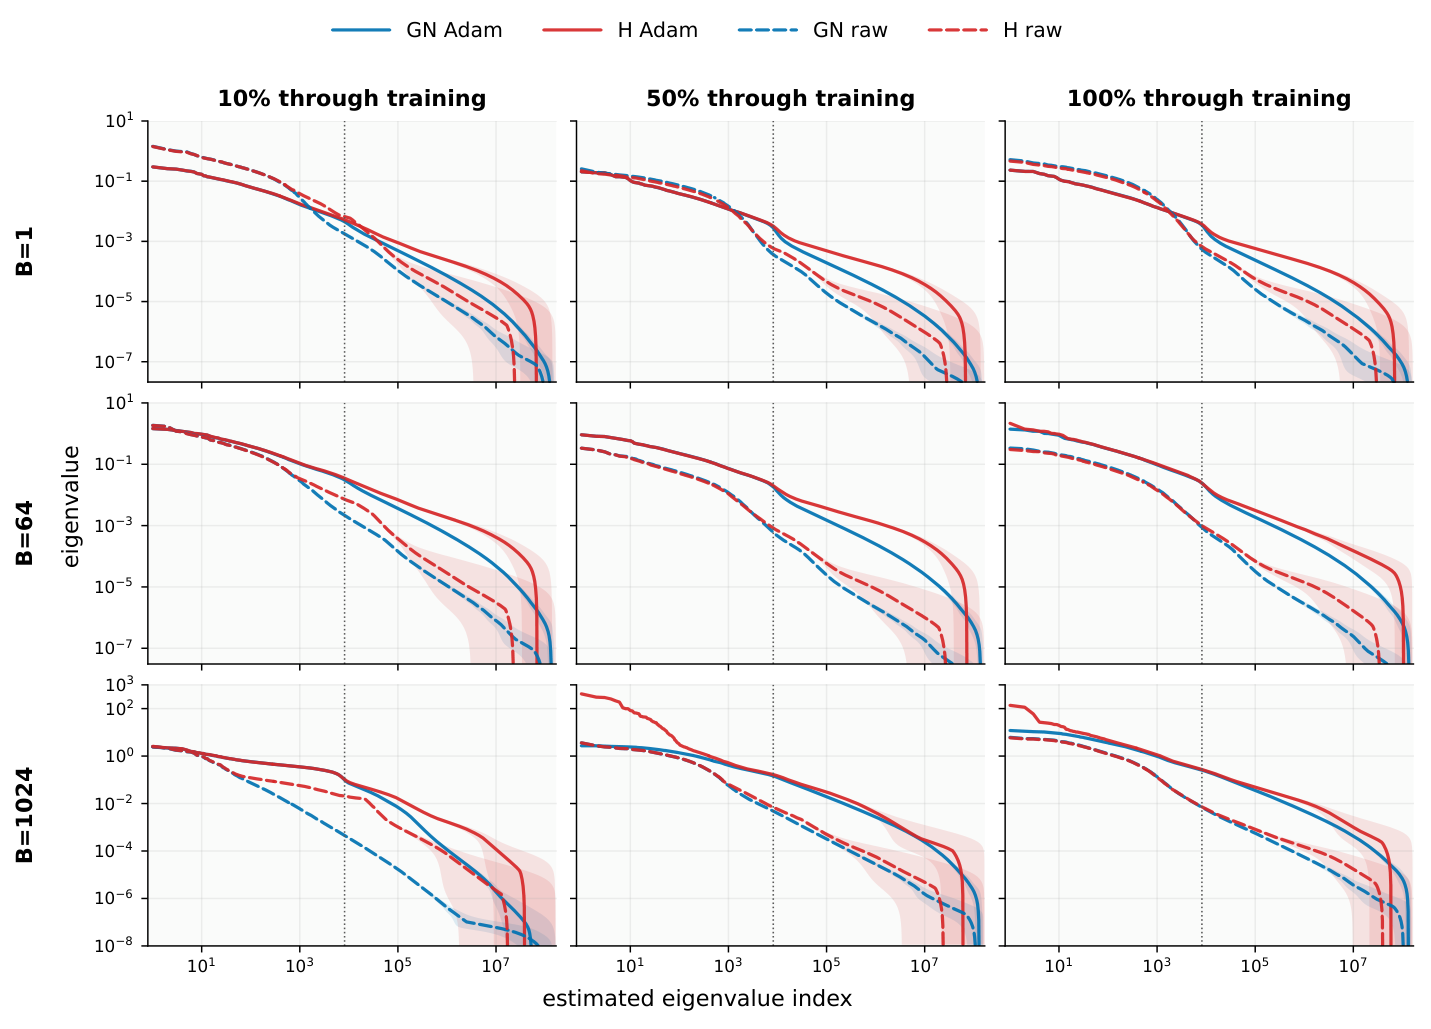
먼저 50%와 100% 열을 같은 행 안에서 비교한다. 큰 모양이 상당히 비슷하다. 그다음 한 패널 안의 파란색과 빨간색을 비교한다. 머리 부분은 닮아도 꼬리의 감소 속도는 다르다. 마지막으로 batch 1024의 빨간 선 왼쪽을 보면 다른 batch보다 큰 이상 eigenvalue가 나타난다. ‘spectrum이 보편적이다’라는 한 문장으로 세 관찰을 덮으면 안 되는 이유다.
Figure 3은 이 차이를 네 질문으로 나누어 보여준다. (a)는 batch 1의 큰 eigenvalue와 token 빈도, (b)는 음의 Hessian eigenvalue, (c)는 학습 중·후반의 변화, (d)는 크기를 맞춘 뒤 남는 꼬리 모양이다.
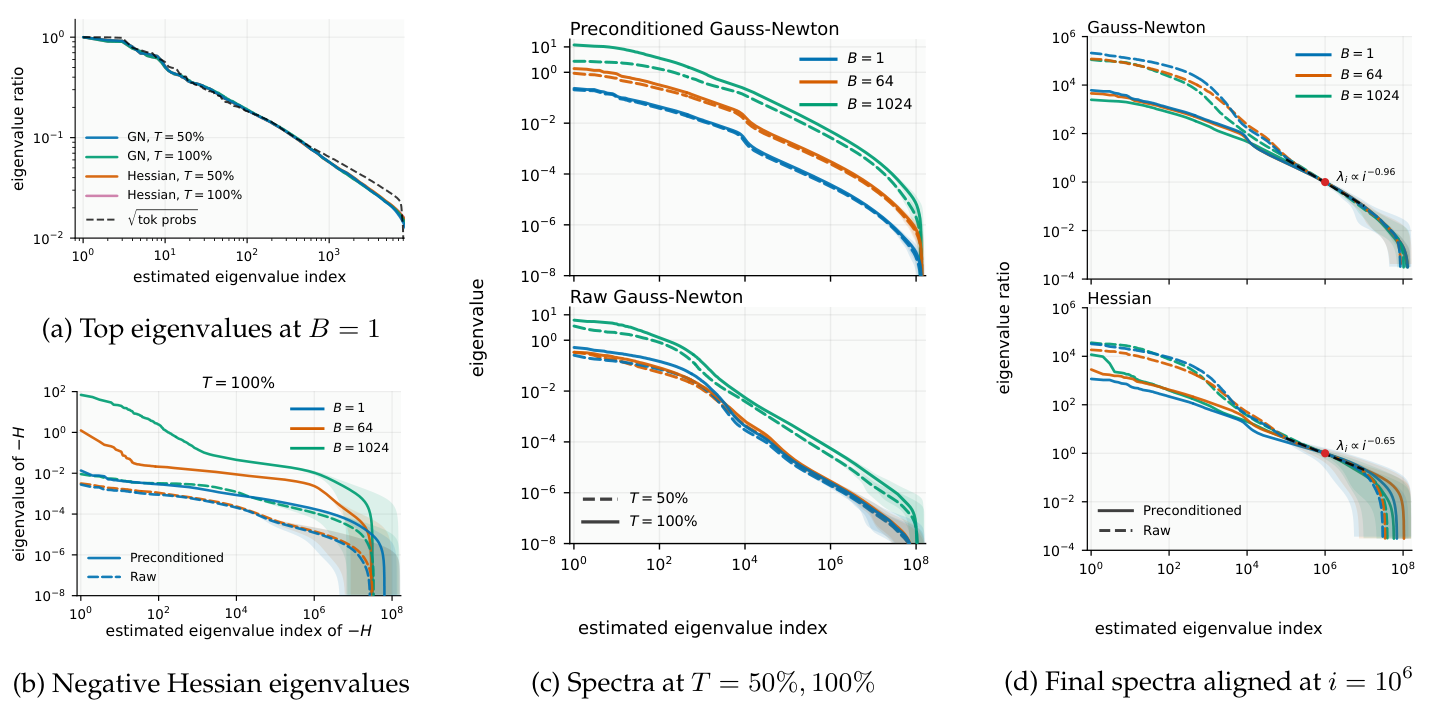
(a)에서는 상위 eigenvalue의 비율이 token 확률의 제곱근과 가깝게 움직인다. 특히 큰 세 방향은 ‘the’, 쉼표, 마침표 같은 빈번한 token과 관련된다고 저자들은 분석한다. 출력 vocabulary와 관련된 행렬이 큰 curvature를 주도한다는 관찰과 이어진다. 이 관계를 neural collapse라는 표현 구조와 연결하는 설명은 저자들의 가설이며, 여기서 그 발생 원인을 통제 실험으로 확정한 것은 아니다.
(b)는 의 양의 eigenvalue를 그려 원래 Hessian의 음의 방향 크기를 보여준다. batch 64와 특히 1024에서 음의 curvature가 무시할 만큼 작지 않다. 이는 양의 준정부호인 Gauss–Newton 근사가 실제 curvature의 모든 방향을 보존하지 않는 직접적인 증거다.
(c)는 50%와 100%를 같은 좌표계에서 겹친 것이다. (d)는 eigenvalue 순위 지점의 값을 맞춘 뒤 비교한다. 이 정렬 후 약 부터 사이의 꼬리 모양이 서로 가까워진다. Gauss–Newton의 감소 지수는 약 0.96, Hessian은 약 0.65다.
는 큰 순서로 센 eigenvalue의 위치다. 가 작으면 순위가 커질 때 값이 더 천천히 감소한다. 예를 들어 순위가 10배 커질 때 0.96 지수의 값은 약 9분의 1, 0.65 지수의 값은 약 4.5분의 1이 된다. 이는 지수의 의미를 풀어 쓴 계산이다. 모든 모델에서 이 정확한 지수를 얻는다는 뜻은 아니다.
이 확대도는 기준점의 높이를 맞춘 뒤 tail의 모양을 비교한다.
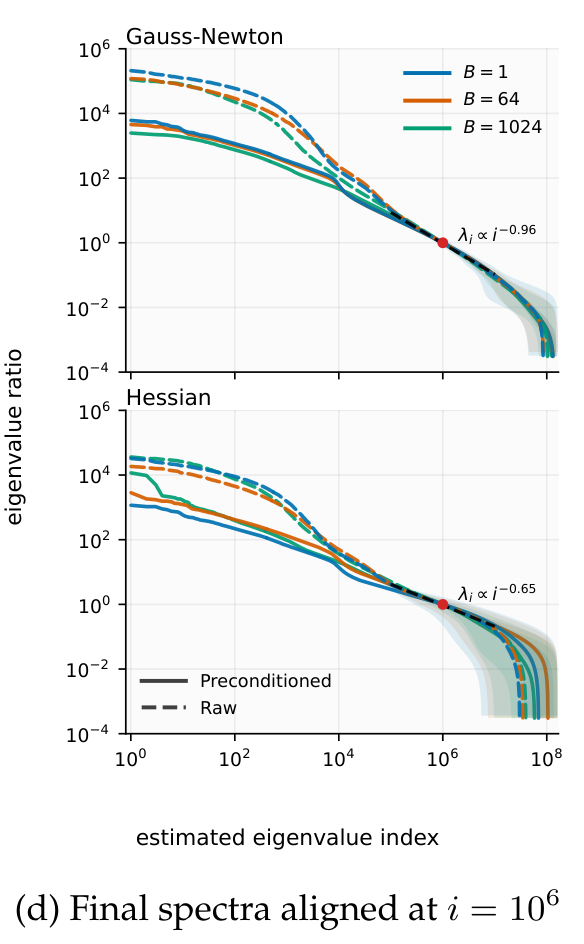
eigenvalue 순위 10^6에서 높이를 맞추면 대략 10^5–10^7 범위의 tail이 서로 가까워진다. 이 구간에서 Gauss–Newton의 감소 지수는 약 0.96, Hessian은 약 0.65다. 여러 batch·checkpoint에서 반복되는 tail 형태가 있다는 것이 claim이며, normalize하기 전 curvature의 절대 크기가 같다는 뜻은 아니다.
곡선이 겹친다고 원래 curvature의 절대 크기까지 같다는 뜻은 아니다.
8.2 Curvature eigenvector와 model component의 관계
Figure 4는 eigenvalue뿐 아니라 해당 방향 vector의 성분이 어느 모듈에 속하는지도 보여준다. 아래의 색 띠는 한 방향에서 모듈별 성분이 차지하는 비중이다. 회색은 마지막 출력 변환인 unembedding, 노란색은 MLP의 확장층 mlp up이다.
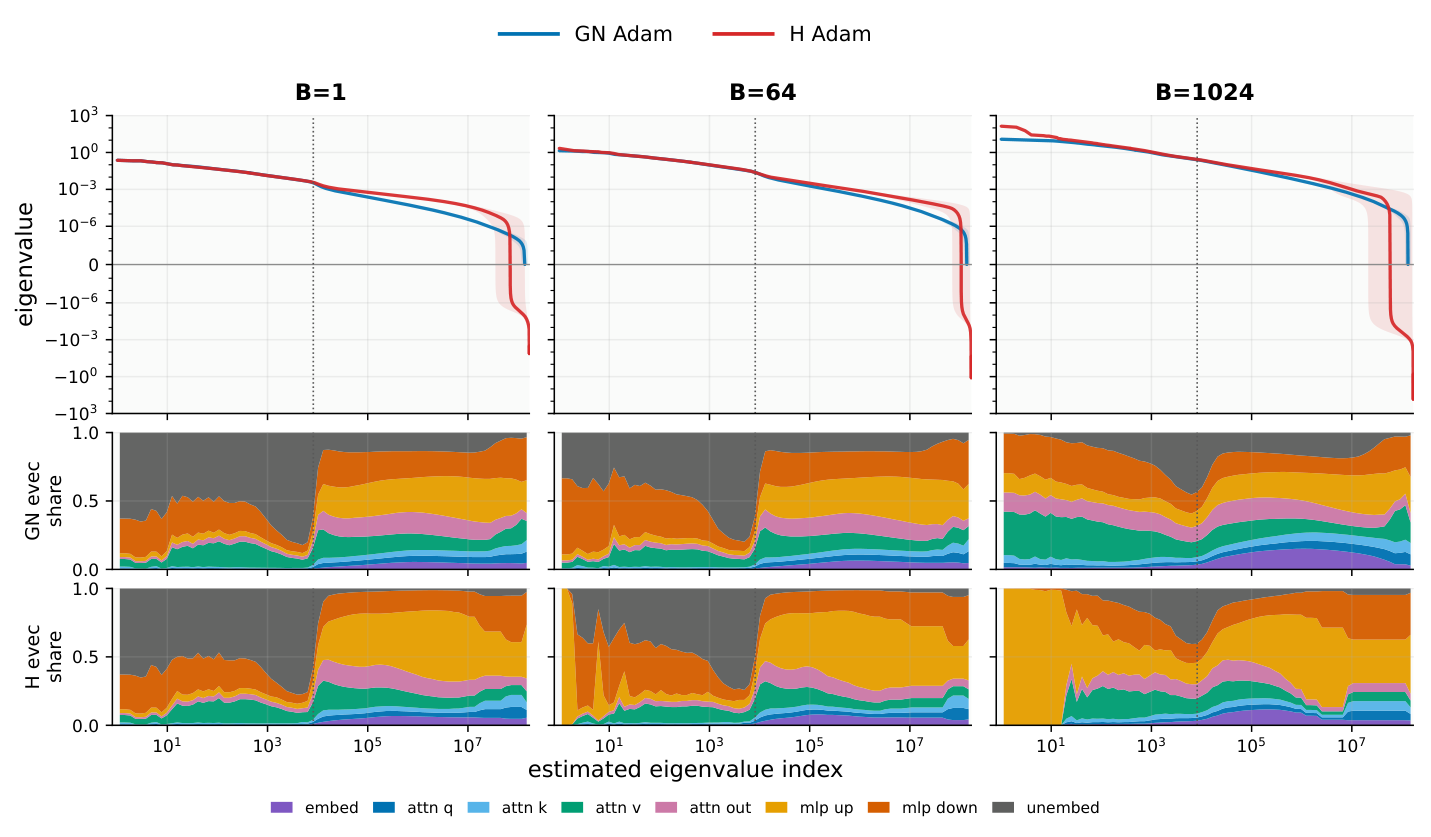
batch 1·64에서는 큰 curvature 쪽의 회색 비중이 크다. vocabulary 크기 약 8192 부근을 지나 꼬리로 들어가면 여러 모듈의 비중이 더 고르게 섞인다. 논문은 꼬리의 비중이 각 모듈의 parameter 수와 대체로 대응한다고 설명한다. 이는 작은 curvature가 특정 한 층만의 문제가 아님을 시사한다. 반면 batch 1024의 극단적인 Hessian 방향은 MLP 확장층 비중이 크다.
저자들은 일부 비활성 뉴런과 희소한 큰 업데이트가 이런 이상 방향에 관련될 가능성을 제시한다. 여기서 색 띠만 보고 죽은 뉴런이 원인이라고 확정할 수는 없다. 이를 검증하려면 해당 뉴런을 조절하는 통제 실험이 더 필요하다.
부록 Figure 10은 cosine schedule의 세 시점 전체를, Figure 14는 일정한 learning rate의 같은 분해를 보여준다. Figure 10의 캡션에 있는 학습 종료 표현보다 실제 열 제목 10·50·100%를 기준으로 읽어야 한다. 두 그림은 한 시점의 인상을 여러 시점·일정으로 확장해 확인하는 자료다.
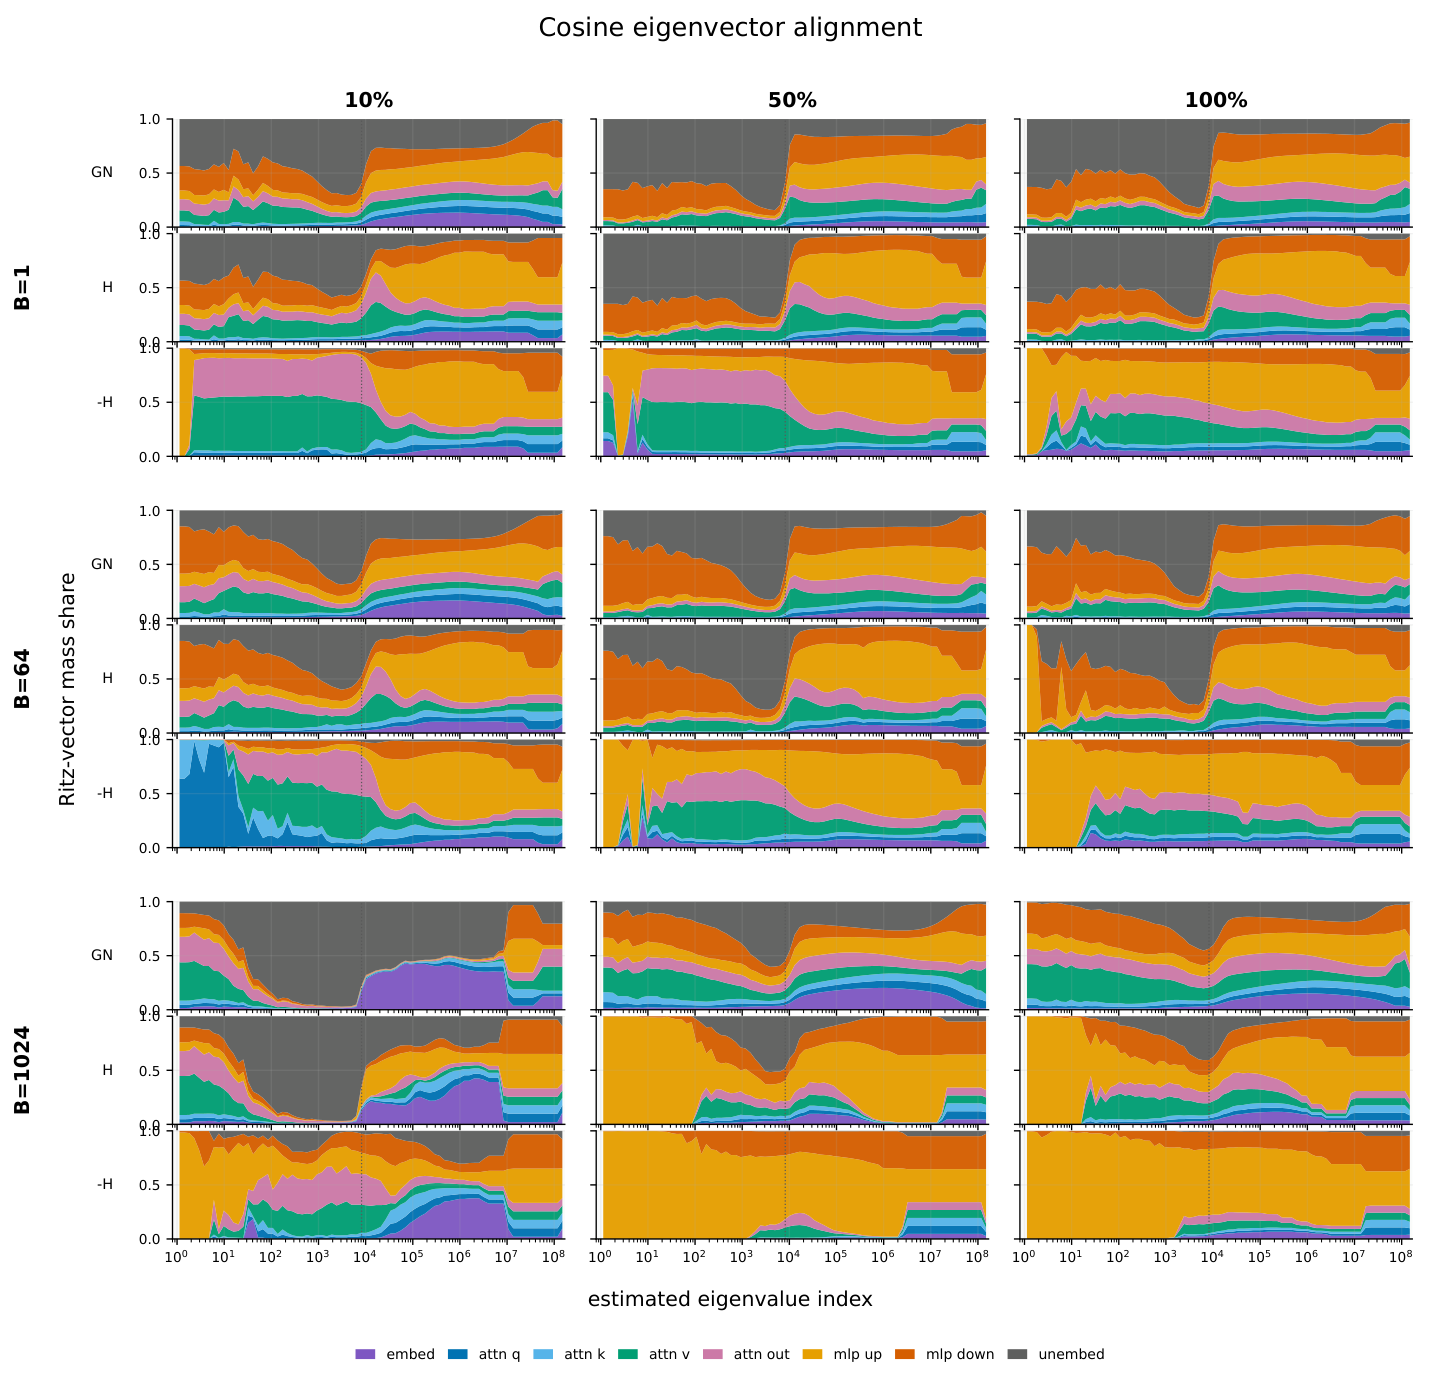
batch 1024의 초기 GN·H 방향은 중간과 끝의 방향 분포와 같지 않다. 반면 작은 batch에서 머리의 unembedding 우세와 꼬리의 혼합이라는 구조는 여러 시점에서 관찰된다. 이 그림은 방향 성분의 분포를 보여주며 개별 eigenvector가 시간에 따라 같은 vector로 유지된다는 증거는 아니다.
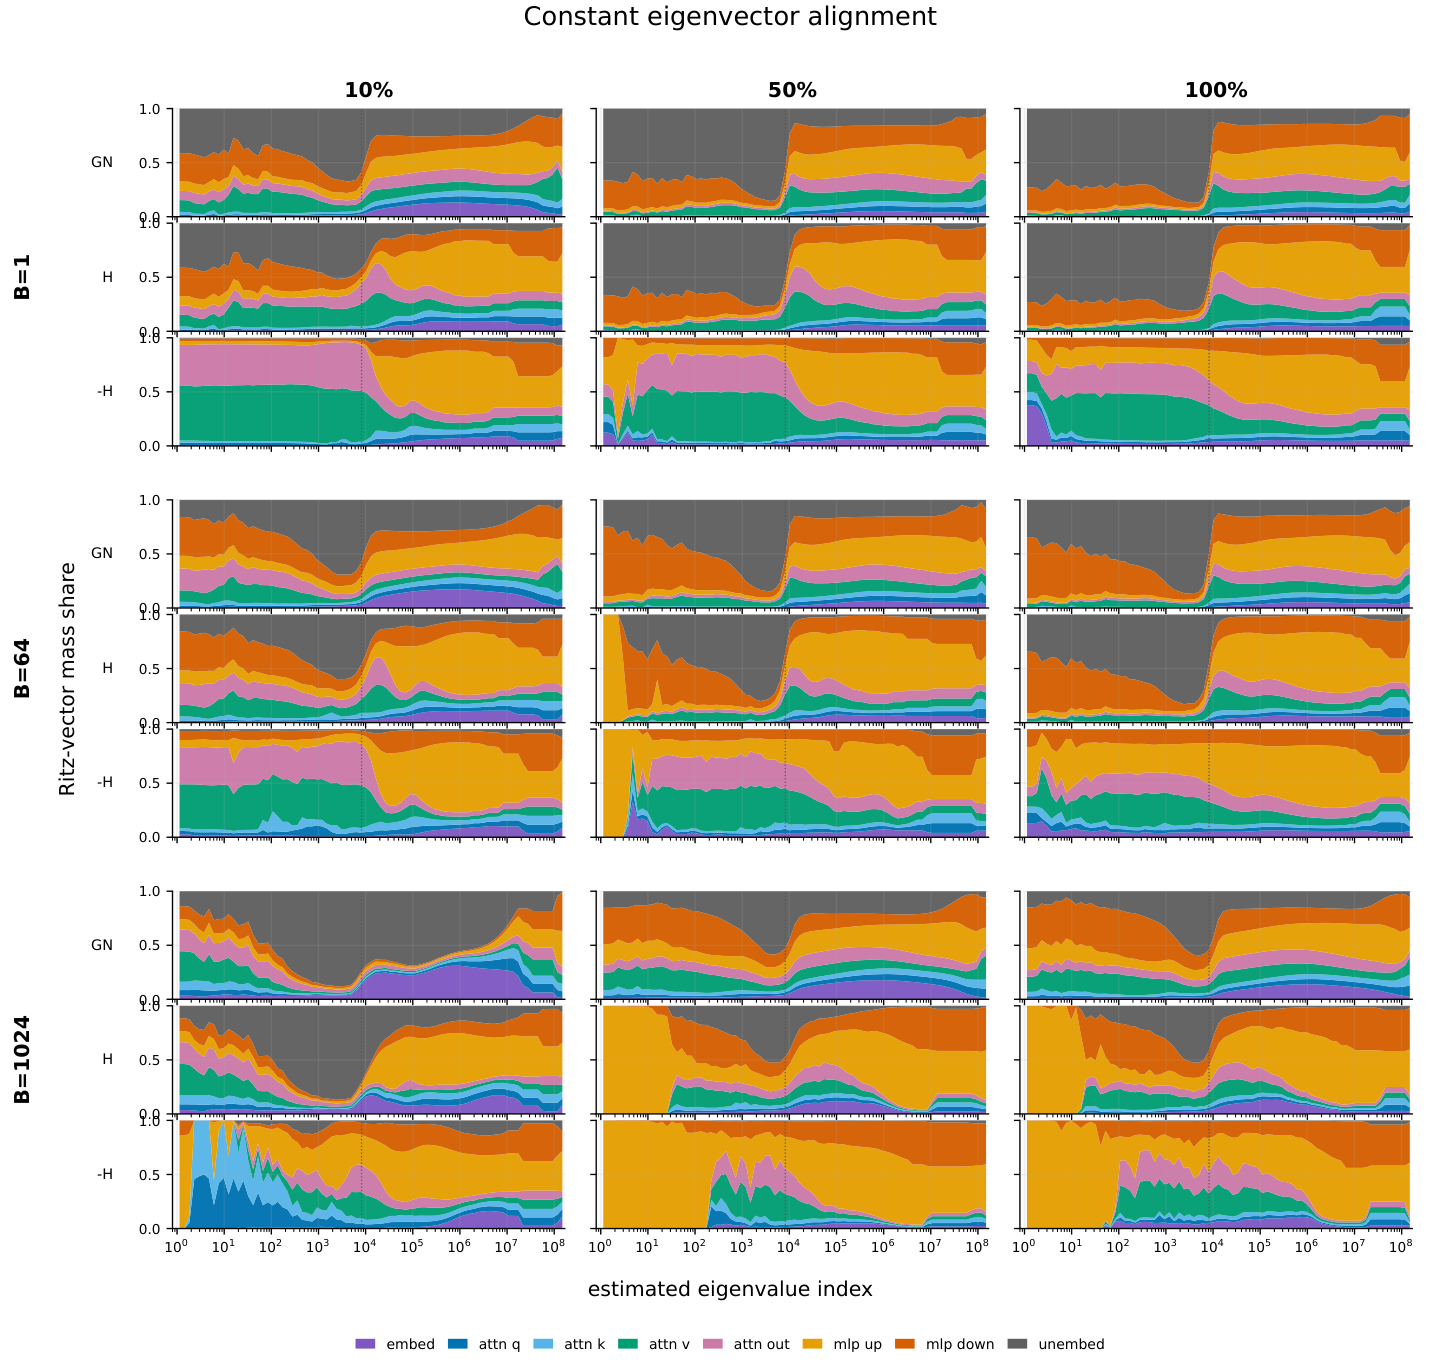
Figure 14에서도 작은 batch 머리의 출력층 비중과 큰 batch의 MLP 방향이 눈에 띈다. 그러나 그림별 정확한 비율을 읽을 수 있는 별도 표는 없으므로 ‘몇 % 증가했다’는 숫자를 만들지 않는다. spectrum 구조가 닮았다는 것과 같은 고정 이차식으로 미래 학습을 예측할 수 있다는 것은 서로 다른 주장이다.
8.3 Constant learning rate의 spectrum
Figure 13은 Figure 2와 같은 비교를 일정한 learning rate에서 수행한다. batch와 시점, GN/H, Adam/raw라는 구분은 그대로다. 후반의 긴 꼬리와 GN/H 사이 차이는 계속 나타나지만, 큰 batch의 상위 Hessian 값과 시점별 높이는 달라진다.
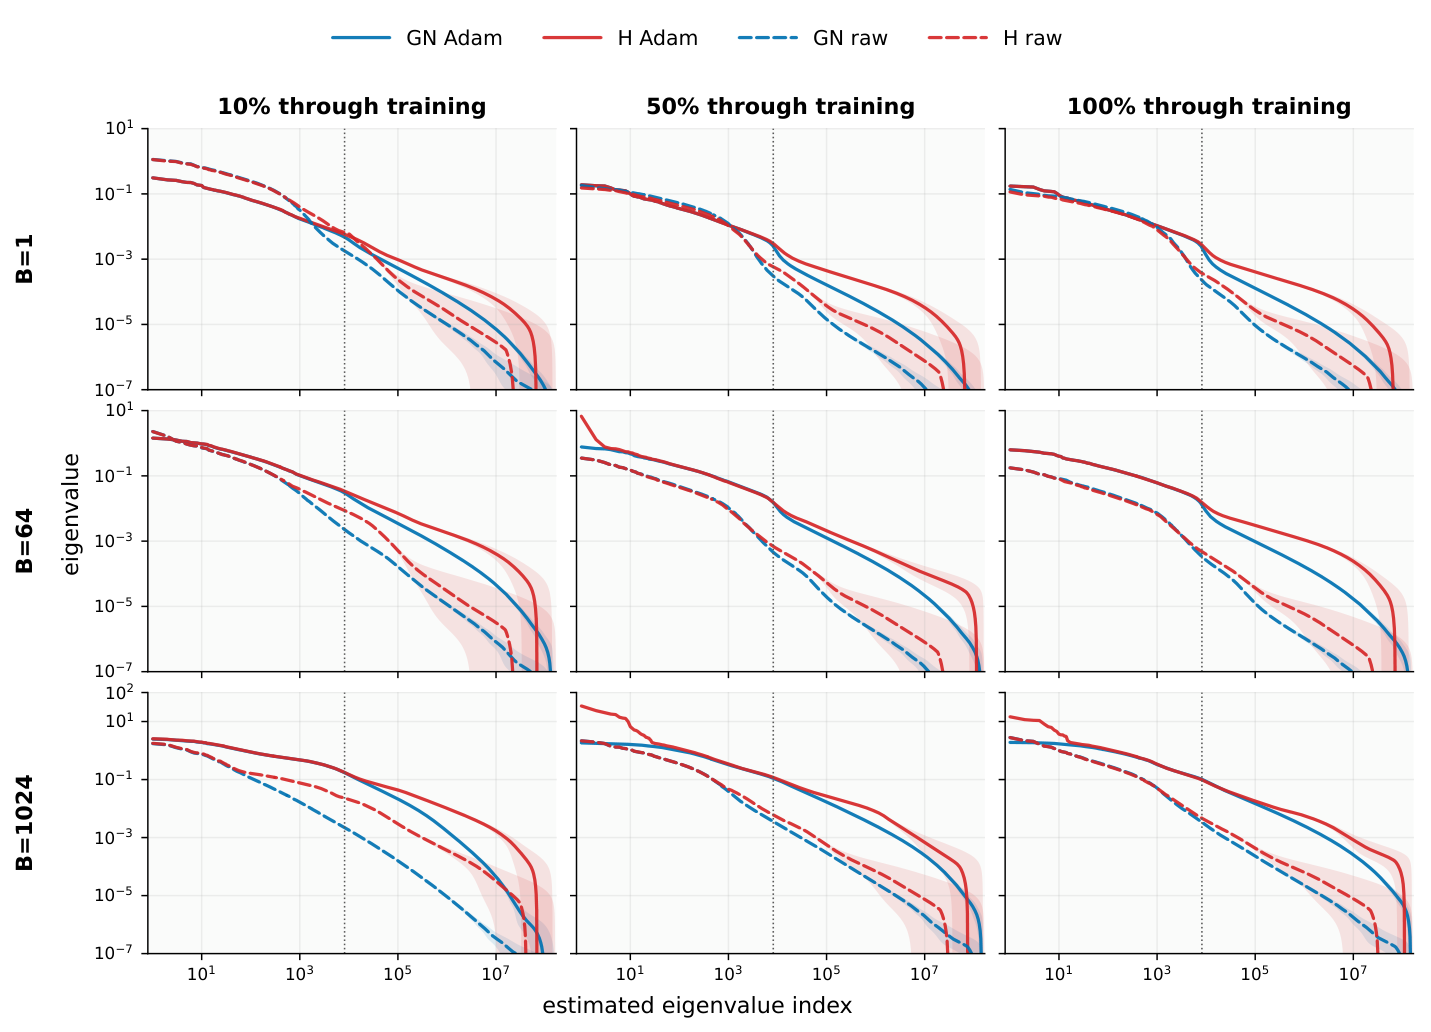
Constant learning rate에서도 curvature spectrum의 큰 구조는 관찰되지만, 앞의 loss trajectory 근사는 같은 수준으로 유지되지 않는다. 이 대조가 보여주는 핵심은 한 시점의 spectrum 형태만으로 이후 학습 경로의 예측력을 결정할 수 없다는 것이다. Curvature가 앞으로 어떻게 변하는지와 남은 오차의 분포도 함께 봐야 한다.
이 부록 대조가 중요한 이유는 좋은 결과를 낸 cosine schedule만 보고 ‘curvature 모양을 알았으니 학습도 예측했다’고 결론 내리지 않게 하기 때문이다. 한 순간의 eigenvalue 분포는 이후 curvature 자체가 어떻게 변하는지까지 말해주지 않는다.
9. Source condition: 작은 curvature 방향에 남은 오차
9.1 작은 eigenvalue가 loss 감소에 중요한 이유
평평한 방향은 한 번 움직였을 때 loss가 잘 변하지 않는다. 그렇다고 중요하지 않은 방향은 아니다. 그 방향의 바닥까지 아주 멀리 떨어져 있다면 줄일 오차가 많이 남아 있을 수 있다. 볼록 quadratic function의 고유방향 에서 남은 loss는 다음처럼 쓸 수 있다.
는 그 방향의 gradient, 는 그 방향의 curvature다. 예를 들어 gradient가 같다면 curvature가 작은 방향일수록 quadratic function의 바닥까지 남은 loss가 크다. 이 식을 음의 eigenvalue에 그대로 적용해 양의 ‘남은 오차’로 해석해서는 안 된다. 논문의 Hessian source 분석도 양의 eigenvalue 쪽을 따로 본다.
저자들은 gradient 방향의 Lanczos 결과에서 누적량을 추정하고, 순위 주변 구간을 매끄럽게 한 뒤 미분해 방향별 양을 얻는다. 미분은 오차를 증폭시키므로 꼬리 끝의 작은 요동까지 실체로 읽지 않는다.
9.2 Curvature exponent와 source-condition exponent의 차이
Figure 5는 학습 끝에서 가 eigenvalue 순위에 따라 어떻게 줄어드는지 보여준다. 이 감소 지수를 라고 하면, 앞의 curvature 감소 지수 와 구별해야 한다.
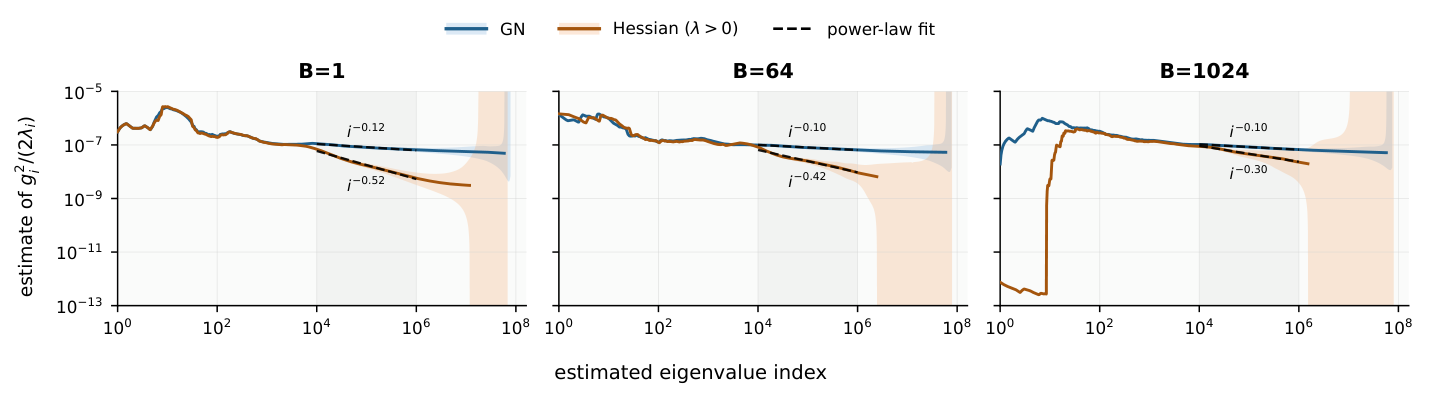
GN의 는 batch 1·64·1024에서 각각 0.12·0.10·0.10이다. Hessian의 양의 방향은 0.52·0.42·0.30이다. 둘 다 1보다 작지만 GN 쪽이 훨씬 천천히 감소한다. 순위가 큰 수많은 평평한 방향에도 남은 오차가 분산돼 있다는 해석이다.
일부 이론은 방향별 남은 오차의 합이 잘 수렴하도록 같은 조건을 둔다. 이 실험의 관찰 가능한 구간은 그 가정과 맞지 않는다. 그렇다고 유한한 168M 모델의 유한한 측정으로 무한 차원의 합이 발산한다고 증명한 것은 아니다. 이 결과는 현실적인 측정 범위에서 너무 강한 source 가정을 조심해야 한다는 근거다.
9.3 Checkpoint·learning rate schedule별 남은 오차
Figure 11은 cosine schedule에서 초기·중간·끝을 나눈다. GN의 지수는 batch 1에서 0.29→0.13→0.12, batch 64에서 0.31→0.13→0.10, batch 1024에서 0.17→0.13→0.10이다. 초기보다 후반에 감소가 더 완만해진다.
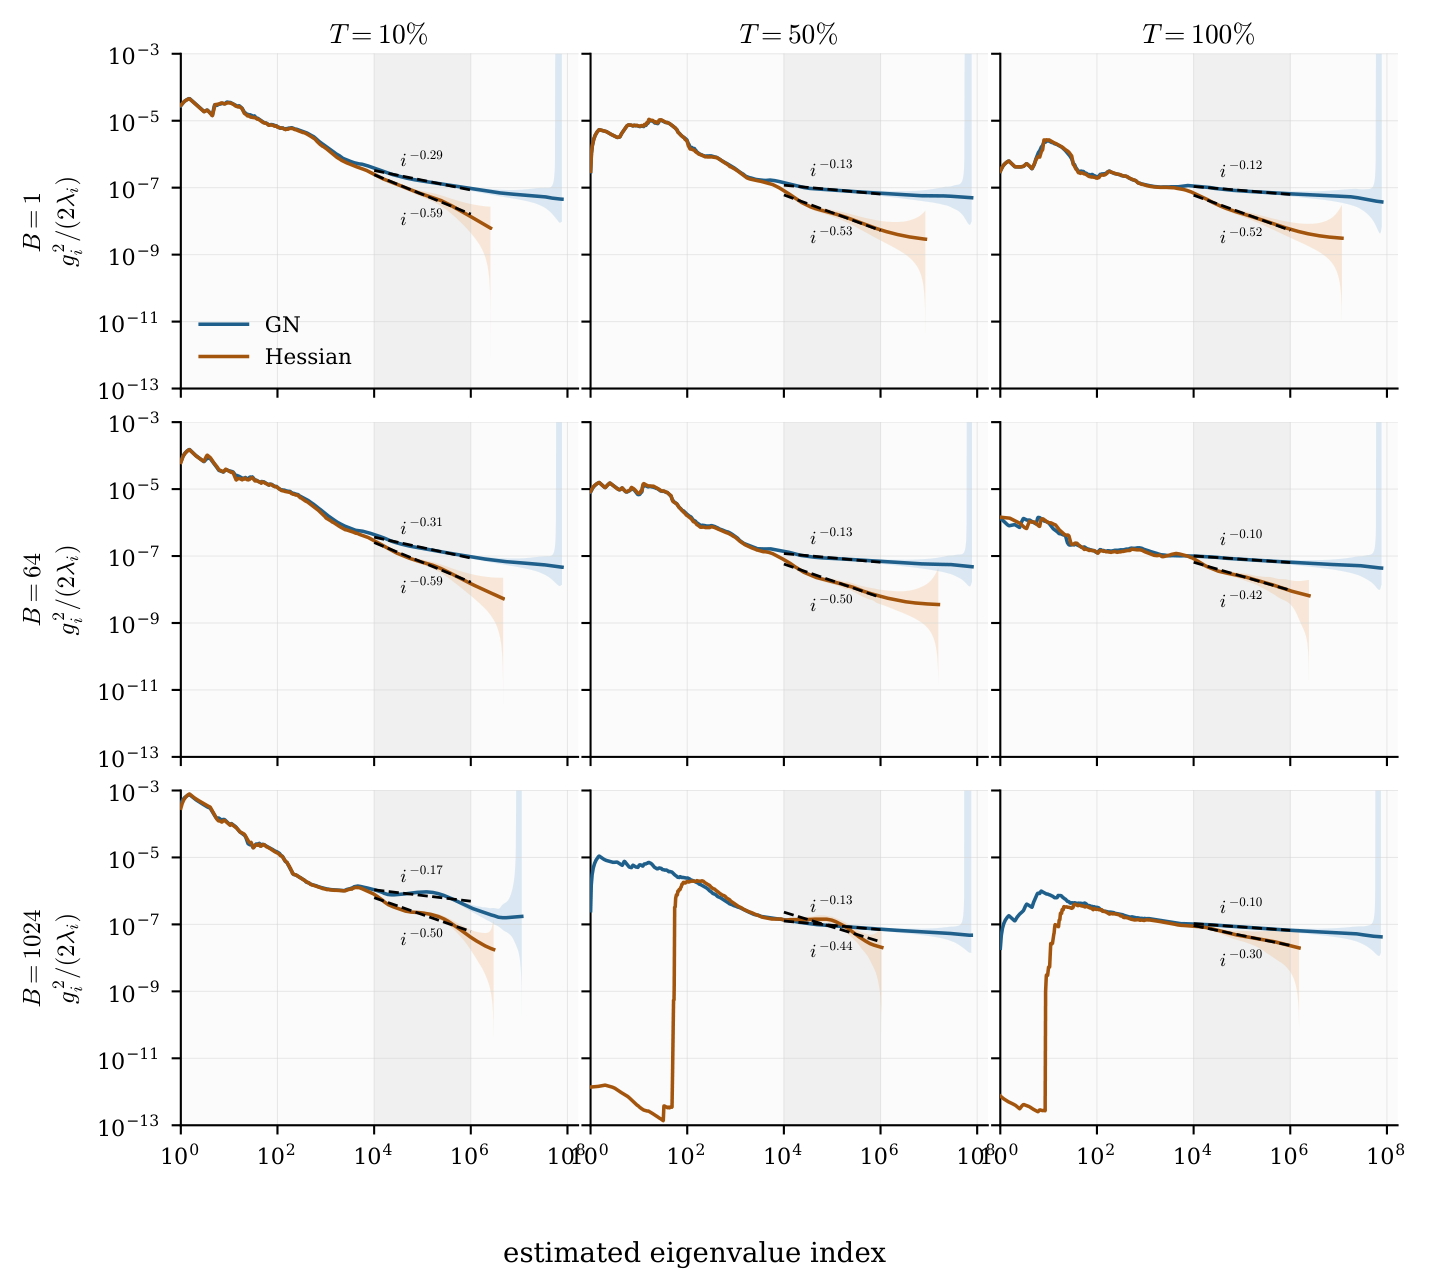
양의 Hessian 지수는 같은 순서로 batch 1이 0.59→0.53→0.52, batch 64가 0.59→0.50→0.42, batch 1024가 0.50→0.44→0.30이다. GN보다 빠르게 줄지만 이 역시 1보다 작다. 큰 batch의 초기 순위 부분에서 급격히 솟는 형태는 음의 방향을 제외하고 양의 부분을 보는 조건과 함께 해석해야 한다.
Figure 15는 일정한 learning rate의 비교다. 여기서는 GN 지수가 batch 1에서 0.28→0.16→0.20, batch 64에서 0.32→0.17→0.20, batch 1024에서 0.32→0.17→0.16이다. cosine과 달리 두 작은 batch는 중간보다 마지막 지수가 다시 커진다. ‘시간이 갈수록 항상 감소한다’는 설명은 이 부록과 맞지 않는다.
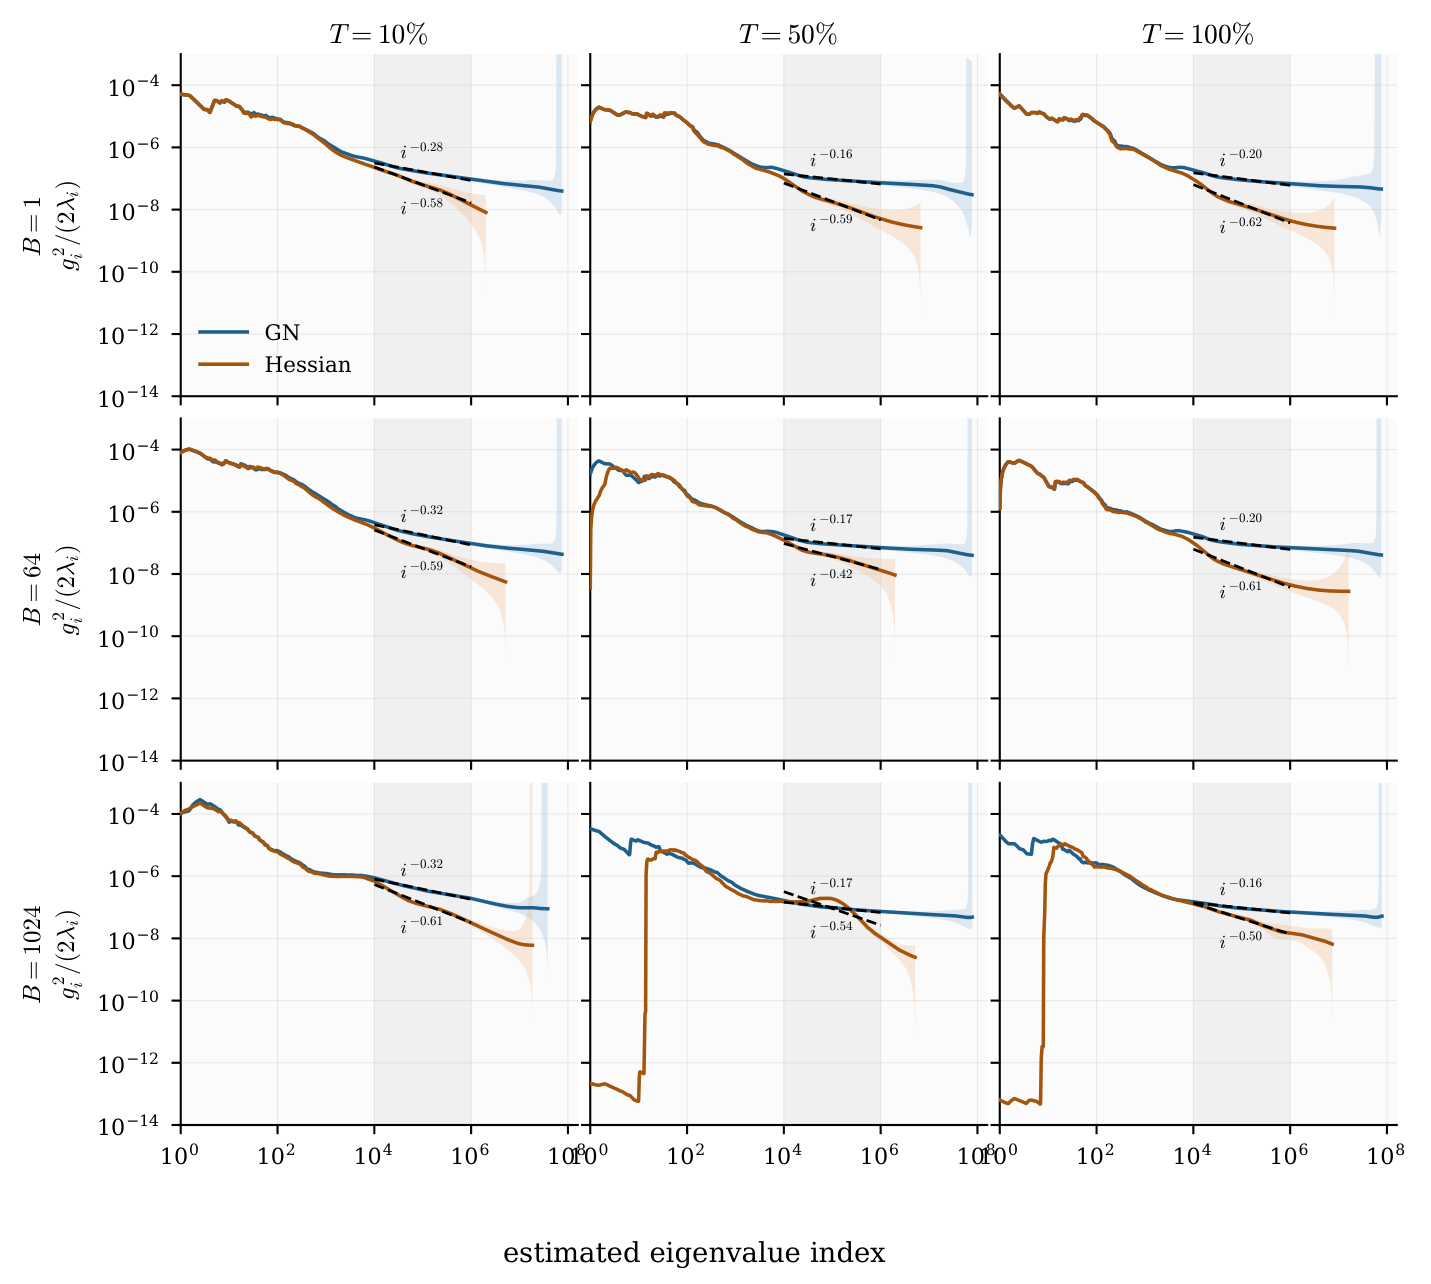
일정한 learning rate의 양의 Hessian 지수는 batch 1이 0.58→0.59→0.62, batch 64가 0.59→0.42→0.61, batch 1024가 0.61→0.54→0.50이다. 서로 다른 시간 변화가 있지만 1보다 작은 값이라는 핵심 관찰은 유지된다. 이는 일정에 완전히 무관한 동일한 수치 법칙이 아니라, 이론 가정과 대조할 수 있는 반복된 정성적 패턴이다.
10. 학습 안정성: learning rate와 batch size의 영향
10.1 같은 learning rate에서 batch를 줄였을 때의 안정성
전체 데이터의 평균 gradient를 매번 계산하면 업데이트 방향이 일정하다. minibatch는 일부 데이터만 뽑으므로 방향이 흔들린다. batch를 늘리면 이 흔들림이 줄지만, 평균 지형에서 너무 크게 움직이는 문제까지 해결하지는 못한다. 그래서 안정성에는 learning rate 자체의 크기와 learning rate 대비 batch size가 함께 관여한다.
논문은 확률적 흔들림의 세기를 보는 좌표로 를 사용한다. 작은 batch에서는 같은 비율을 유지하는 선을 따라 안정성 경계가 나타날 수 있고, 충분히 큰 batch에서는 batch를 더 늘려도 넘을 수 없는 learning rate 상한이 나타날 수 있다.
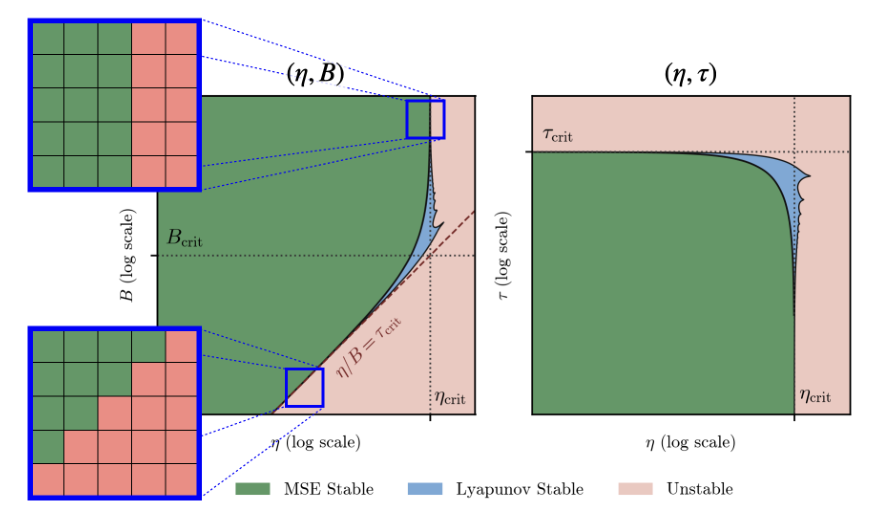
Figure 6은 실제 LLM의 성능 측정이 아니라 이론을 이해하기 위한 예시다. 왼쪽의 작은 batch 구간에서는 learning rate를 키울 때 batch도 같이 키워야 안정 영역에 남는다. 큰 batch 구간에서는 수직선에 가까운 learning rate 경계가 생긴다. 오른쪽은 같은 현상을 와 로 바꿔 보아 둥근 사각형처럼 읽을 수 있게 한다.
이 모양의 근거를 보려면 최적점에서 떨어진 거리의 평균제곱이 한 번의 업데이트로 어떻게 바뀌는지 추적한다. 그 방향별 정보를 담은 행렬을 , minibatch의 curvature를 라고 하자. 논문이 사용하는 이차 문제의 관계는 다음과 같다.
는 항등 행렬이고, 는 최적점에서도 minibatch에 따라 남는 gradient 잡음의 covariance이다. 는 기존의 방향별 흔들림을 다음 단계로 전달하는 연산자이며, 는 매번 새로 더해지는 잡음이다. 전달 연산이 이전 흔들림을 계속 증폭하면 새 잡음까지 쌓여 발산할 수 있다. Proposition 1이 다루는 엄격한 안정 영역은 이 연산자의 가장 큰 eigenvalue가 1보다 작은 조건이다.
첫 식은 batch의 무작위 curvature까지 포함한 기준이다. 둘째 식은 평균 curvature 가 정하는 최대 learning rate로, full-gradient descent의 상한과 같다. temperature 상한 는 minibatch curvature들이 얼마나 비슷한지에도 의존하므로 최대 eigenvalue 하나만으로 정해지지 않는다. 원문의 일반 설명에는 경계값 1 이하라는 표현도 있지만, 잡음이 있는 경계에서의 수렴을 무조건 보장하는 것으로 읽지 않고 여기서는 Proposition 1의 엄격한 1 미만 영역을 사용한다.
이 mean-square stability 영역은 와 를 각각 줄이는 방향으로 단조롭다. 이미 안정적인 설정에서 두 값을 모두 줄이면 안정 영역 안에 남는다. 반면 논문은 Lyapunov 안정 영역이 같은 단조성이나 연결성을 갖지 않을 수 있다고 설명한다. 특히 실험에서 는 안정적인데 는 그렇지 않은 사례를 관찰했다. 이 변화는 를 유지하며 만 줄이는 것이므로, mean-square stability 영역의 단조성으로 설명하기 어렵다. 다만 유한한 탐침에서 본 패턴을 무한 시간의 안정성 증명으로 바꾸어서는 안 된다.
10.2 Mean-square stability와 Lyapunov stability의 차이
논문이 구별하는 첫 번째 기준은 mean-square stability이다. 여러 무작위 실행을 평균냈을 때 parameter 크기의 제곱이나 loss가 폭발하지 않는지를 본다. 두 번째는 Lyapunov stability으로, 여기서는 로그 크기의 기댓값이 장기적으로 무한히 커지지 않는지를 보는 정의를 사용한다. 일반적으로 모든 개별 경로가 0으로 수축해야 한다는 뜻은 아니다. 드물게 엄청나게 커지는 경로가 제곱의 평균을 지배하면 두 기준의 판단이 다를 수 있다.
논문에 등장하는 간단한 예로 이를 확인할 수 있다. 매번 같은 확률로 또는 를 골라 learning rate 1로 한 번 업데이트한다고 하자. 첫 번째를 고르면 다음 값은 0, 두 번째를 고르면 가 된다. 한 번이라도 첫 번째가 나오면 이후에는 계속 0이다. 무한히 두 번째만 나올 확률은 0이므로 거의 모든 경로는 결국 0에 도달한다.
그러나 처음 번 모두 두 번째를 고를 확률은 이고, 그 경로의 제곱 크기는 이다. 따라서 평균은 다음과 같다.
대부분의 경로는 사라지는데 평균제곱은 커진다. 이 예는 실제 LLM에서 발생 빈도를 측정한 실험이 아니라, 안정성 정의가 왜 다른지 보여주는 이차 문제다. 열 개의 실행에서 모두 괜찮았다고 장기 평균 loss의 안정성을 증명할 수 없는 이유도 여기 있다.
10.3 Checkpoint별 stability probe와 outlier 제거 조건
안정성 실험은 앞의 Adam continuation과 또 다르다. EMA parameter에서 quadratic approximation을 만들고, EMA로 얻은 좌표별 조정값을 고정한 상태에서 stochastic gradient update를 진행한다. learning rate와 batch를 각각 기준의 1/4·1/2·1·2·4배로 바꾸며, 총예산의 10%만큼 계속하거나 발산할 때 멈춘다. batch 1에는 1보다 작은 batch가 불가능하므로 batch 축이 세 값뿐이다. 각 칸은 데이터 순서를 바꾼 열 개의 seed다.
원문은 loss가 100에 도달하면 발산으로 정의하고, 임계값을 10부터 사이에서 바꾸어도 그림이 안정적이라고 서술한다. 여기서 ‘안정적’이라는 말은 그 임계값 선택에 대한 그림의 모양을 뜻하며 모든 학습 실행이 안정적이라는 뜻이 아니다.
이 실험에는 중요한 데이터 처리 조건이 있다. 좌표별 조정값을 고정하면 드물게 등장하는 token의 방향에서 아주 큰 업데이트가 생길 수 있다. 오랫동안 갱신되지 않은 방향의 두 번째 moment가 작아졌다가, 다시 그 token이 나타날 때 작은 분모로 나누는 상황을 생각하면 된다. 저자들은 sequence별 preconditioned Gauss–Newton 행렬의 Frobenius 노름이 큰 상위 1%의 이상치를 제거했다. 제거하지 않으면 많은 설정에서 loss 스파이크와 발산이 나타난다고 보고한다.
이 조건은 결과에 곁들이는 사소한 구현 주석이 아니다. 아래 그림은 원래 데이터 전체에서 무조건 성립하는 안정성 보장이 아니라 이상치를 걸러낸 고정 curvature 문제의 결과다. 정확한 제거 효과의 전후 숫자 표는 제시되지 않으므로 개선율을 만들어 쓰지 않는다.
10.4 Learning rate를 절반으로 줄였을 때 batch별 stability 변화
작은 batch의 왼쪽 위 패널들을 보면 batch를 늘릴수록 더 큰 learning rate를 허용하는 대각선 모양이 보인다.
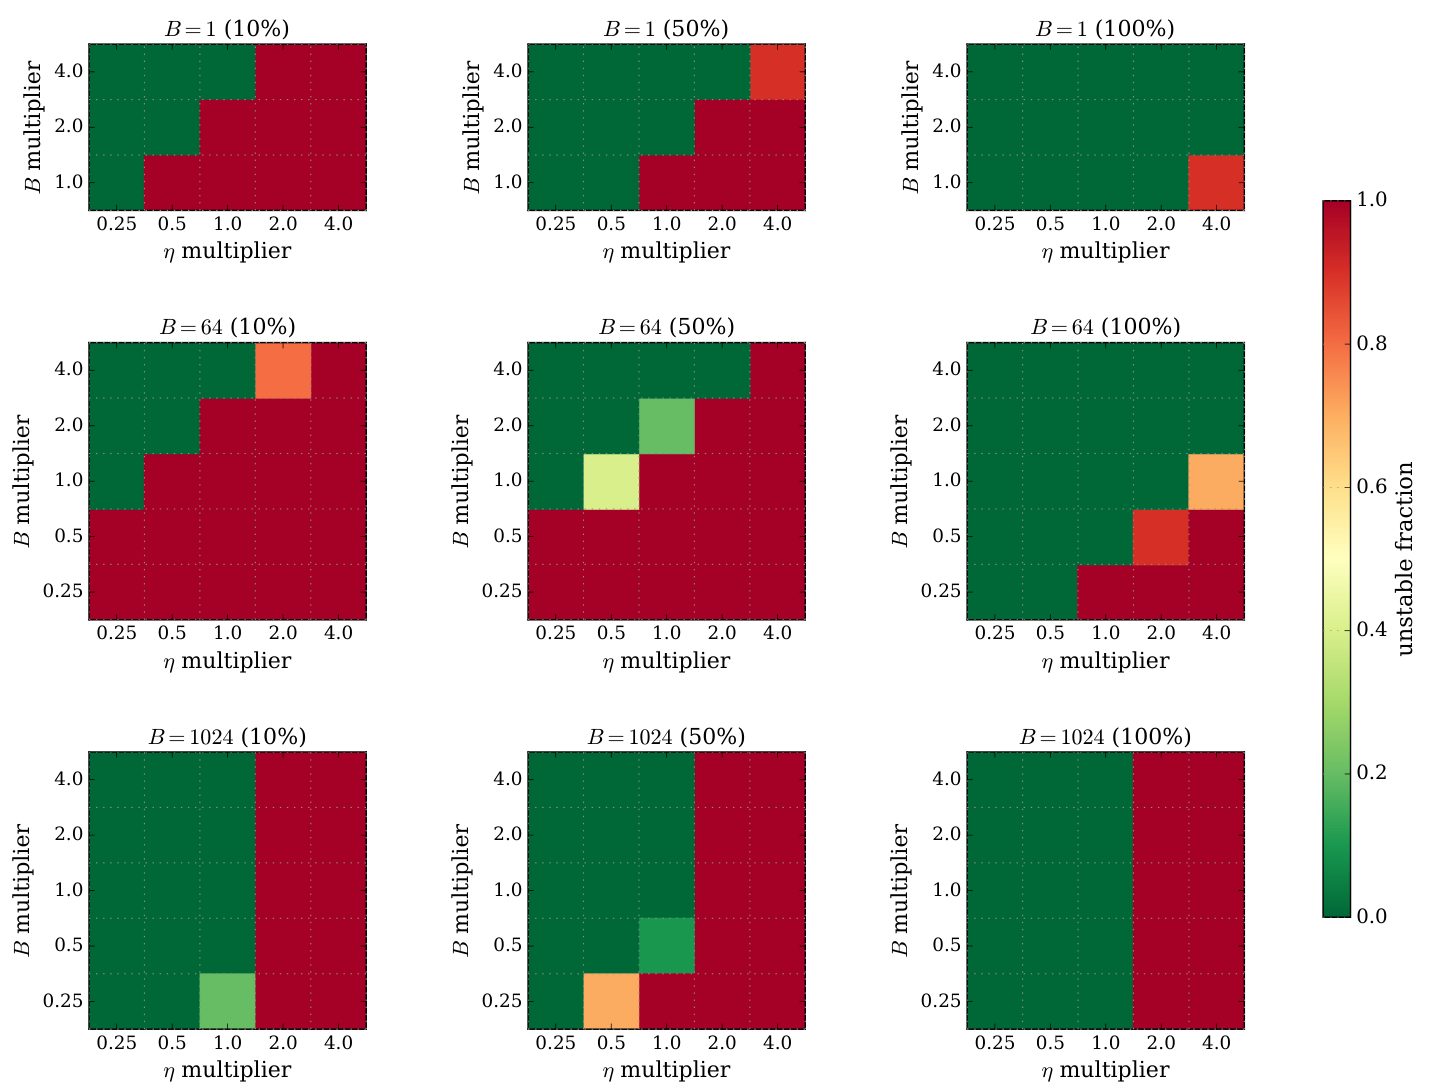
batch 1024의 아래쪽 패널들은 batch를 늘려도 learning rate 2배 부근부터 빨간색으로 바뀌는 수직 경계가 강하다. 작은 batch에서는 확률적 흔들림, 큰 batch에서는 평균 지형의 curvature 상한이 중요하다는 이론적 그림과 대체로 맞는다. 유한한 seed와 관측 길이의 결과라는 조건은 남는다.
원문·그림·공개 데이터 사이의 불일치가 있다. 본문 17쪽은 learning rate 배율 0.5, batch 배율 1인 칸이 항상 안정적이라고 주장한다. 그러나 Figure 7의 batch 1·10% checkpoint에서 그 칸은 빨간색이다. 공개 eos_cosine.csv의 같은 설정도 seed 10개 중 10개가 불안정, 비율 1.0으로 기록돼 있다. 따라서 이 글은 ‘learning rate를 절반으로 줄이면 모든 경우 안정적’이라는 문장을 사실로 재사용하지 않는다. 저자들이 이 불일치를 정정했는지는 검토한 버전과 커밋에서 확인하지 못했다.
공개 CSV의 기준도 원문과 다르다. CSV에는 unstable_ratio_threshold=4.0이 있고, 그림 코드는 저장된 unstable_fraction을 그대로 그린다. 절대 loss 100 기준을 다시 계산하는 코드가 아니다. 두 기준에서 모든 칸이 일치한다고 단정할 수 없다. 위의 batch 1 초기 반례에는 매우 큰 loss 스파이크가 기록돼 있지만, 그것만으로 전체 실험의 기준 차이가 해소되는 것은 아니다.
저자들이 강조한 ‘안정성 경계의 두 배 이내에서 작동한다’는 해석은 이 점검과 함께 읽어야 한다. 경계가 batch와 학습 시점에 따라 달라지고 전체 그림은 이론과 유사한 패턴을 보이지만, 모든 셀에 대한 보편적 상한은 공개 자료의 불일치를 해소한 뒤 다시 판단해야 한다.
10.5 Constant learning rate에서 large-batch 안정성
Figure 16의 batch 1024 패널은 learning rate가 큰 오른쪽에서 발산하지만, batch 배율을 1/4로 줄이면 더 작은 learning rate에서도 불안정해진다.
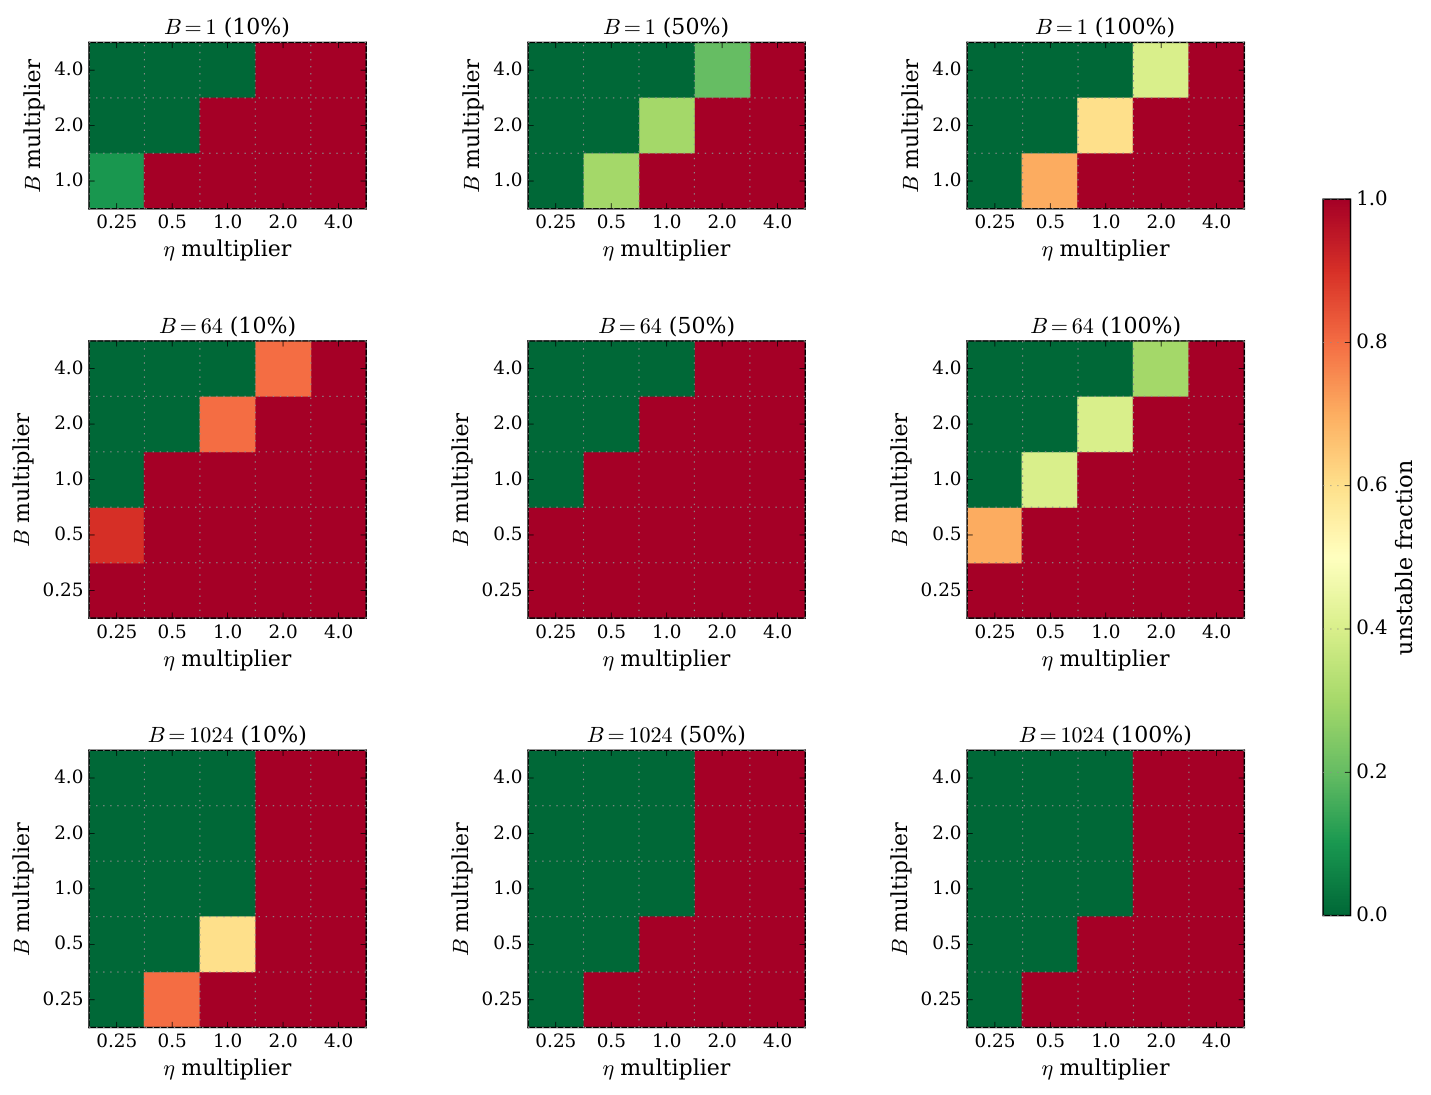
큰 기준 batch라는 이유만으로 확률적 요인을 모두 무시할 수 없다는 뜻이다. 따라서 ‘작은 batch는 확률적, 큰 batch는 결정적’이라는 이분법보다, 현재 위치가 두 경계 중 어디에 가까운지 보는 것이 정확하다.
이 대조는 선행 연구의 짧은 안정성 탐침을 읽는 데도 도움을 준다. 같은 50스텝이라도 batch가 작으면 훨씬 적은 token을 본다. 저자들은 작은 batch의 탐침을 고정 step 수로 비교하면 드문 불안정성을 놓칠 수 있다고 지적한다. 이는 관측 예산을 token 수로 맞춰야 한다는 논거이지, 모든 선행 결론이 틀렸다는 증명은 아니다.
11. Curvature 측정 검증: token 수·Lanczos 깊이·수치 오차
11.1 Curvature 측정 token 10M·100M 비교
Figure 17은 학습 종료 시점의 preconditioned Gauss–Newton spectrum을 1천만 token과 1억 token으로 추정한 비교다. 모델 checkpoint와 sequence 길이는 고정하고 curvature 측정 데이터 양을 바꾼다. 학습 batch를 열 배 늘리는 실험이 아니다.
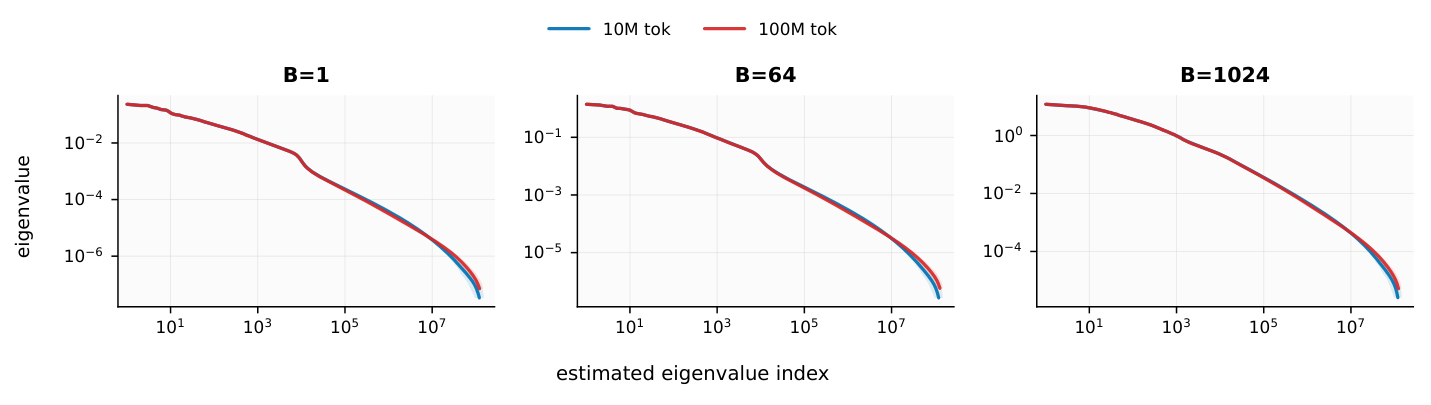
세 패널 모두 두 곡선이 대부분 겹친다. 가장 작은 값 쪽에서는 약간의 차이가 보이지만, 주요 꼬리 구조가 1천만 token의 표본 잡음만으로 생긴 것은 아니라는 근거다. 이 결과를 바탕으로 저자들은 나머지 curvature 실험에 1천만 token을 사용한다. 다만 이 대조는 학습 종료의 preconditioned GN에 대해 제시됐다. 전체 Hessian, 모든 시점, 모든 데이터 분포에서 같은 표본 수가 충분하다고 확장하지 않는다.
11.2 Lanczos reorthogonalization·precision 대조 실험
| 바꾼 조건 | 유지한 비교 대상 | 관찰 | 허용되는 해석 |
|---|---|---|---|
| 출력 선형화 후 loss까지 이차화 | 같은 checkpoint·학습 상태 | 초기 quad가 더 빨리 벗어나는 경우 | 추가 근사로 잃는 정보가 있다 |
| cosine과 일정한 learning rate | 모델 계열·예산·평가 방식 | 일정한 learning rate는 후반도 근사 실패 | 일정과 학습 경로가 유효성에 관련된다 |
| curvature 추정 10M→100M token | 종료 checkpoint의 preconditioned GN | 대부분의 spectrum이 일치 | 해당 측정의 표본 수 선택을 지지한다 |
| 3항 점화와 전체 재직교화 | Lanczos의 목표 curvature 정보 | 짧은 점화는 약 100단계에서 정확도 문제 | 깊은 꼬리 분석에는 수치 안정성이 중요하다 |
| 기저 float16·32·64 | 같은 종류의 spectrum 계산 | 16은 악화, 32→64는 뚜렷한 이득 없음 | 이 실험에서 32비트 기저를 택할 근거다 |
첫 번째 비교는 고정한 출발점에서 근사 단계를 하나 더 넣는다. 두 번째는 학습 전체 경로가 바뀌므로 원인을 하나로 고립시키지 못한다. 마지막 두 대조는 본문에 정성적으로 보고돼 있어 정확한 오차 감소율이나 속도 향상 배수를 계산할 근거가 없다. 대조 실험이라는 이름만으로 모든 행을 동일한 수준의 인과 증거로 취급하지 않는 것이 중요하다.
저자들은 같은 계산 예산에서 무작위 시작 방향을 많이 쓰는 것보다 깊은 한 번의 탐침이 작은 eigenvalue를 보는 데 유리하다고 설명한다. 여러 얕은 탐침은 무작위 오차를 줄일 수 있지만, 깊이 부족으로 보이지 않는 꼬리를 복원하지 못한다는 이유다. 무작위 오차와 수치 해상도를 구분한 선택이며 모든 행렬에서 한 탐침이 최적이라는 보편적 권고는 아니다.
11.3 Local approximation의 한계와 공개 자료의 불일치
저자들이 강조하는 범위는 국소적 근사다. Discussion에서는 cosine schedule으로 learning rate가 줄고 안정성 경계를 벗어난 뒤 curvature가 다시 커지는 관찰을 짚는다. 모든 조건에서 curvature가 계속 커진다는 뜻은 아니다. 고정 quadratic model은 이런 curvature 변화나 안정성 경계에서 curvature 자체가 조절되는 전역적인 현상을 그대로 담지 못한다. 초기 근사의 실패와 일정한 learning rate의 실패도 근사 범위의 한계를 보여준다. 관찰된 curvature 변화의 기전을 이 논문이 모두 확정한 것은 아니며, 이상치를 걸러낸 조건도 안정성 결과에 붙어 있다.
편집팀이 자료를 대조하며 추가로 확인한 한계는 세 가지다. 첫째, 하나의 작은 모델 계열과 줄인 vocabulary에서 얻은 결과다. 둘째, continuation 실행이 탐색 최저 실행과 항상 같지 않다. 셋째, 안정성의 본문 주장·그림 셀·공개 CSV 판정 기준 사이에 차이가 있다. 이 세 가지를 해결하지 않은 채 대규모 실전 학습의 안전한 learning rate 공식을 뽑는 것은 근거를 넘어선다.
12. QuadraticModel 코드: figure 재생성과 학습 재현 조건
12.1 처리 데이터로 figure를 재생성하는 방법
검토한 커밋은 56ab979baa998da9ea1128fc8d7ba99b7adc5588이다. 저장소는 학습 코드와 curvature 측정 코드 외에, 처리된 CSV·NPY·NPZ로 보존된 PDF 그림 21개를 다시 만드는 별도 경로를 제공한다. 이 경로는 W&B 계정이나 학습 checkpoint 없이 실행하도록 구성돼 있다.
git clone https://github.com/alexandrumeterez/QuadraticModel.git
cd QuadraticModel
git checkout 56ab979baa998da9ea1128fc8d7ba99b7adc5588
python -m venv .venv-figures
# 가상환경을 활성화한 뒤 실행한다.
python -m pip install -r analysis/requirements.txt
python analysis/reproduce_figures.py --output-dir reproduced_figures
그림용 환경의 고정 버전은 Matplotlib 3.10.8, NumPy 2.4.3, pandas 3.0.2다. 저장소의 최상위 학습 환경에는 JAX CUDA 의존성 등이 추가된다. 그림만 다시 그리려는 독자는 학습용 전체 환경을 먼저 구성할 필요가 없다.
직접 실행한 범위: Windows의 별도 Python 3.11 가상환경에서 위의 그림용 고정 버전을 설치하고, 공개 스크립트가 PDF 21개를 모두 생성하는 것까지 확인했다. 처음의 공용 Python 환경에서는 NumPy와 오래된 Matplotlib의 바이너리 호환 문제로 실행되지 않아 환경을 분리했다. 본문의 실험 이미지는 재생성 파일이 아닌 원문 PDF의 그림을 사용한다.
이 경로의 성공은 제공된 처리 데이터에서 그림을 다시 만들었다는 뜻이다. 원시 데이터를 다시 학습해 같은 결과를 얻었다는 뜻이 아니다. 특히 Table 1의 근사 유효 구간을 원시 로그에서 다시 계산하거나, 안정성 판정 기준을 통일해 검증하는 작업은 그림 재생성과 별개다.
12.2 Pre-training·EMA·Lanczos 재현 설정
학습은 pretrain.py, 묶음 실행은 sweep.sh가 출발점이다. sweep.sh는 두 learning rate 일정, 일곱 batch, 다섯 기본 learning rate를 조합한 70개 실행을 구성한다. 기본 learning rate에 를 곱해 실제 배율을 정하므로 인자 하나만 보고 최종 learning rate를 판단하면 안 된다. 제공된 8192 token BPE와 데이터 샤드 순서·평가 분할도 고정해야 한다.
평가 설정도 학습 batch와 구별해야 한다. 공개 묶음 실행은 평가 batch 128, 평가 token 상한 50M, ghost_batch_size=16, 평가 지점 수 30을 전달한다. ghost_batch_size는 계산을 나누는 내부 batch 설정이므로 논문의 비교 축인 학습 batch 1·64·1024와 바꿔 쓰지 않는다. EMA는 0.04와 0.08 두 비율을 저장·평가하며, Figure 8의 지표는 그중 eval/ema_0.04다. 다른 평균화 결과를 골라 놓고 같은 최종 loss를 재현했다고 비교하면 안 된다. 데이터 순서를 결정하는 seed도 함께 보존해야 하며, 학습 코드의 기본 seed는 0이다.
opt.py의 두 번째 moment 계수는 업데이트 횟수에 따라 바뀌며, parameter EMA도 시간 비율에 맞춰 갱신된다. EMA 코드의 정확한 식은 논문의 간략한 시간 비율 설명과 완전히 같은 표기 형태는 아니다. 코드에서는 평균 비율 에 대해 를 만든 뒤 로 보간한다. 이 작은 차이를 임의로 정리한 고정 EMA 계수로 바꾸면 평가 parameter가 달라질 수 있다.
curvature 측정의 analysis/spectrum/run_basis.py는 checkpoint·설정 파일·데이터와 전처리 통계를 필요로 한다. run_basis.sh의 기본 Lanczos 깊이는 300이다. 논문의 1200단계를 재현하려면 M=1200 같은 명시적 재설정이 필요하다. 셸 파일의 기본 GPU 요청도 4개이므로 논문의 깊은 실행에서 보고한 16 H100 조건이 기본값만으로 자동 재현되지 않는다. 이 글은 저자들의 클러스터 스크립트를 다른 장비에 그대로 제출하라고 권하지 않는다.
기저는 실제 코드에서도 float32이고, 이전 방향을 빼는 루프를 두 번 수행한다. Adam 조정에서는 좌표별 learning rate와 두 번째 moment의 제곱근을 함께 사용한다. sgd 또는 raw 경로에서도 기본 좌표별 learning rate는 남으므로 비교할 행렬 이름과 좌표계를 결과 파일에 함께 기록해야 한다.
이상치 처리는 preprocessing/split_hessian_frob_q99.py가 담당한다. sequence별 curvature 통계에서 99백분위 기준을 정하고 해당 인덱스를 분리한다. 어떤 checkpoint에서 측정한 통계인지, 어떤 데이터 위치가 제외됐는지를 잃으면 같은 ‘상위 1% 제거’라고 해도 재현 결과가 달라진다. spectrum README 역시 필터링된 데이터 경로를 사용하므로 안정성 그림에만 주의사항을 적고 curvature 입력은 확인하지 않는 방식은 충분하지 않다.
12.3 Run ID·checkpoint·stability threshold 확인 순서
먼저 고정 커밋의 처리 데이터로 그림 21개가 생성되는지 확인한다. 다음으로 pretraining_sweep.csv와 linearization_eval.csv의 실행 ID를 대조해 어떤 checkpoint를 비교하는지 확정한다. 그다음 EOS CSV의 판정 기준과 원문 기준을 분리해, 원시 seed별 loss 기록이 있어야 다시 계산할 수 있는 부분을 식별한다.
전체 실험으로 나아가려면 원시 데이터, 동일한 tokenizer, 학습 설정과 checkpoint, EMA 상태, curvature 필터의 기준과 인덱스가 필요하다. 파일 하나가 존재한다고 이 조건이 모두 충족됐다고 보지 않는다. 원시 학습과 continuation·안정성 탐침을 한 명령으로 자동 재생하는 완전한 경로가 확보됐는지 별도로 확인해야 한다. 이 리뷰에서는 원시 GPU 학습을 실행하지 않았다.
13. Quadratic Model의 한계와 후속 실험
이 논문의 강점은 단순한 이차 이론이 ‘그럴듯하다’는 말에 머물지 않고, 실제 LLM parameter에서 근사 경로를 평가하고 깊은 curvature 꼬리를 측정했다는 점이다. batch와 시점, GN과 Hessian, learning rate 일정, 평균 안정성과 경로 안정성을 구분해 읽으면 복잡한 학습을 설명하는 좌표를 얻을 수 있다.
가장 강한 긍정 근거는 cosine 학습 후반의 실제 검증 loss에서 상당한 길이의 근사 유효 구간이 나타난다는 점이다. 가장 강한 유보 근거는 일정한 learning rate에서 그 구간이 사라지고, 안정성 실험의 이상치 처리와 공개 자료의 불일치가 남아 있다는 점이다. 두 근거를 함께 남겨야 제목의 ‘Defense’를 무조건적인 옹호로 오해하지 않는다.
다음 비교로 가장 유용한 것은 같은 batch에서 탐색 최저 실행과 현재 선택 실행에 동일한 continuation을 적용하는 실험이다. 이어서 안정성 임계값을 하나로 통일하고 원시 seed별 loss에서 Figure 7을 다시 계산하면, 본문의 보편적 문장과 반례 사이의 문제를 직접 해결할 수 있다. 더 큰 모델·일반 vocabulary·다른 optimizer로 확장하는 것은 그다음 단계다. 이 제안은 편집팀의 후속 실험 판단이며 논문이 이미 수행한 결과가 아니다.
인용할 때는 검토한 arXiv:2607.21716v1 사전 공개 논문과 코드 커밋을 함께 적는 편이 정확하다. 이 글의 수치와 그림 해설 역시 그 버전에 한정된다.
14. 출처
-
논문 v1과 전체 부록 PDF: Figure 1–18, Table 1, Algorithm 1–2와 실험 설명.
-
공개 코드의 고정 커밋: 학습·데이터·curvature 구현의 기준.
-
처리된 실험 데이터: learning rate 탐색, continuation 실행 ID, 안정성 비율 대조.
-
그림 재생성 코드: 보존된 PDF 21개를 만드는 진입점.
-
안정성 그림의 CSV 처리: 저장된 발산 비율을 그리는 방식.
자료 확인·수정: 2026년 9월 16일. 검토한 원문과 공개 구현의 버전은 위에 고정했다. 이번 수정에서는 전문 용어, 설명 문장, 검색 주제가 드러나는 제목과 이미지 batch를 보완했다.
관련 글
Paper Review
IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System — voice cloning·병음 발음 제어 분석
IndexTTS v1의 SEQ3 입력, Conformer·Perceiver와 BigVGAN2 구조를 설명한다. 병음 교정률 94%의 분모, CER·WER·SS·MOS와 inference 속도를 원문 figure·table과 코드로 분석한다.
Paper Review
IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech — 감정·발화 길이 제어 원리 분석
IndexTTS2의 T2S·S2M, GRL 감정 분리, GPT latent와 duration control을 설명한다. WER·SS·MOS, ablation과 공개 inference 코드의 제한을 원문 figure·table로 분석한다.
Paper Review
IndexTTS 2.5 Technical Report — multilingual TTS·GRPO 학습 분석
IndexTTS2.5의 multilingual TTS, 언어 conditioning, GRPO와 25Hz codec을 설명한다. 언어별 WER·SS, cross-lingual 감정 전이와 Zipformer·공개 DiT 구현의 차이를 분석한다.