IndexTTS 2.5 Technical Report — multilingual TTS·GRPO 학습 분석
IndexTTS2.5의 multilingual TTS, 언어 conditioning, GRPO와 25Hz codec을 설명한다. 언어별 WER·SS, cross-lingual 감정 전이와 Zipformer·공개 DiT 구현의 차이를 분석한다.
- #논문 리뷰
- #IndexTTS2.5
- #multilingual TTS
- #GRPO
- #Zipformer
- #voice cloning
원문: Yunpei Li 외 bilibili 연구진, IndexTTS 2.5 Technical Report. arXiv:2601.03888v5, 2026년 8월 11일 개정, 전체 12쪽을 읽고 작성했다. 최초 공개일은 2026년 1월 7일이다. 이 글은 해당 기술 보고서를 대상으로 하며 별도의 학회 게재 논문이라고 소개하지 않는다.
논문 정보 · 원문 PDF · 검토한 코드 · 고정한 모델 설정
그림 4개와 표 6개를 원문에서 직접 발췌하고, 복잡한 그림·표는 설명에 맞춰 확대 발췌를 덧붙였다. 원문의 배포 조건은 arXiv 비독점 배포 라이선스다. 각 도판에 원문 위치와 출처를 표시했다. 실험값은 저자들이 보고한 값이다. 이 글에서는 코드와 설정을 읽어 대조했으며 모델의 weight를 내려받거나 음성을 생성해 성능을 다시 측정하지 않았다.
1. IndexTTS2.5 contributions: 다국어 생성·GRPO·RTF 개선
IndexTTS2.5는 세 contributions를 제시한다. 첫째는 multilingual data-curation pipeline과 세 language conditioning 전략으로 다섯 언어의 생성과 cross-lingual 전이를 다루는 것이다. 둘째는 50Hz→25Hz semantic codec과 Zipformer S2M을 함께 적용하는 efficiency optimization이다. 셋째는 GRPO post-training으로 semantic token 생성의 WER와 prosody를 개선하는 것이다. 데이터 준비와 모델 조건을 먼저 이해한 뒤, 후속 학습과 속도 개선을 구분해 읽는다.
다국어 기본 모델에 GRPO를 적용하면 다섯 언어 평균 WER가 6.75%에서 6.00%로 0.75%p 감소하고, 평균 SS는 73.18에서 73.63으로 증가한다. 중국어 reference에서 다른 네 언어를 생성하는 cross-lingual 평가에서는 평균 WER 6.22%→6.17%, SS 68.62→70.20이다. 이 결과는 language conditioning과 후속 학습이 겨냥한 다국어 생성 능력을 보여준다. 언어별로는 WER와 SS가 반대 방향으로 변한 경우도 있으므로 뒤에서 각 방향을 구분한다.
효율 측면에서는 논문이 보고한 T2S·S2M의 합산 RTF가 0.310에서 0.136으로 낮아져 약 2.28배의 비율 차이를 보인다. 이 결과를 이해하려면 token 수를 반으로 줄이는 변경과 S2M backbone 변경을 나눠 봐야 한다. 이는 논문 구성의 모듈별 측정이며 서비스 전체 latency나 현재 공개 DiT 코드의 실측값은 아니다.
본문은 언어 데이터와 평가 조건 → language conditioning의 비교 → GRPO와 cross-lingual·emotion 결과 → codec·S2M의 속도 개선으로 구성한다. 각 contribution의 mechanism을 먼저 배우고, 바로 이어지는 수치와 경향으로 그 효과를 확인한다.
2. TTS architecture: T2S·S2M·vocoder의 역할
2.1 Semantic token과 mel spectrogram의 차이
문자열을 입력받아 음성을 내놓는 시스템을 텍스트 음성 합성, 또는 TTS라고 한다. 여기서 다루는 zero-shot 합성은 새 화자마다 모델을 다시 학습하는 대신, 짧은 참조 녹음을 넣어 그 사람의 목소리를 따르는 방식이다. 참조 녹음 없이 모든 사람의 목소리를 안다는 뜻은 아니다.
IndexTTS 계열을 이해하려면 중간 표현 두 가지를 구분해야 한다. 의미 음성 token은 발음과 운율 등 음성의 내용을 담는 이산적인 번호의 연속이다. 글자를 token으로 나누는 것과 비슷한 발상이지만 단위는 텍스트의 단어가 아니라 음성에서 추출한 특징이다. mel spectrogram은 시간에 따른 주파수 성분을 사람이 듣는 주파수 감각에 맞춰 정리한 배열이다. token이 비교적 압축된 설계도라면, mel spectrogram은 실제 소리를 복원하기 직전의 상세 표현에 가깝다.
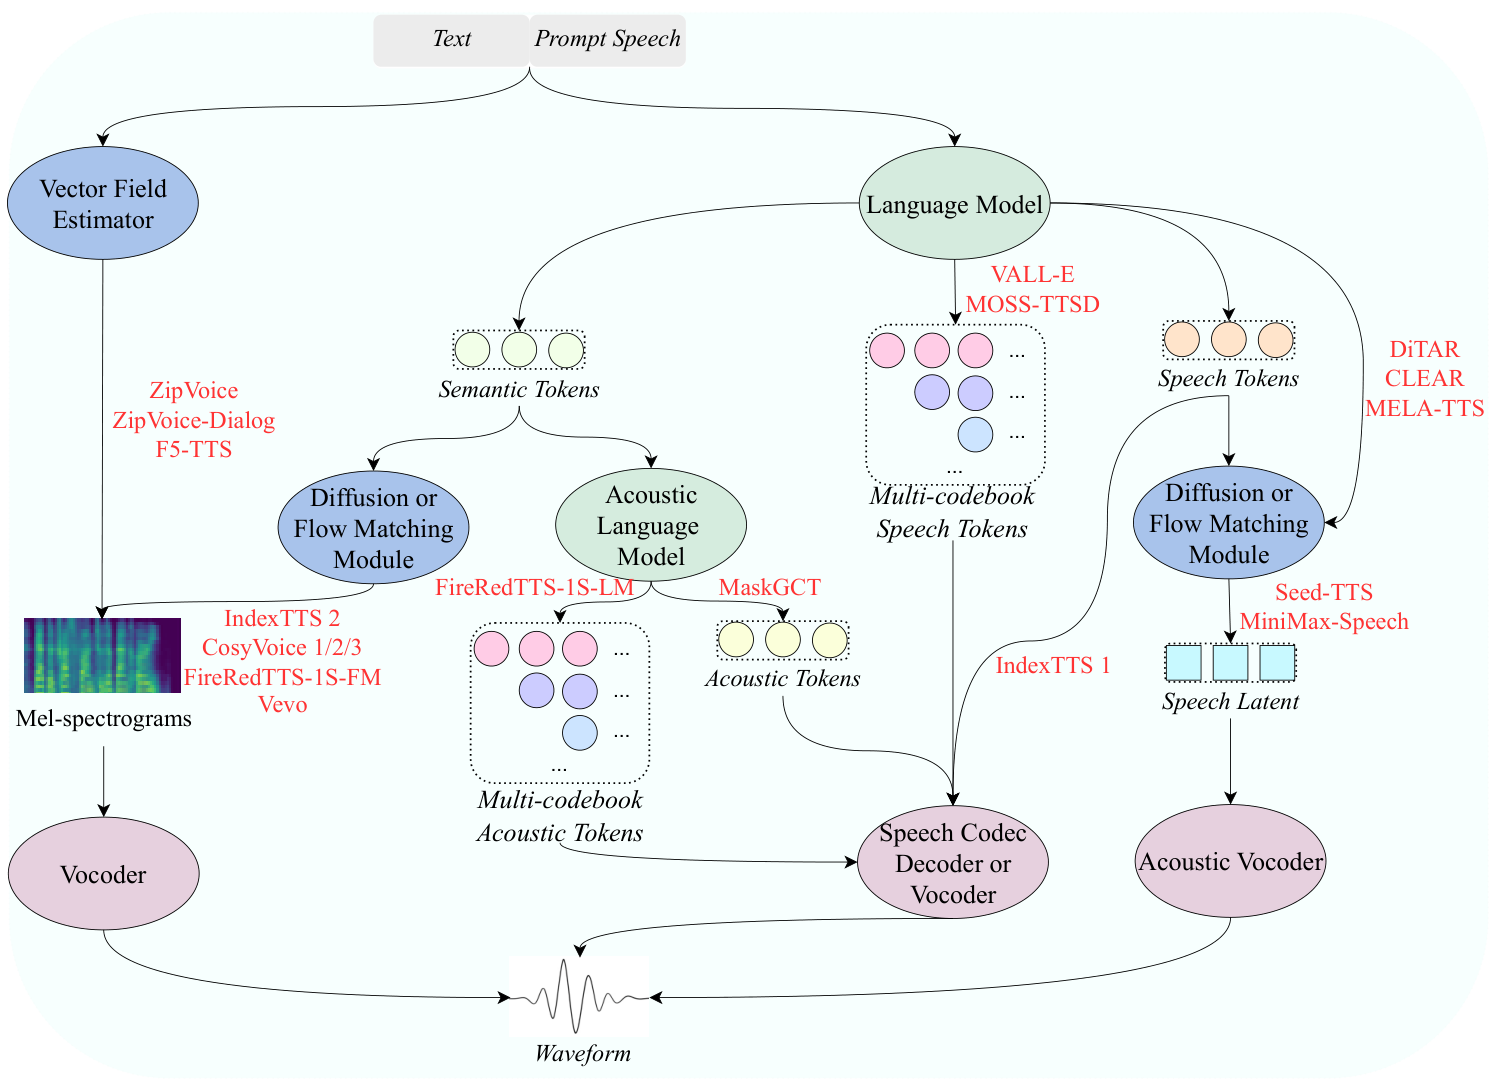
Figure 1에는 서로 다른 중간 표현을 쓰는 여러 계열이 함께 있다. 음향 codebook 여러 개를 예측해 decoder로 넘기는 경로, 음성 token에서 연속 latent representation을 복원하는 경로, 텍스트에서 mel representation을 직접 만드는 경로를 구분한다. 여기서 codebook은 연속적인 특징 vector를 대표 번호에 대응시키는 사전이다. 표현을 여러 단계로 나누면 각 단계의 길이와 계산량, 남겨야 하는 음성 정보가 달라진다.
2.2 T2S에서 S2M flow matching까지
IndexTTS2.5는 먼저 텍스트에서 의미 음성 token을 만든다. 이 단계를 T2S, text-to-semantic이라고 부른다. 언어 모델은 앞에서 만든 token을 보면서 다음 token을 순서대로 생성한다. 이어서 semantic token으로부터 mel spectrogram을 만드는 S2M, semantic-to-mel 단계를 거친다. 마지막으로 mel representation을 파형으로 바꾸는 신경망인 vocoder가 실제 오디오를 만든다.
S2M에서 사용하는 flow matching은 잡음에서 출발해 목표 음성 표현 쪽으로 이동하는 방향을 학습하는 생성 방식이다. inference에서는 그 방향을 여러 작은 단계로 따라가 mel representation을 얻는다. 여기서 이동은 물리적인 위치 변화가 아니라 고차원 배열의 값이 변하는 과정이다. semantic token은 무엇을 어떻게 말할지의 조건을 주고, 화자 참조는 어떤 목소리로 복원할지를 알려 준다.
2.5의 변경은 이 뼈대를 전부 버리는 방식이 아니다. 먼저 T2S가 언어를 혼동하지 않도록 입력과 데이터를 바꾼다. 그다음 T2S가 생성해야 하는 token 수를 줄이고 S2M을 더 가벼운 구조로 바꾼다. 마지막으로 생성 결과를 평가해 T2S가 더 나은 후보를 선호하도록 추가 학습한다. 따라서 성능을 읽을 때도 언어 조건, token 압축, 복원 구조, 후속 학습의 효과를 나눠 봐야 한다.
3. Multilingual data pipeline: VAD·ASR·음원 분리
모델 앞에는 데이터 문제가 있다. 온라인 영상에는 두 사람이 번갈아 말하거나, 배경 음악이 깔리거나, 말과 노래가 섞인 구간이 있다. 이런 구간을 그대로 한 화자의 텍스트·음성 쌍으로 넣으면 모델은 누구의 목소리인지와 어떤 글자를 읽는지부터 잘못 배울 수 있다.
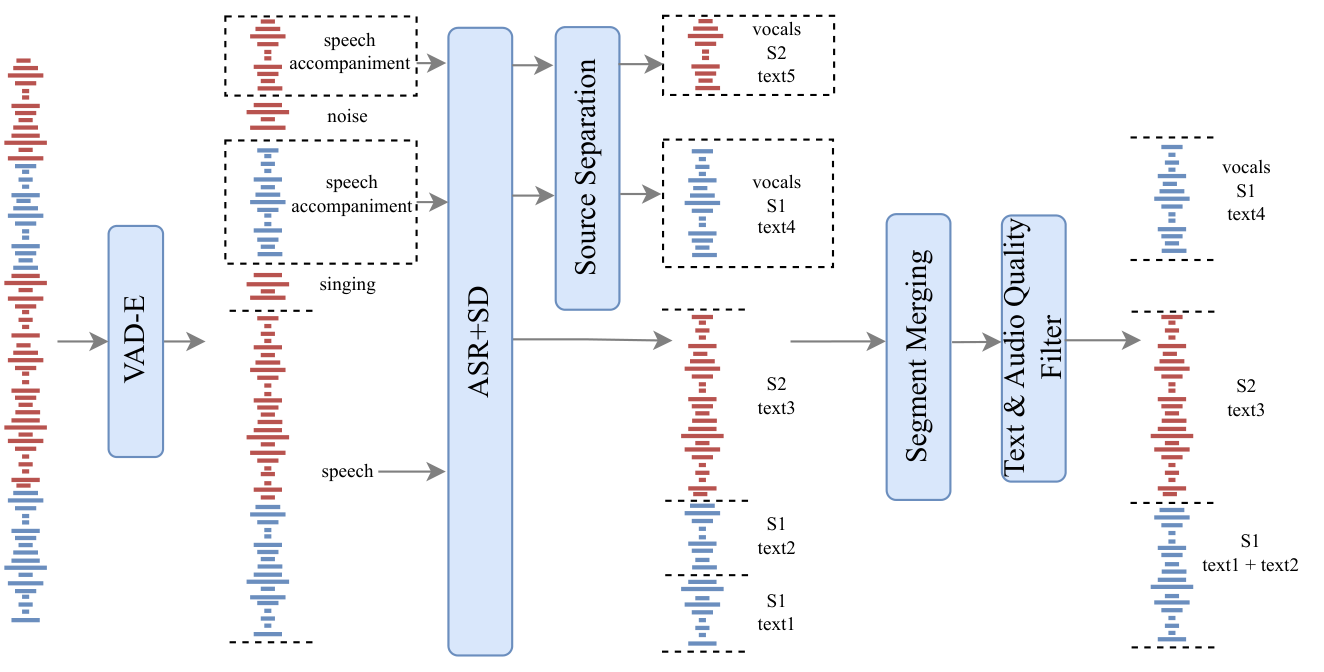
VAD-E로 구간을 나눈 뒤 ASR과 speaker diarization으로 텍스트와 화자를 구분한다. 반주가 있는 구간에는 source separation을 적용하고, 같은 화자의 짧은 구간을 합쳐 학습용 발화를 만든다.
3.1 VAD·ASR·speaker diarization의 역할
첫 단계인 음성 활동 검출(VAD)은 녹음에서 말소리가 있는 구간을 찾는다. 논문은 여기에 사건 분류를 결합해 말·노래·반주·배경 잡음의 비중을 추정한다. 단순히 소리가 큰 부분만 잘라내는 작업이 아니다. 뒤에서 그 구간을 어떤 학습 자료로 취급할지 판단할 단서를 만든다.
다음 자동 음성 인식인 ASR은 들린 말을 텍스트로 옮긴다. 이 시스템은 화자를 구분하는 diarization과 문장부호 복원도 함께 수행한다. 출력에는 텍스트, 화자 ID, 여러 화자가 섞였는지, 노래나 반주가 있는지의 표시가 붙는다. 예를 들어 한 영상에 A의 안내와 B의 답변이 이어진다면, 같은 파일에서 나온 소리라는 이유로 한 사람의 발화로 합치지 않도록 만드는 정보다.
3.2 Demucs를 필요한 구간에만 적용하는 이유
반주가 있다고 판단한 구간에는 Demucs 음원 분리를 적용해 보컬 성분을 얻는다. 저자들은 이 단계를 필요할 때만 사용한다. 원래 깨끗한 음성까지 변환하면 분리 과정 자체가 음질을 손상할 수 있기 때문이다. 데이터 정리는 변환을 많이 할수록 좋은 작업이 아니라, 문제 있는 구간에 필요한 처리를 선택하는 작업이다.
짧은 구간은 화자 일관성, 텍스트의 연결, 구간 사이 침묵을 보고 긴 발화로 합친다. 최종 구간에는 한 화자만 남기고 길이는 최대 25초로 제한한다. Figure 2 아래쪽의 같은 S1 화자에 속한 text1·text2가 합쳐지는 모습이 이 단계다. 짧게만 자르면 운율과 문맥이 끊기고, 무작정 길게 합치면 여러 화자나 다른 장면이 섞일 수 있다.
마지막에는 pre-trained 음질 평가 모델과 ASR 기반 텍스트 품질 검사로 자료를 거른다. 전자는 녹음 품질, 후자는 소리와 전사의 정합성을 본다. 다만 보고서에는 각 필터의 구체적 임계값, 단계별 탈락 비율, 최종 오정렬 비율이 충분히 제시되지 않는다. 공개 설명만으로 같은 원자료에서 정확히 같은 학습 집합을 재구성할 수 있다고 보기는 어렵다.
4. 학습 데이터: 언어별 시간과 unseen emotion language
4.1 다섯 언어의 학습 데이터 규모와 구성
논문의 데이터 절은 약 10만 시간이라고 소개한 뒤 중국어 3만, 영어 2만 5천, 일본어 4만 2천, 스페인어 2만 2,900, 아랍어 2만 시간을 열거한다. 이 항목을 더하면 13만 9,900시간이다. 같은 문단의 첫 문장은 네 언어를 나열하지만, 이어지는 목록과 실제 평가는 아랍어를 포함한 다섯 언어다.
이는 독자가 임의로 보정할 수 있는 차이가 아니다. 정제 전·후 수량인지, 중복 포함 수량인지, 개정하면서 남은 표현인지 원문만으로 확정할 수 없다. 따라서 이 글은 열거된 언어별 수량과 총량의 불일치를 그대로 남긴다. 데이터 규모를 근거로 계산 비용이나 다른 모델과의 효율을 정밀 비교하려면 저자 확인이 필요하다.
중국어·영어 자료는 주로 Emilia에 오디오북과 상업적으로 허가된 녹음을 더한 것이다. 일본어 4만 2천 시간 중 Emilia는 1,700시간이고 나머지는 상업 라이선스 자료다. 스페인어는 Common Voice, 아르헨티나 스페인어 음성 자료, TEDx, 고품질 크라우드소싱 음성, Multilingual LibriSpeech, LEMAS에서 모았다고 설명한다. 아랍어는 모두 상업 라이선스 자료다. 전체 학습 자료가 공개 dataset만으로 구성됐다는 해석은 맞지 않는다.
4.2 기본 언어 학습과 emotion training 데이터
감정 표현에는 별도로 135시간을 사용한다. 공개 Emotional Speech Dataset의 29시간과 상업 녹음 106시간이다. 논문이 설명하는 감정 학습 언어는 중국어와 영어다. 뒤에서 일본어·스페인어·아랍어의 감정 합성을 평가할 때 사용하는 ‘unseen languages’는 감정 음성 학습에서 보지 않은 언어라는 뜻이다.
예를 들어 일본어를 읽는 기본 능력은 일본어 수만 시간으로 이미 학습한다. 이후 중국어·영어의 감정 자료로 배운 화난 말투나 기쁜 말투를 일본어에도 옮길 수 있는지 묻는 것이다. 일본어를 전혀 접하지 않은 모델이 일본어 발음과 감정을 동시에 새로 습득했다는 실험이 아니다. 이 경계가 감정 전이 결과를 해석하는 출발점이다.
5. IndexTTS2.5 benchmark: WER·SS·ES·MOS·RTF
5.1 SeedTTS·CV3-Eval과 자체 test set의 범위
언어 조건 세 방식을 비교하는 실험에는 중국어·영어 SeedTTS-Eval과 자체 일본어·스페인어 테스트셋을 사용한다. 같은 조건에서 10만 학습 step을 진행한 뒤 비교했다고 설명한다. 이것은 입력에 언어를 전달하는 방식을 바꾸는 실험이다. 이후 여러 완성된 모델을 비교하는 Table 2·3과는 질문이 다르다.
화자 복제의 zero-shot 및 교차 언어 성능에는 다국어 CV3-Eval을 사용한다. 아랍어는 자체 zero-shot·교차 언어 자료를 만들었고, 스페인어 교차 언어 자료도 자체 구축했다. 교차 언어는 참조 음성의 언어와 생성할 텍스트의 언어가 다른 경우다. 이 보고서의 Table 3은 중국어 참조에서 다른 언어로 가는 방향을 평가한다. 모든 언어 조합을 양방향으로 시험한 표가 아니다.
감정 합성은 자체 일본어·스페인어·아랍어 테스트와 CV3-Eval Emotion-ZeroShot으로 따로 살핀다. 일반 화자 복제와 감정 발화는 텍스트·참조·발화 방식이 달라질 수 있다. 서로 다른 표에서 같은 언어의 WER만 꺼내 모델이 몇 배 좋아졌다고 계산하면 안 된다.
5.2 WER·SS·ES·MOS·RTF를 읽는 방법
| 지표 | 실제로 비교하는 대상 | 읽는 방향 | 해석할 때 주의할 점 |
|---|---|---|---|
| WER | 목표 텍스트와 합성 음성을 ASR로 다시 받아쓴 텍스트 | 낮을수록 좋음 | 합성의 내용 오류와 ASR의 인식 오류가 함께 반영될 수 있다 |
| SS | 참조 음성과 합성 음성의 화자 특징 | 높을수록 좋음 | 사람 전체의 청취 품질이나 발음 정확도를 직접 뜻하지 않는다 |
| ES | 참조와 합성 음성의 감정 특징 | 높을수록 좋음 | 감정 분류 정답률과 다른 유사도 지표다 |
| MOS | 모국어 청취자가 준 자연스러움 점수 | 1∼5, 높을수록 좋음 | 평가자·표본 수와 불확실성이 있어야 차이의 안정성을 판단할 수 있다 |
| RTF | 생성 계산 시간 ÷ 생성 음성 길이 | 낮을수록 좋음 | 어떤 모듈의 시간을 포함했는지 확인해야 한다 |
WER는 보통 바뀐 단어, 빠진 단어, 추가된 단어의 수를 기준 텍스트 길이와 비교한다. 이 논문은 중국어에 FunASR, 다른 언어에 Whisper-large-v3를 사용한다. 중국어의 구체적 분절·normalization 설정까지 동일하다고 확인하지 않은 다른 논문 수치와 단순 비교하지 않는다. 표의 % 단위도 그대로 유지한다.
SS는 FunASR의 화자 검증 모델로 얻은 특징 vector 사이의 cosine similarity다. cosine similarity는 vector가 가리키는 방향이 얼마나 가까운지를 보는 값이다. ES는 emotion2vec으로 얻은 감정 특징에 같은 종류의 비교를 적용한다. 목소리가 비슷해도 감정은 다를 수 있고, 감정이 비슷해도 문장을 잘못 읽을 수 있으므로 이 지표들은 서로 대체되지 않는다.
SS의 표시 단위도 표마다 다르다. Table 1·4에는 0.8 부근의 값이, Table 2·3에는 70 부근의 값이 나온다. 후자는 같은 계열 유사도를 100배 척도로 표시한 것으로 읽히지만, 이 글은 원문 값의 단위를 바꾸지 않고 각 표 안에서 비교한다. 숫자 크기만 보고 Table 2에서 유사도가 수십 배 증가했다고 해석하지 않는다.
평가 설명에는 모델의 정확한 세부 리비전, 모든 테스트의 표본 수, MOS 평가자 수와 confidence interval, 난수 seed가 충분히 제시되지 않는다. 따라서 아래의 비교는 보고된 점 추정값의 차이다. 특히 0.05%포인트처럼 작은 평균 차이를 확실한 실사용 우위라고 부르려면 반복 평가가 필요하다.
6. Language conditioning: boundary·token·instruction 방식
‘銀行’처럼 여러 언어에서 겹치는 글자가 있다고 하자. 글자만 봐서는 어떤 언어의 발음으로 읽어야 하는지 충분하지 않을 수 있다. 참조 화자가 중국어로 말한다는 사실과 출력 텍스트를 일본어로 읽어야 한다는 조건도 서로 다르다. 모델에 목표 언어를 분명하게 전달해야 한다.
논문이 사용하는 기본 입력 순서를 먼저 풀어 쓰면 다음과 같다. 이것은 입력 요소의 배열을 설명하는 표기이며 성능을 계산하는 식이 아니다.
는 화자나 감정의 전역 조건, 는 세밀한 길이 제어를 위한 보조 embedding이다. embedding은 입력 정보를 신경망이 사용할 수 있는 숫자 vector로 바꾼 것이다. 는 텍스트 vector의 열, 은 정답 음성에서 얻은 semantic token vector의 열이다. 와 는 각각 텍스트와 음성 쪽 시작을 표시하는 특수 token의 vector다. 학습 때 정답 음성 token을 보는 배열과 inference 때 앞으로 생성할 token을 같은 것으로 혼동하면 안 된다.
세 방식의 차이는 언어 정보를 문장 경계, 각 token, 별도 지시 중 어디에 넣느냐에 있다.
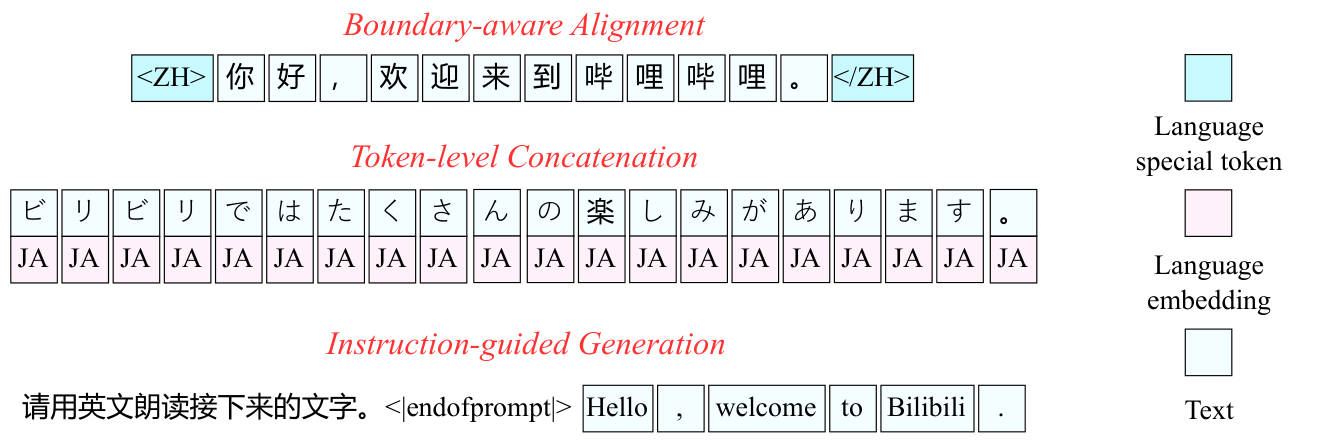
세 방식의 차이는 language 정보를 주입하는 위치다. Boundary 방식은 언어 경계에 표식을 넣고, token-level 방식은 각 token에 language embedding을 연결하며, instruction 방식은 자연어 지시로 목표 언어를 전달한다. 같은 다국어 생성 문제를 입력 조건의 해상도로 나눈 비교이며, 뒤의 ablation은 이 차이가 언어별 WER·SS에 어떻게 나타나는지 검증한다.
입력이 간단한 방식과 모든 token에 조건을 전달하는 방식은 전처리 부담도 다르다.
6.1 Boundary-aware alignment: 언어 경계 token
첫 방식은 문장 앞뒤에 중국어라면 <ZH>와 </ZH> 같은 표시를 붙인다. 시작부터 끝까지 어떤 언어 구간인지 알려 주므로 입력을 만들기 쉽다. 논문은 이를 boundary-aware alignment라고 부른다. 언어 조건을 문장 경계에 두는 방식이라고 이해하면 된다.
하지만 긴 문장의 뒤쪽까지 처음의 언어 조건이 안정적으로 유지된다고 보장되지는 않는다. 저자들은 autoregressive 생성의 오류 때문에 긴 발화에서 발음 제어가 약해질 수 있다고 설명한다. 다만 이 보고서는 길이별 오류 곡선을 따로 제시하지 않는다. 이 설명은 설계 동기를 이해하는 데 유용하지만, 긴 문장 실패 원인을 단독 실험으로 확정한 결과는 아니다.
6.2 Token-level alignment: token마다 language embedding
두 번째는 매 텍스트 token마다 해당 언어의 vector를 결합한다. 같은 한자가 문장 중간에 등장해도 그 위치에서 언어 조건을 다시 제공하는 셈이다. 논문은 이를 token-level concatenation으로 설명한다. 여러 언어가 섞인 문장이라면 어느 token이 어느 언어에 속하는지 세밀하게 알아내는 전처리가 필요해 시스템 구성이 복잡해질 수 있다.
이 방식의 목적은 언어 표시를 잊지 않게 하는 것이다. 그렇다고 언어 vector만 붙이면 문맥에 따라 달라지는 모든 읽기가 해결되는 것은 아니다. 실제 Table 1에서 화자 유사도는 네 dataset 모두 가장 높지만, 일본어의 내용 오류율은 세 방식 중 가장 높다. 지속적인 언어 조건과 정확한 발음이 항상 함께 좋아지는 것은 아니다.
공개 코드를 읽을 때는 ‘결합’이라는 표현을 더 구체적으로 봐야 한다. 검토한 코드는 텍스트 vector에 언어 vector를 더한다. 논문에 적힌 vector 연결과 연산을 같다고 단정해서는 안 된다. 이 차이는 구현 절에서 다시 확인한다.
6.3 Instruction-guided alignment: 자연어 언어 지시
세 번째는 ‘다음 문장을 영어로 읽어라’ 같은 지시를 앞에 둔다. 지시가 끝나는 특수 표시 뒤에 읽을 텍스트를 배치한다. 논문은 학습 때 여러 지시 양식 중 하나를 무작위로 골라 사용한다고 설명한다. 이렇게 하면 별도 언어 태깅 모듈에 덜 의존할 수 있다.
예를 들어 지시 문장은 중국어이지만 실제 읽을 본문은 영어일 수 있다. 모델은 지시를 낭독할 텍스트와 구별해야 한다. 지시 종료 표시는 이 경계를 알려 주는 장치다. 언어가 섞인 문장에서는 지시가 길어져도 모든 부분의 발음을 더 잘 지정해 주는 것은 아니므로 입력에 중복이 생길 수 있다. 실제로 어떤 지시 양식이 얼마나 견고한지 보여 주는 별도 결과는 이 보고서에 없다.
7. Language conditioning ablation: 언어별 WER·SS 비교
중국어 SeedTTS에서 token별 방식은 WER 1.119%, SS 0.804다.
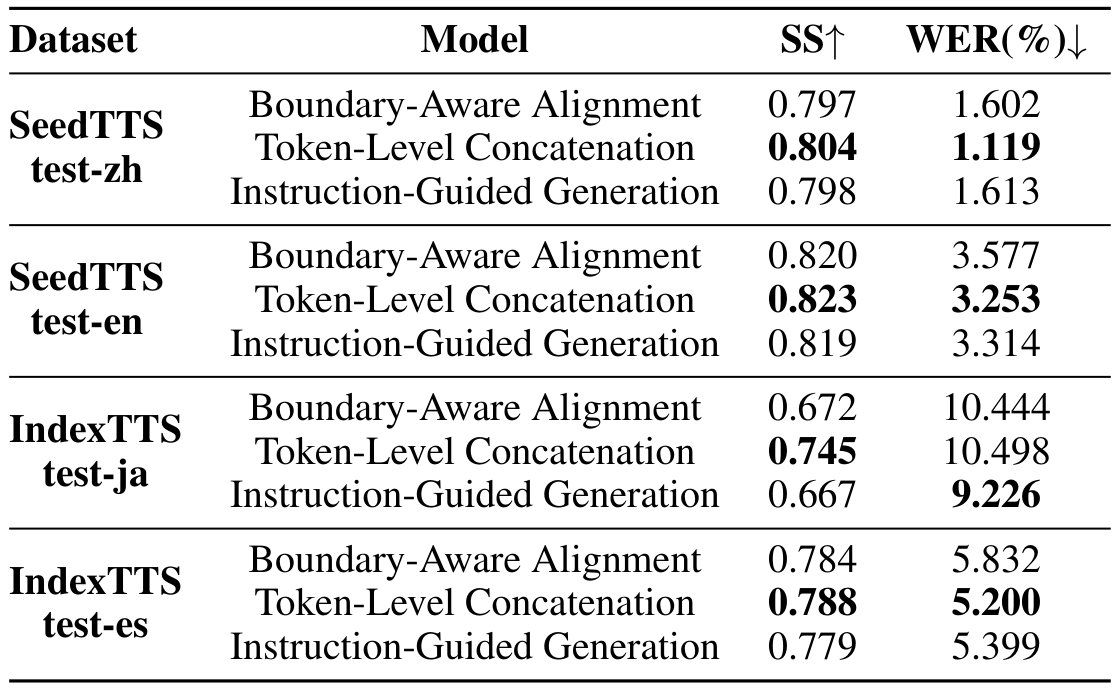
경계 방식의 1.602%·0.797, 지시 방식의 1.613%·0.798보다 두 지표가 모두 좋다. 영어에서도 token별 방식은 WER 3.253%, SS 0.823으로 경계 방식의 3.577%·0.820과 지시 방식의 3.314%·0.819를 앞선다. 이 두 언어에서는 매 token에 언어 조건을 주는 변경이 내용과 목소리 지표 모두에 유리했다.
스페인어도 같은 방향이다. token별 방식의 WER 5.200%·SS 0.788은 경계 방식 5.832%·0.784, 지시 방식 5.399%·0.779보다 좋다. 다만 이 차이의 유의성을 검정할 반복 학습 결과는 없다. 숫자의 방향은 일관되지만 모든 조건에서 같은 크기의 이득이 난다고 보장할 수 없다.
일본어는 결론이 갈린다. token별 방식은 SS 0.745로 경계 0.672, 지시 0.667보다 높다. 그러나 WER는 10.498%로 경계 10.444%보다도 약간 높고, 지시 방식의 9.226%보다 뚜렷이 높다. 자연어 지시가 내용 정확도에서 유리한 대신 화자 유사도는 낮은 결과다.
원문은 token별 방식의 일관된 개선을 강조하지만 ‘모든 언어에서 WER까지 가장 좋다’는 뜻으로 읽을 수는 없다. 저자들은 일본어의 문맥과 형태적 특성에 비해 엄격한 결합이 유연하지 않을 가능성을 설명한다. 이것은 가능한 원인 해석이다. 일본어의 형태 처리만 바꾸는 별도 대조 실험이 없으므로 특정 원인을 입증한 결과로 확대하지 않는다.
이 실험에서 실용적으로 배울 점은 목표가 무엇인지 먼저 정하라는 것이다. 정확한 안내 문구가 우선이라면 WER를, 캐릭터 음색 유지가 우선이라면 SS를 함께 보되, 한쪽을 다른 쪽의 대리 지표로 쓰지 않는다. token별 언어 태깅을 위한 전처리 비용도 실제 도입 시 별도로 확인해야 한다.
8. GRPO 학습: 후보 음성 4개의 WER·SS reward 비교
기본 학습을 마친 T2S가 같은 문장을 여러 번 생성해도 발음, 속도, 화자 느낌이 조금씩 달라질 수 있다. 이 차이를 활용하는 것이 후속 reinforcement learning이다. 논문은 입력 하나마다 확률적으로 네 개의 후보 음성을 만들고, 후보들 사이의 reward 차이를 이용하는 GRPO, Group Relative Policy Optimization을 적용한다.
후보의 좋고 나쁨은 두 신호로 판단한다. 고정된 ASR이 합성 음성을 다시 받아쓴 뒤 원래 문장과 비교한 WER가 낮은지, 화자 검증 모델이 참조와 비슷한 목소리라고 판단하는 SS가 높은지를 본다. ASR을 고정한다는 것은 학습 도중 평가 기준까지 함께 바뀌지 않도록 한다는 뜻이다. 사람이 모든 후보를 직접 채점한다는 방식은 아니다.
구체적으로 ‘공항으로 이동합니다’에 해당하는 목표 언어 문장을 읽힌다고 하자. A는 단어 하나를 빼먹었지만 목소리는 비슷하고, B는 내용을 정확히 읽었지만 음색이 달라졌으며, C는 두 조건을 모두 더 잘 지키고, D는 둘 다 좋지 않을 수 있다. 이는 원리를 설명하기 위해 만든 예시다. 논문의 실제 네 후보나 실제 reward 값을 재현한 것은 아니다. 학습은 더 높은 reward를 받은 후보의 token열을 상대적으로 더 잘 생성하는 방향으로 진행된다.
여기서 빠진 정보도 중요하다. WER와 SS를 어떤 weight로 합쳤는지, reward를 어떻게 normalize했는지, 기존 모델에서 너무 멀어지지 않도록 하는 KL 제약이나 갱신 폭 제한을 어떻게 설정했는지, learning rate와 전체 후속 학습 예산은 무엇인지 충분히 공개되지 않는다. 그러므로 일반적인 GRPO 수식을 가져와 이 논문의 정확한 objective function인 것처럼 채워 넣지 않는다.
reward에 사용한 지표가 높아진 것과 모든 청취 경험이 좋아진 것도 다르다. ASR이 알아듣기 쉬운 음성이 사람이 듣기에도 항상 더 자연스럽지는 않다. Table 2·3에서 RL 전후의 같은 모델을 비교하면 후속 학습의 변화는 볼 수 있지만, 점수가 엇갈릴 때 어떤 reward 항이 원인이었는지는 세부 설정과 추가 실험이 필요하다.
9. Zero-shot voice cloning: 다섯 언어의 WER·SS와 GRPO 효과
9.1 GRPO 전후 평균 WER·SS와 model size 비교
Table 2에는 VoxCPM2, OmniVoice, Moss-TTS 1.5, CosyVoice3의 두 크기, FireRedTTS-2, Fish Audio S2 Pro, Qwen3-TTS와 IndexTTS2.5가 등장한다.
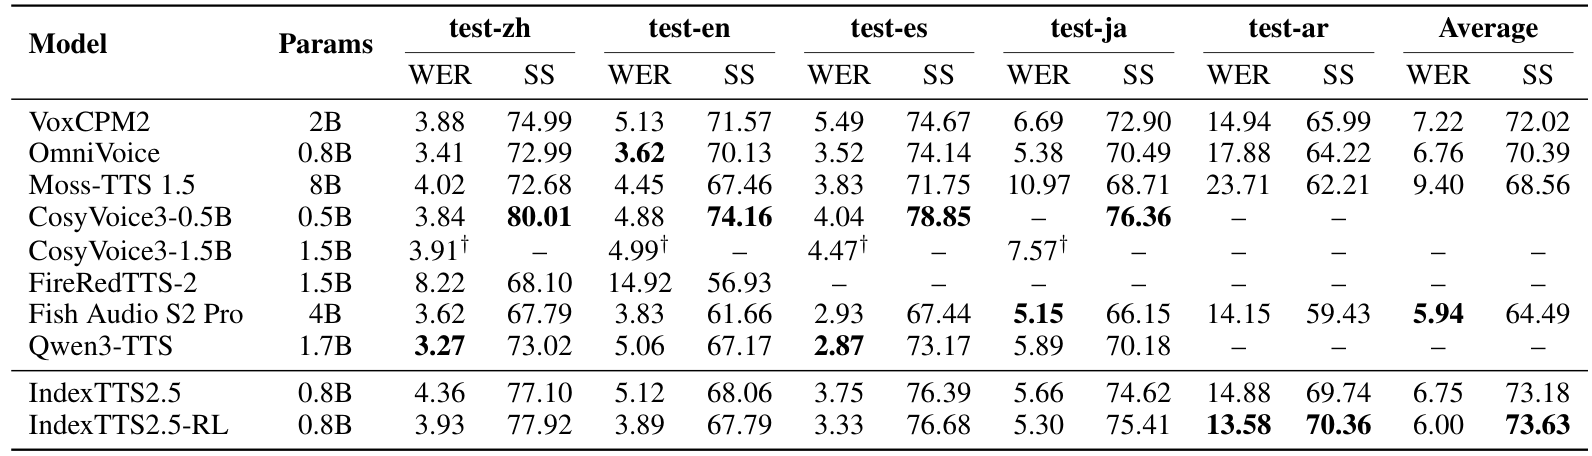
다섯 언어의 평균 WER는 기본 IndexTTS2.5 6.75%에서 GRPO 적용 후 6.00%로 낮아지고, 평균 SS는 73.18에서 73.63으로 높아진다. 이 표의 핵심은 내용 오류와 speaker similarity를 함께 개선한 결과다. 평균 WER는 Fish Audio S2 Pro의 5.94%보다 높으므로 모든 지표의 1위라는 뜻은 아니다.
Params는 표에서 제시한 모델 크기이며 0.8B는 약 8억 parameter를 뜻한다. 모델마다 포함한 모듈의 범위와 학습 데이터가 다를 수 있으므로 크기만으로 공정한 효율 실험이라고 볼 수는 없다.
가장 먼저 평균 열의 함정을 피해야 한다. 기본 IndexTTS2.5의 평균 WER는 6.75%, RL 적용 후는 6.00%다. Fish Audio S2 Pro는 5.94%로 둘보다 낮다. 원문 본문은 기본 모델의 6.75를 ‘가장 낮은 평균’으로 소개하면서 같은 문단에서 Fish의 평균이 더 낮다고도 적는다. 표를 기준으로 읽으면 ‘최저 평균 WER’라는 첫 표현은 성립하지 않는다.
평균 SS는 IndexTTS2.5 기본 73.18, RL 73.63이다. 다섯 언어 모두의 평균이 보고된 모델들 중 가장 높다. VoxCPM2 72.02, OmniVoice 70.39, Moss-TTS 68.56, Fish 64.49보다 높다. 따라서 이 모델의 비교상 위치는 내용 오류율 최저 모델보다 낮은 오류와 높은 화자 유사도를 함께 노리는 모델로 설명하는 것이 정확하다.
CosyVoice나 Qwen처럼 일부 언어·지표만 있는 행의 평균을 0으로 채워 새 순위를 만들면 안 된다. CosyVoice3-1.5B의 † 값은 해당 모델의 원 논문에서 가져온 값이어서, 저자들이 같은 평가 절차로 직접 다시 측정한 값과 출처가 다르다. 표가 서로 다른 출처를 섞고 있다는 사실도 남겨 둬야 한다.
9.2 중국어·영어: RL이 내용을 개선해도 영어 음색 점수는 내려간다
중국어에서 기본 모델은 WER 4.36%·SS 77.10이고, RL 후에는 3.93%·77.92다.
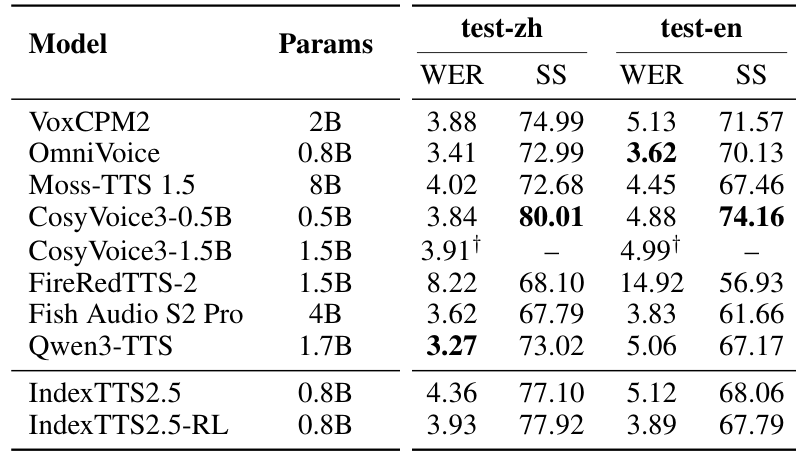
내용과 화자 지표가 함께 좋아졌다. 그러나 중국어의 최저 WER는 Qwen3-TTS의 3.27%이고 가장 높은 SS는 CosyVoice3-0.5B의 80.01이다. RL을 적용했다는 이유로 각 열의 1위가 된 것은 아니다.
영어에서는 WER가 5.12%에서 3.89%로 줄어 비교적 큰 개선을 보인다. 하지만 SS는 68.06에서 67.79로 0.27 낮아진다. 평균 SS가 높아졌다는 설명에 이 영어 예외를 함께 붙여야 한다. 영어 WER의 최저값은 OmniVoice의 3.62%이며 Fish도 3.83%다. 화자 유사도에서는 CosyVoice3-0.5B 74.16과 VoxCPM2 71.57이 RL 모델보다 높다.
RL은 WER와 SS를 함께 reward로 쓰지만, 실제 모델의 모든 언어에서 두 지표가 동시에 오르는 것은 아니다. 원래의 데이터 분포, reward weight, 언어별 후보 분포가 영향을 줄 수 있다. 보고된 자료로는 어느 요인이 영어 SS 하락을 만들었는지 분리할 수 없으므로, 원인을 확정하는 대신 개선과 하락을 각각 기록한다.
9.3 스페인어·일본어: 양쪽 지표가 개선되지만 경쟁 모델의 강점도 남는다
스페인어의 기본 WER 3.75%·SS 76.39는 RL 후 3.33%·76.68이 된다.
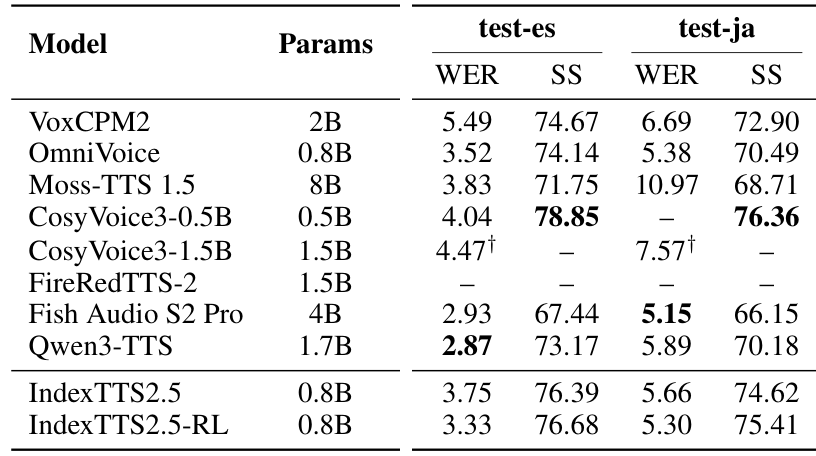
양쪽이 개선됐지만 WER는 Qwen3-TTS 2.87%, Fish 2.93%보다 높고, SS는 CosyVoice3-0.5B의 78.85보다 낮다. 읽기 정확도를 최우선으로 하는 작업과 같은 음색을 유지하는 작업이 같은 모델을 선택할 이유는 없다.
일본어에서는 WER가 5.66%에서 5.30%, SS가 74.62에서 75.41로 바뀐다. WER는 Fish의 5.15%가 더 낮고, SS는 CosyVoice3-0.5B의 76.36이 더 높다. 다만 후자의 일본어 WER는 표에 없으므로 두 지표를 함께 비교할 수 없다. 하나의 강한 지표가 나머지 미보고 지표까지 보증해 주지 않는 사례다.
완성된 서로 다른 모델을 비교한 이 부분은 RL 효과만을 분리한 실험이 아니다. 반면 마지막 두 IndexTTS 행의 차이는 같은 기본 모델에 후속 학습을 적용한 비교라서, RL 전후의 변화를 읽는 데 더 직접적이다. 이 두 종류의 비교를 한 문장으로 섞지 않는 것이 좋다.
9.4 아랍어와 평균: 개선 폭이 커도 절대 오류는 남는다
아랍어에서 기본 모델의 WER는 14.88%, SS는 69.74다.
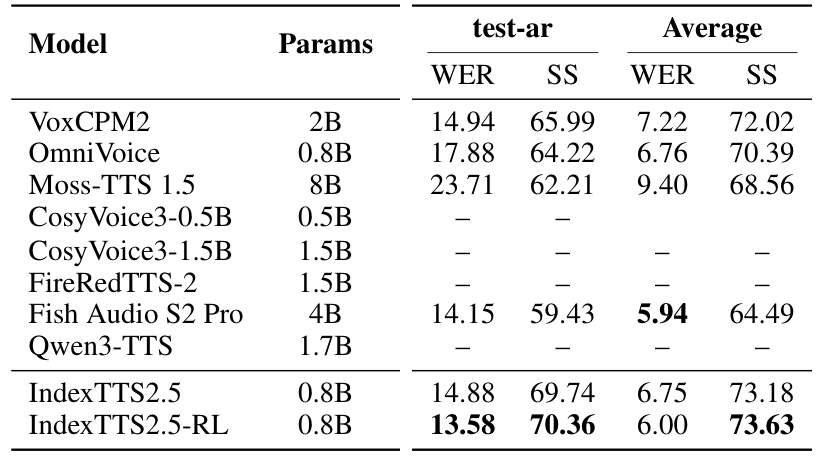
RL 후 13.58%·70.36으로 바뀌며, 표에서 아랍어 수치를 보고한 모델들 중 두 값 모두 가장 좋다. 이 언어의 개선이 평균에도 영향을 준다. 그러나 13.58%라는 절대 오류율을 보지 않고 ‘최고 성능’만 말하면, 실제 안내 방송에서 발생할 수 있는 오독을 놓치게 된다.
다섯 언어 모두 WER는 낮아졌다. SS는 네 언어에서 높아지고 영어에서 낮아졌다. 보고된 평균 WER 감소는 0.75%포인트, SS 증가는 0.45다. 소수점 반올림된 언어별 값을 직접 평균내면 마지막 자릿수가 원문 평균과 조금 다를 수 있으므로, 원문 평균을 원래 값으로 두고 계산 근거를 구분한다.
이 결과는 다섯 언어 전체에서 RL이 내용 정확도에 도움이 됐다는 근거다. 동시에 단일 reward가나 평균 하나로 모든 사용 조건을 설명할 수 없다는 근거이기도 하다. 다음 표에서는 참조 음성의 언어까지 바뀌면서 다른 예외가 나타난다.
10. Cross-lingual TTS: 중국어 참조로 다른 언어 읽기
이 표의 cross-lingual 조건은 중국어 참조에서 다른 언어의 음성을 생성하는 방향이다.
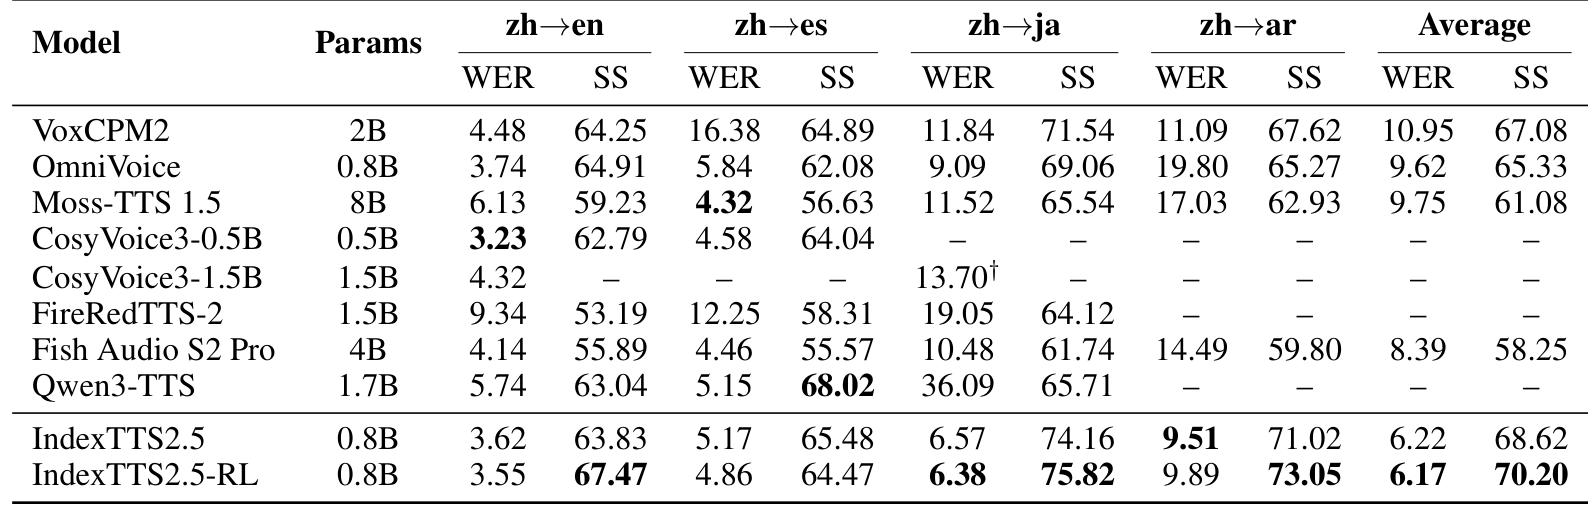
중국어 reference에서 네 언어로 생성한 평균은 GRPO 전 WER 6.22%·SS 68.62에서 GRPO 후 6.17%·70.20으로 변한다. WER 차이는 0.05%p로 작고 SS는 1.58 높아졌다. 일본어는 두 지표가 함께 개선되지만 스페인어 SS와 아랍어 WER는 악화되어, 평균 개선의 내용을 방향별로 풀어 읽어야 한다.
WER 감소와 SS 증가를 따로 확인해야 하며, 다른 참조 언어나 반대 방향에도 같은 결과가 나온다고 확대해석할 수 없다.
10.1 영어·스페인어 cross-lingual WER·SS
중국어 참조로 영어를 생성할 때 기본 IndexTTS2.5는 WER 3.62%·SS 63.83이다.
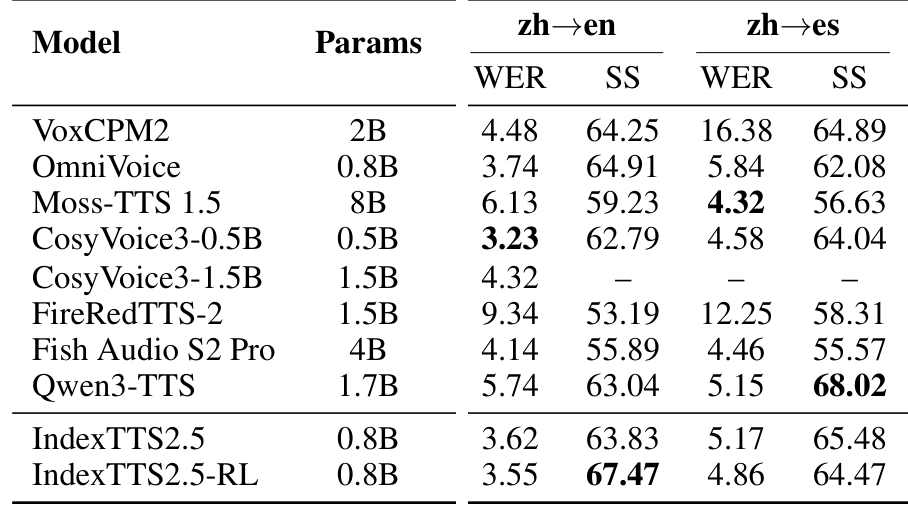
RL 후에는 3.55%·67.47이 된다. WER 개선은 작지만 화자 유사도는 3.64 높아진다. 표에서 영어 최저 WER는 CosyVoice3-0.5B의 3.23%이고, 가장 높은 SS는 RL 모델의 67.47이다. 내용과 음색의 우위가 다시 분리된다.
스페인어는 다르다. 기본 WER 5.17%는 RL 후 4.86%로 낮아지지만 SS는 65.48에서 64.47로 내려간다. 이 방향의 최저 WER는 Moss-TTS 1.5의 4.32%, 최고 SS는 Qwen3-TTS의 68.02다. 같은 Qwen 모델이라도 영어·일본어 결과까지 함께 읽어야 하고, 하나의 스페인어 SS만으로 교차 언어 전체의 우위를 주장할 수 없다.
여기서 핵심은 평균 개선이라는 문구보다 실제 작업의 방향을 먼저 확인하는 것이다. 중국어 목소리를 영어로 옮기는 작업에서 유리한 변경이, 중국어 목소리를 스페인어로 옮길 때도 같은 화자 점수 이득을 주지는 않았다.
10.2 일본어·아랍어와 cross-lingual 평균
일본어의 WER는 6.57%에서 6.38%, SS는 74.16에서 75.82로 좋아진다.
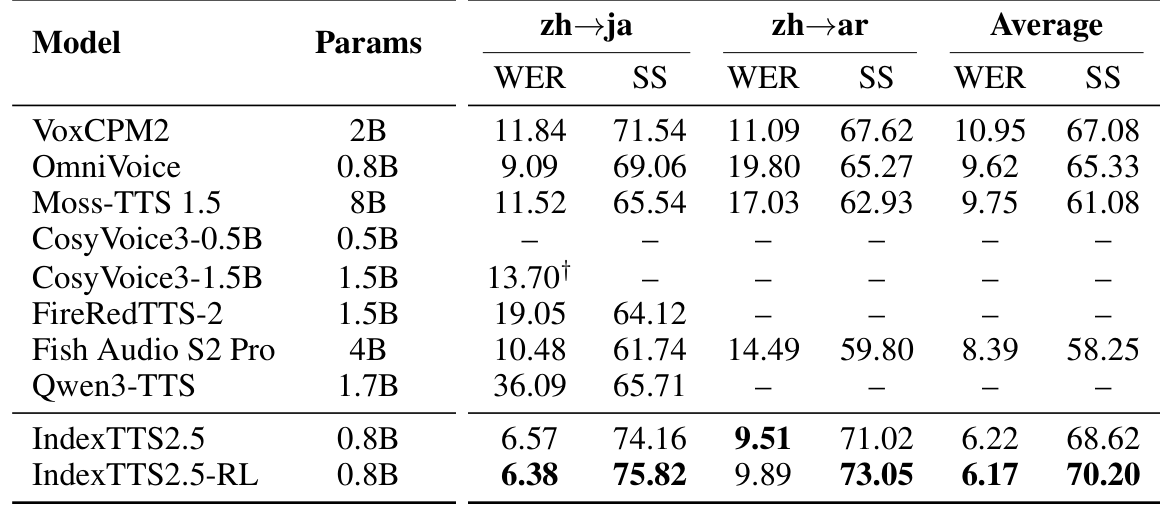
이 표의 보고값 가운데 RL 모델이 두 지표 모두 가장 좋다. 다른 모델을 보면 Qwen3-TTS의 WER가 36.09%로 크게 높고, OmniVoice는 9.09%, Fish는 10.48%다. 교차 언어의 특정 방향이 모델마다 상당히 다른 난도가 될 수 있음을 보여 준다. 해당 차이가 학습 자료, 언어 조건, 참조 처리 중 무엇 때문인지는 모델 간 비교만으로 확정할 수 없다.
아랍어는 WER가 9.51%에서 9.89%로 악화된다. SS는 71.02에서 73.05로 좋아진다. RL 이전 모델이 이 열의 최저 WER를 갖고 RL 이후 모델이 최고 SS를 갖는 것이다. 기본 음색을 더 강하게 유지하는 것과 목표 언어 내용을 정확히 읽는 일이 항상 같은 최적점을 갖지는 않는다는 관찰이다.
전체 평균은 기본 모델 WER 6.22%·SS 68.62에서 RL 6.17%·70.20으로 바뀐다. WER 감소는 0.05%포인트로 작다. 평균이 둘 다 좋아졌지만 아랍어 WER와 스페인어 SS는 나빠졌다는 조건을 함께 남겨야 한다. 다른 완전한 평균을 가진 모델은 VoxCPM2 10.95%·67.08, OmniVoice 9.62%·65.33, Moss-TTS 9.75%·61.08, Fish 8.39%·58.25다. 이 네 방향 평균에서는 IndexTTS2.5 계열이 강한 결과를 보인다.
이 표는 중국어를 출발점으로 한다. 영어 참조에서 중국어로, 아랍어 참조에서 일본어로, 한국어 참조에서 다섯 언어로 가는 성능은 보여 주지 않는다. 또한 표의 평균 우위가 모든 화자·문장 길이·녹음 품질에서 유지되는지도 별도의 시험이 필요하다.
11. Cross-lingual emotion transfer: ES·MOS와 감정 강도 평가
11.1 Emotion transfer의 ES·MOS 개선과 WER 예외
이 실험은 중국어·영어의 감정 음성으로 학습한 표현이 다른 언어로 옮겨지는지 묻는다.
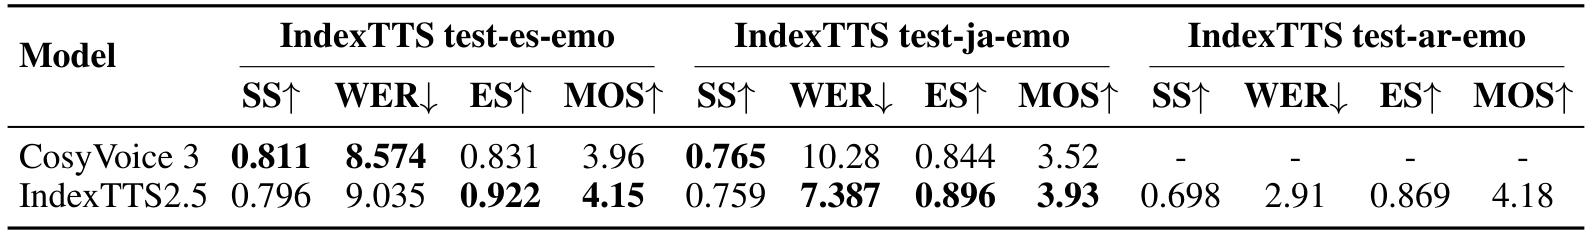
비교 대상은 CosyVoice 3이며, 스페인어에서 IndexTTS2.5의 ES는 0.922, MOS는 4.15다. CosyVoice의 0.831·3.96보다 높아 감정 특징과 청취 점수에서 유리하다. 그러나 SS는 0.811에서 0.796으로 낮아지고, WER는 8.574%에서 9.035%로 높아진다. 감정을 더 잘 따르는 결과와 내용·음색 점수의 손해가 함께 있다.
일본어에서는 WER가 CosyVoice 10.28%에서 IndexTTS2.5 7.387%로 낮고, ES는 0.844 대 0.896, MOS는 3.52 대 3.93으로 높다. 이 세 지표는 같은 방향이다. 하지만 SS는 0.765 대 0.759로 IndexTTS2.5가 조금 낮다. ‘감정 합성의 모든 지표가 우수하다’고 묶기보다 어떤 지표에서 개선됐는지 나누어 설명해야 한다.
아랍어의 SS는 0.698, WER는 2.91%, ES는 0.869, MOS는 4.18이다. 여기서는 일본어 참조를 사용했으므로 참조와 목표 언어가 다른 실험이며, CosyVoice의 비교값이 없다. 보고된 청취 점수는 감정 전이의 가능성을 보여 주지만 비교 모델에 대한 우위는 말할 수 없다. Table 2의 아랍어 WER 14.88%와 이 2.91%는 서로 다른 테스트셋·참조 조건의 결과이므로 단순한 개선율을 계산하지 않는다.
감정 학습에서 보지 않은 언어에도 감정 특징을 옮겼다는 점은 이 실험의 의미다. 다만 그 언어의 기본 음성은 이미 학습했고, 감정·음색·발음 지표가 모두 같은 방향으로 움직이지 않았다. 실제 더빙에서는 감정을 잘 표현한 음성에 잘못 읽은 고유명사나 달라진 음색이 없는지도 따로 검수해야 한다.
11.2 Emotion intensity: accuracy·F1·W-F1 비교
Table 5는 감정 특징의 유사도 ES와 다른 질문을 한다.
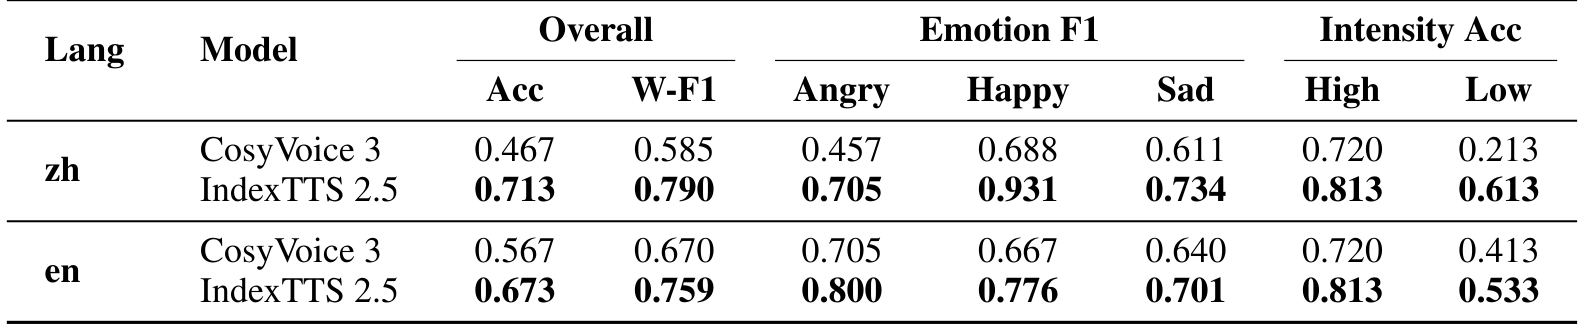
중국어의 전체 emotion accuracy는 CosyVoice 3의 0.467에서 IndexTTS2.5 0.713으로, W-F1은 0.585에서 0.790으로 높다. 영어에서도 각각 0.567→0.673, 0.670→0.759로 개선된다. 두 언어 모두에서 목표 감정과 강도를 구별하는 지표가 높아졌다는 결과이며, 아래에서는 감정별·강도별 차이를 읽는다.
목표 감정을 구분할 수 있는지, 강도를 맞췄는지를 평가한다. 정확도인 Acc는 맞게 판정한 비율이다. F1은 해당 감정이라고 예측한 것의 정확성과 그 감정을 놓치지 않고 찾은 정도를 함께 반영한다. W-F1은 감정별 표본 비중을 고려한 평균이다. 따라서 ES 0.9를 감정 정답률 90%라고 바꾸어 읽으면 안 된다.
중국어에서 전체 정확도는 CosyVoice 3의 0.467에서 IndexTTS2.5 0.713, 가중 F1은 0.585에서 0.790으로 높다. 감정별 F1도 화남 0.457→0.705, 기쁨 0.688→0.931, 슬픔 0.611→0.734로 모두 높다. 특정 감정 하나만 개선된 결과가 아니다.
강도에 따른 차이는 더 구체적이다. 중국어의 높은 강도 정확도는 0.720→0.813이지만 낮은 강도는 0.213→0.613이다. 낮은 강도에서 차이가 0.400으로 더 크다. 강한 분노나 기쁨보다 약한 감정이 덜 두드러져 판정하기 어려울 수 있다는 해석과 맞는 패턴이다. 다만 난도가 왜 달라졌는지를 독립적으로 검증한 실험은 아니므로 수치에서 출발한 해석으로 한정한다.
영어는 전체 정확도 0.567→0.673, 가중 F1 0.670→0.759다. 화남 0.705→0.800, 기쁨 0.667→0.776, 슬픔 0.640→0.701로 모두 높고, 높은 강도는 0.720→0.813, 낮은 강도는 0.413→0.533이다. 영어에서도 낮은 강도의 개선이 있지만 중국어처럼 0.400 차이는 아니다.
표의 모든 항목에서 IndexTTS2.5가 높다는 것은 그대로 인정할 수 있다. 다만 이 보고서에는 감정·강도 판정기의 세부 설정, 표본 구성, confidence interval이 충분히 적혀 있지 않다. 특정 판정기의 기준에 맞춘 개선인지 실제 사람이 느끼는 모든 감정의 개선인지 더 확인하려면 동일한 음성에 대한 독립 청취 평가가 필요하다. 이 표는 자연어 감정 지시 기능만 따로 켜고 끈 실험도 아니다.
12. TTS 속도 개선: 25Hz codec과 Zipformer S2M
12.1 Semantic codec: 50Hz에서 25Hz로 압축
token을 한 개씩 생성하는 T2S에서는 만들어야 할 token의 수가 계산량에 직접 영향을 준다. 논문은 semantic codec의 시간 해상도를 50Hz에서 25Hz로 줄인다. 여기서 Hz는 오디오 파일의 sample rate가 아니라 1초에 배치되는 semantic token의 수다.
가령 같은 길이의 10초 발화를 나타낸다고 단순화하면 50Hz에서는 약 500개, 25Hz에서는 약 250개의 token이 필요하다. 이 숫자는 원리를 설명하기 위한 계산 예시다. 실제 모델을 실행해 10초 출력의 token 수를 측정한 결과는 아니다. 시작·종료 처리와 길이 복원도 별도로 고려해야 한다.
token이 절반이면 언어 모델의 순차 생성 횟수를 줄일 수 있다. 반대로 각 token이 맡는 시간 범위는 넓어져 음성 정보를 얼마나 유지하는지가 중요해진다. 이 보고서에는 codec 해상도만 50Hz와 25Hz로 바꾸고 다른 요소를 완전히 고정한 WER 비교표가 없다. 따라서 token 수가 절반이라는 사실에서 음질 저하가 정확히 0이라고 결론낼 수는 없다.
12.2 S2M backbone: U-DiT와 Zipformer 비교
S2M도 여러 번의 계산을 거쳐 mel representation을 만든다. 논문은 이 단계의 중심 신경망을 U-DiT에서 Zipformer로 바꿨다고 보고한다. DiT는 Transformer 구조로 잡음에서 목표 표현 쪽으로 이동하는 방향을 예측하는 모델 계열이다. Zipformer는 여러 시간 해상도를 활용해 계산을 줄이도록 설계된 구조다. token을 덜 만드는 변경과, 각 복원 단계의 계산을 가볍게 만드는 변경이 서로 다른 위치에 적용된다.
이 변경은 단순한 모델 간 순위표와 달리, S2M의 중심 구조를 바꿔 비교하는 실험을 포함한다. 저자들은 따로 남겨 둔 테스트 자료에서 두 음성을 짝으로 들려주고 품질·화자 유사성·운율의 자연스러움을 평가했다고 설명한다.
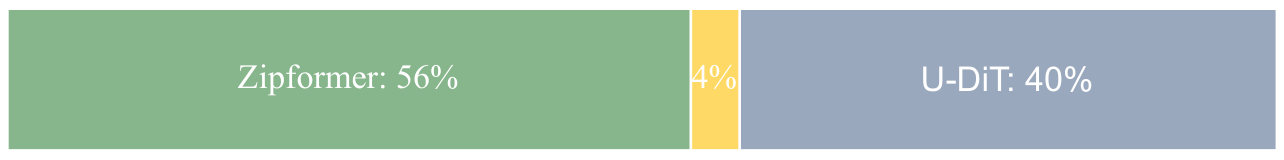
Zipformer 쪽을 더 선호한 비율은 56%, U-DiT는 40%다. 차이는 16%포인트이고, 4%는 뚜렷한 선호가 없었다. 이 표본에서는 더 가벼운 구조가 청취 평가에서 불리하지 않았다는 근거다. 저자들은 장거리 관계를 다루는 능력과 안정적인 학습을 가능한 이유로 든다. 그러나 해당 설명을 따로 분리해 검증한 실험은 없다.
평가자 수, 비교한 음성 쌍의 수, confidence interval이 제시되지 않아 56%의 통계적 안정성을 계산할 수 없다. 또한 하나의 막대를 근거로 품질·화자·운율 각각에서 모두 56%를 받았다고 쓰면 안 된다. 뒤의 속도표에서는 계산량 감소를, 이 그림에서는 특정 청취 비교의 선호를 읽는 것이 맞다.
13. RTF 분석: 25Hz·Zipformer의 2.28배 속도 개선 조건
RTF가 0.232라면 해당 모듈이 음성 1초에 해당하는 계산을 하는 데 평균 0.232초를 썼다는 뜻이다.
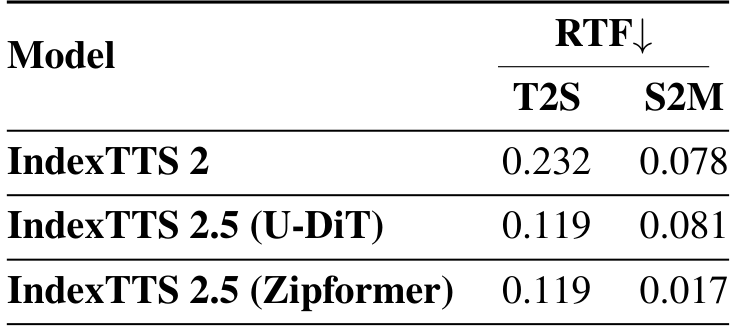
낮을수록 빠르다. 첫 행 IndexTTS2는 T2S 0.232, S2M 0.078이다. 2.5의 U-DiT 버전은 0.119·0.081, Zipformer 버전은 0.119·0.017이다.
두 주요 모듈의 합을 기준으로 속도 비율을 계산하면 다음과 같다. 이 식은 원문 표의 값을 읽기 쉽게 계산한 것이며, 원문에 번호가 붙은 새 학습 objective function이 아니다.
분자는 전작의 T2S와 S2M 시간 계수의 합, 분모는 Zipformer를 쓴 2.5의 합이다. 비율은 약 2.28이고 시간 계수의 감소율은 약 56.1%다. ‘시간이 2.28% 줄었다’와는 전혀 다른 값이다. 10초 음성으로 환산하는 산술 예시에서는 두 모듈의 합이 약 3.10초에서 1.36초가 된다. 이것은 표의 비율을 10초에 적용한 계산이며 직접 측정한 생성 시간은 아니다.
변경의 위치도 보인다. T2S는 0.232→0.119로 약 1.95배 빨라진다. 같은 2.5 안에서 S2M 구조를 바꾼 효과는 0.081→0.017로 약 4.76배다. 반면 2.5 U-DiT의 S2M 0.081은 전작의 0.078보다 약간 느리다. ‘2.5의 모든 모듈이 항상 빨라졌다’는 표현은 맞지 않는다.
이 표에 vocoder 시간, 파일 읽기·쓰기, 모델 로딩, 네트워크 전달, 첫 음성이 나오기까지의 지연, 동시 요청 수별 성능은 없다. 두 모듈 합으로 얻은 2.28배를 서비스 전체의 속도나 첫 응답 시간에 그대로 적용할 수 없다. 또한 Figure 4의 선호 결과는 품질 변화의 한 근거지만, 압축·구조 교체의 모든 언어별 품질 저하가 0임을 증명하는 것은 아니다.
14. G2P 발음 제어: language conditioning과의 차이
다국어 모델에 일본어라고 알려 줘도 한자의 문맥별 읽기는 여전히 어려울 수 있다. G2P, grapheme-to-phoneme는 글자 표기를 발음 정보로 바꾸는 과정이다. 언어 선택이 ‘어떤 언어의 규칙을 쓸지’라면 G2P는 ‘이 단어를 구체적으로 어떻게 읽을지’에 가깝다.
중국어·영어에서는 발음이 모호하지 않은 사전 항목을 사용하고, 영어에는 CMU 발음 사전을 이용한다. 일본어에서는 한자를 무작위로 골라 fugashi로 가타카나 읽기를 얻는 방식을 설명한다. fugashi는 일본어를 단어 단위로 분석하고 읽기 정보를 얻는 데 사용하는 도구다. 논문은 문장 전체에서 무작정 치환하면 문맥에 맞지 않는 읽기가 생길 수 있어 분절한 단위 안에서 변환하는 방식을 제안한다.
예를 들어 문맥상 서로 다르게 읽히는 한자 단어를 단순 문자 치환표로 처리하면 원하는 발음이 나오지 않을 수 있다. 단어 경계를 먼저 잡고 그 단위의 읽기를 얻으려는 이유다. 다만 G2P 기능 하나를 켜고 끈 비교나 언어별 동형어 실패율 표는 제공되지 않는다. 설계와 지원 형식은 설명할 수 있지만, 모든 다의어 오류가 해결됐다는 결론은 근거를 넘는다.
공개 코드에서는 <word|reading> 형태로 사용자가 읽기를 명시하는 경로와 일본어 자동 전처리가 구분된다. 검토한 inference 코드는 일본어 자동 확률 치환 비율을 0으로 초기화한다. 논문의 학습용 치환 설명을 보고 배포본이 모든 한자를 자동으로 가나로 바꿔 읽는다고 가정하면 결과가 달라질 수 있다.
15. IndexTTS2.5 코드: DiT·duration_factor·감정 API
15.1 v2.5.0과 model config의 DiT 경로
이 글에서 대조한 코드는 v2.5.0 태그의 커밋 39207d91c30899cad1e7c1b9eb678c241f678e55, 2026년 8월 13일 상태다. 모델 저장소의 설정은 c39ce5ba981572cb187443877ff559dfb246ce63, 8월 12일 리비전이다. 움직이는 최신 브랜치의 결과와 섞지 않기 위해 두 버전을 따로 기록했다.
weight는 내려받지 않았고 GPU inference·학습도 실행하지 않았다. 아래 설명은 코드와 설정을 읽은 관찰이다. 사용자가 직접 재현한다면 코드, 모델 weight, 보조 모델, 전처리 설정과 테스트 문장을 함께 고정해야 한다. 코드만 고정하고 처음 실행할 때 내려받는 보조 모델이 바뀌면 같은 입력에서도 비교 조건이 달라질 수 있다.
| 항목 | 논문의 설명 | 검토한 공개 구현 | 재현에서 생기는 차이 |
|---|---|---|---|
| S2M 중심 구조 | Zipformer의 속도·선호를 보고 | 설정과 생성 경로는 DiT | 최저 RTF 0.017 행을 바로 재현한다고 할 수 없다 |
| token별 언어 조건 | 언어 vector를 연결하는 방식 | 텍스트 vector에 언어 vector를 더하고 언어 접두사도 넣음 | 세 입력 실험 중 하나와 완전히 동일하다고 단정할 수 없다 |
| 길이 제어 | 입력의 보조 길이 embedding을 설명 | semantic token 생성 후 mel 길이에 배율 적용 | 목표 token 수 제어와 배포 API의 길이 배율이 다르다 |
| GRPO | 네 후보·WER·SS reward | 확인한 저장소에 해당 학습 설정과 RL checkpoint 계보가 없음 | gpt.pth만 보고 RL 행의 모델이라고 할 수 없다 |
| 일본어 읽기 | 한자 일부를 가타카나로 바꾸는 학습 전략 | inference 코드의 자동 치환 비율은 0, 수동 읽기 지정은 별도 | 학습 데이터 변환과 기본 inference 동작을 구분해야 한다 |
이 표에서 가장 큰 차이는 S2M이다. 공개 config.yaml은 dit_type: DiT, 13개 층, UViT 건너뛰기 연결을 지정한다. inference 코드의 S2M 생성 경로를 따라가면 이 설정으로 CFM이 DiT를 구성하고 다른 종류에는 오류를 내는 코드에 도달한다. 단순히 파일 이름에 DiT가 남아 있는 정도가 아니라 실제 구성 경로가 그렇다. 그러므로 이 버전의 코드로 얻은 실행 시간을 논문의 Zipformer 행과 같은 구현의 재현값이라고 쓰면 안 된다.
실제 진입점은 infer_v2_5.py이며 내부에서 model_v2.UnifiedVoice를 불러온다. 파일 이름에 2.5가 붙은 다른 모듈을 읽는 것만으로 실행 경로를 확인했다고 할 수 없다. 저장소의 TensorRT 경로도 README상 IndexTTS-2용이므로, 이를 2.5의 Zipformer 대체 구현으로 취급하지 않는다.
언어 조건도 연산까지 확인했다. 텍스트와 위치 embedding을 만든 뒤 text_emb += self.lang_embedding(langs[i])를 수행한다. 같은 언어 vector를 해당 입력의 텍스트 token에 더하는 방식이다. 동시에 tokenization 전에는 <|en|> 같은 언어 접두사도 붙는다. 논문의 연결 방식이라는 표현과 공개 구현의 덧셈을 동일시하지 않고, 혼합 언어의 token별 식별도 실제 입력 경로에서 따로 확인해야 한다.
15.2 Codec frame rate와 duration_factor 적용 위치
공개 codec은 기본적으로 시간 축을 두 배 간격으로 줄이는 convolution을 사용한다. 번호로 압축한 뒤 decoding할 때는 특징을 두 배로 늘려 복원한다. 따라서 semantic token을 25Hz로 생성한다는 설명과 S2M 앞에서 더 촘촘한 특징을 쓰는 것은 모순이 아니다. 이산 token의 수와 복원된 연속 특징의 길이는 다르다.
duration_factor는 텍스트에서 semantic token을 생성한 뒤에 적용된다. 공개 코드는 decoding한 특징의 길이에 1.72와 이 배율을 곱하고 정수로 바꿔 목표 mel 길이를 정한다. 이후 길이 조절 모듈이 그 길이에 맞춰 특징을 보간한다. 목표 semantic token 수를 먼저 알려 주고 그 개수에 맞게 autoregressive 생성하는 전작 논문의 방식과 같은 제어가 아니다.
모델카드는 배율 0.5∼2.0을 안내하며 1보다 크면 더 길게, 1보다 작으면 짧게 말하도록 설명한다. 검토한 원시 API에서 이 범위를 강제하는 검사는 확인되지 않았다. 범위 밖의 값이나 임의의 초 단위 목표를 안전하게 처리한다고 가정하면 안 된다. 길이에는 mel 프레임 반올림과 문장 사이 침묵도 영향을 준다.
출력 쪽 설정은 sample rate 22,050Hz, mel hop 256sample을 사용한다. 같은 YAML의 데이터 부분에 24,000Hz가 있다고 해서 최종 출력까지 24kHz라고 단정하지 않는다. 실행 경로에서 사용하는 S2M·vocoder 설정을 따라가야 한다.
15.3 Inference 예제: lang·use_qwen_emo·emotion vector
다음은 고정한 공개 API의 호출 구조를 설명하는 예시다. 직접 실행한 결과가 아니며, 모델과 보조 weight 및 환경 준비가 선행돼야 한다. speaker.wav에는 사용할 권한이 있는 실제 참조 녹음의 경로를 넣는다.
from indextts.infer_v2_5 import IndexTTS2
tts = IndexTTS2(
    cfg_path="checkpoints/config.yaml",
    model_dir="checkpoints",
    use_bf16=True,
    use_qwen_emo=True,
)
tts.infer(
    spk_audio_prompt="speaker.wav",
    text="Please proceed to the next gate.",
    lang="EN",
    use_emo_text=True,
    emo_text="Speak calmly.",
    duration_factor=1.2,
    output_path="english_notice.wav",
)
참조 녹음은 누구의 목소리인지를, lang은 본문의 목표 언어를, 감정 지시는 말투를 지정한다. 이 예시에서 1.2는 출력이 정확히 특정 초에 끝난다는 약속이 아니라 S2M 길이 계산에 사용하는 배율이다. 본문 텍스트에 감정 지시를 섞어 넣으면 안내 방송이 그 지시까지 읽을 수 있으므로 두 입력의 역할을 구별한다.
감정 텍스트를 쓰려면 생성자에서 use_qwen_emo=True로 QwenEmotion 모델을 불러와야 한다. 기본값은 false다. inference 호출에 use_emo_text=True만 주면 실행 경로에서 오류가 난다. 감정 모델을 사용할지의 설정과 매 호출에서 감정 텍스트를 사용할지의 설정이 별개이기 때문이다.
직접 vector를 주는 경우에는 happy, angry, sad, afraid, disgusted, melancholic, surprised, calm 순서의 8개 값을 사용한다. 논문 계열의 이전 버전에서 설명한 7개 감정 분포와 입력 차원이 다르다. 공개 경로는 화자 특징과 가까운 감정 prototype를 선택하고 weight를 적용한다. 이를 모든 감정 예제의 평균 vector와 같은 것으로 가정하지 않는다.
일본어도 예외가 있다. JapaneseG2PProcessor는 읽기 추출과 일부 히라가나 변환 기능을 갖지만, 실제 inference 코드는 g2p_ratio=0으로 초기화한다. 반면 <단어|읽기> 형식으로 사용자가 가나를 지정하는 처리는 별도로 존재한다. 자동 변환 비율 0이라는 관찰은 수동 발음 제어까지 불가능하다는 뜻이 아니다.
15.4 Sampling·S2M step·GRPO checkpoint 재현 조건
기본 inference 설정은 top-p 0.8, top-k 30, temperature 0.8, beam 수 3, 반복 패널티 10, 최대 음성 token 1,500이다. top-p와 top-k는 다음 token 후보 범위를 제한하고, temperature는 후보 선택의 무작위성에 영향을 준다. 이런 값이 달라지면 같은 문장도 발음 오류와 운율이 달라질 수 있다.
코드는 do_sample 옵션을 읽지만 실제 음성 token 생성 호출에는 True를 전달한다. 따라서 해당 인자 하나를 false로 줬다는 이유만으로 매번 같은 결과를 내는 생성 조건을 만들었다고 판단하지 않는다. 기본 텍스트 분할 한도는 구간당 120token이며 긴 문장은 나누어 합친다. 구간 사이에는 기본 200ms 침묵을 넣는 경로가 있어 문장 전체의 운율과 길이에도 영향을 준다.
S2M은 25단계의 수치적 이동과 0.7의 조건 유도 계수를 사용한다. 조건 유도는 생성이 텍스트·참조 조건을 따르도록 방향을 조정하는 정도다. 계산 횟수와 계수가 바뀌면 속도와 품질의 비교도 달라진다. 논문의 하드웨어 이름만 맞추고 이 설정들을 기록하지 않으면 재현이라고 부르기 어렵다.
GRPO는 더 큰 공백이 있다. 확인한 공개 저장소와 모델 메타데이터에는 논문 실험을 그대로 실행할 reward 조합·학습 설정이나 현재 gpt.pth가 어떤 RL 행에 대응하는지의 명확한 계보가 없다. 공개 inference가 가능하다는 사실과 논문의 후속 학습을 완전히 다시 수행할 수 있다는 사실은 다르다. 이 글에서도 공개 weight가 RL 전인지 후인지 확인되지 않은 상태를 그대로 남긴다.
16. IndexTTS2.5의 한계와 언어별 검증 방법
IndexTTS2.5의 기여는 다국어 합성을 언어 수의 확대만으로 보지 않고, 데이터 정리·조건 전달·token 길이·복원 계산·후속 reward를 함께 다룬다는 데 있다. 다섯 언어의 내용과 음색을 따로 보고, 중국어 참조의 교차 언어 성능과 감정 전이를 추가로 측정한다. 이 덕분에 ‘더 자연스러워졌다’라는 주장보다 구체적으로 개선과 손해를 읽을 수 있다.
저자들이 직접 설명하는 한계에는 긴 발화에서의 경계 조건 약화, token별 언어 식별의 시스템 복잡성, 자연어 지시의 중복, 일본어 읽기 변환의 문맥 문제가 있다. 추가로 원문과 공개 자료를 대조하면 학습 데이터 총량의 불일치, 평균 WER 소개 문구와 표의 충돌, 언어별 RL 퇴행, 평가 불확실성의 누락, Zipformer와 공개 DiT의 차이가 보인다. 앞의 설계상 설명과 뒤의 대조 관찰은 구별해서 기록해야 한다.
실제로 도입할지를 판단한다면 먼저 같은 화자·같은 목표 문장·같은 언어 방향을 정하고 기본 모델과 RL 모델의 weight 대응부터 확인하는 편이 좋다. 그다음 내용 오류, 화자 유사도, 감정의 자연스러움, 전체 생성 시간과 첫 음성 지연을 각각 측정한다. 긴 문장·숫자·고유명사·언어 혼합·낮은 감정 강도처럼 표의 평균이 가릴 수 있는 조건도 별도로 나누어 본다.
속도 실험에서는 실제로 공개한 구조가 DiT인지 Zipformer인지 확인하고 vocoder와 입출력까지 포함한 시간을 남겨야 한다. 길이 실험에서는 duration_factor를 바꿨을 때 최종 초 단위 길이와 WER가 어떻게 달라지는지 함께 본다. 감정 실험은 자동 지표와 독립 청취 평가를 같이 두어, 평가 모델에 맞춘 개선과 사람이 느끼는 개선이 일치하는지 살핀다. 이는 이 글에서 실행한 결과가 아니라 남아 있는 불확실성을 줄이기 위한 실험 설계다.
이 버전의 보고서에는 별도 부록이 없으며, 마지막 세 쪽은 참고문헌이다. 본문의 네 그림과 여섯 표, 방법·학습 자료·비교 조건을 모두 위의 해당 절에서 다뤘다. 참고문헌에 이름이 등장한다는 이유로 다른 모델의 결과를 이 모델의 추가 실험처럼 취급하지 않는다. 인용할 때는 IndexTTS 2.5 Technical Report, arXiv:2601.03888v5와 대조한 코드·모델 버전을 함께 남기는 것이 정확하다.
이 모델을 살펴볼 가장 강한 이유는 여러 언어에서 화자 복제와 감정 전이를 함께 다룬 구체적인 비교 결과다. 가장 신중해야 할 지점은 논문의 가장 빠른 구조와 공개 구현이 같지 않고, 평균 개선에도 언어별 손해가 남는다는 점이다. 어느 언어의 어떤 목소리로 무엇을 읽힐지 정한 뒤, 그 조건에 맞춰 검증해야 이 보고서의 장점을 실제 작업으로 옮길 수 있다.
17. 출처
- 원문 PDF, arXiv:2601.03888v5: method·학습 설정·전체 실험과 figure·table의 근거.
- 검토한 코드: 본문에서 대조한 공개 구현·설정의 고정 버전.
- 고정한 모델 설정: 본문에서 대조한 공개 구현·설정의 고정 버전.
자료 확인·수정: 2026년 9월 16일. 검토한 원문과 공개 구현의 버전은 위에 고정했다. 이번 수정에서는 전문 용어, 설명 문장, 검색 주제가 드러나는 제목과 이미지 배치를 보완했다.
관련 글
Paper Review
IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System — voice cloning·병음 발음 제어 분석
IndexTTS v1의 SEQ3 입력, Conformer·Perceiver와 BigVGAN2 구조를 설명한다. 병음 교정률 94%의 분모, CER·WER·SS·MOS와 inference 속도를 원문 figure·table과 코드로 분석한다.
Paper Review
A Defense of the Quadratic Model — LLM 학습의 Gauss–Newton 근사와 안정성 분석
A Defense of the Quadratic Model의 Gauss–Newton 근사, Lanczos spectrum과 학습 안정성을 설명한다. batch 64 예제, 원문 figure·table, 공개 코드로 근사가 맞는 조건과 반례를 분석한다.
Paper Review
IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech — 감정·발화 길이 제어 원리 분석
IndexTTS2의 T2S·S2M, GRL 감정 분리, GPT latent와 duration control을 설명한다. WER·SS·MOS, ablation과 공개 inference 코드의 제한을 원문 figure·table로 분석한다.