IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System — voice cloning·병음 발음 제어 분석
IndexTTS v1의 SEQ3 입력, Conformer·Perceiver와 BigVGAN2 구조를 설명한다. 병음 교정률 94%의 분모, CER·WER·SS·MOS와 inference 속도를 원문 figure·table과 코드로 분석한다.
- #논문 리뷰
- #IndexTTS
- #zero-shot TTS
- #voice cloning
- #발음 제어
- #WER
원문: Wei Deng, Siyi Zhou, Jingchen Shu, Jinchao Wang, Lu Wang, IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System. bilibili 연구진의 arXiv:2502.05512v1, 2025년 2월 8일 공개, 전체 5쪽을 기준으로 읽었다. 이 버전은 arXiv 사전 공개 논문으로 표기한다. 후속 IndexTTS 모델의 기능과 결과는 이 글의 평가 대상에 섞지 않는다.
논문 정보 · 원문 PDF · 검토한 v1 inference 코드 · 저자 데모
원문 그림과 표는 PDF에서 발췌했으며 각 캡션에 위치를 표시했다. 추가한 세 설명도는 원문과 공개 코드의 내용을 편집팀이 재구성한 것으로, 원본 crop과 구분해 표시했다. 본문의 수치는 저자들의 실험 결과다. 공개 코드는 읽고 설정을 대조했지만, 모델 학습이나 음성 생성 성능을 새로 재현하지는 않았다.
1. IndexTTS v1 요약: 병음으로 발음을 고치는 zero-shot TTS
IndexTTS v1이 제시한 세 contributions는 한자·pinyin hybrid 입력을 통한 발음 교정, Conformer conditioning encoder와 BigVGAN2 decoder를 결합한 TTS 시스템, 다음자 발음·subjective·objective test set 공개다. FSQ의 speech token 표현과 reference transcript 없이 작동하는 inference는 이 시스템을 이해하기 위한 세부 설계다. 각 기능의 효과와 공개된 평가 자료의 역할을 구분해서 설명한다.
가장 직접적인 결과는 한자·pinyin 혼합 입력으로 원래 잘못 읽은 465문장 가운데 437문장을 고쳤다는 것이다. 437/465는 약 94%다. 입력 표현의 변경이 실제 발음 수정으로 이어진다는 근거이며, 전체 2,500문장 중 94%만 맞았다는 뜻은 아니다. 아래에서는 혼합 입력을 학습하는 방식과 이 평가의 분모를 이어서 설명한다.
voice cloning 쪽에서는 Conformer·Perceiver conditioning과 BigVGAN2를 결합한 시스템의 CER/WER, speaker similarity, MOS를 함께 비교한다. AISHELL-1 CER는 CosyVoice2 1.8%에서 IndexTTS 1.3%로, LibriSpeech WER는 기반 모델 XTTS 3.5%에서 2.1%로 낮아졌다. 보고된 speaker similarity AVG도 XTTS 0.663에서 0.776으로 높아졌지만 CosyVoice2·F5-TTS의 AVG에는 못 미친다. 즉 주요 성과는 발음 제어와 내용 일관성이고, 모든 품질 축에서 같은 우위를 얻은 것은 아니다.
이 글은 입력·음성 생성 구조 → 발음 제어와 교정 결과 → VQ/FSQ 선택 → 전체 TTS 품질과 속도를 따라간다. 구조 그림은 정보가 흐르는 경로를, 결과 표는 각 설계가 겨냥한 품질 지표를 설명하는 위치에 둔다.
2. Zero-shot voice cloning: 발음 정확도와 화자 유사도의 차이
텍스트 음성 합성, 즉 TTS는 글을 파형으로 바꾼다. Zero-shot voice cloning은 새로운 화자마다 모델을 다시 학습하지 않고, 참조 음성만으로 그 사람의 목소리 특징을 반영하는 설정이다. 학습 자체가 필요 없다는 뜻은 아니다. 이 논문의 모델도 중국어·영어 음성 3만 4천 시간으로 학습했다.
“안녕하세요”라는 내용과 그것을 읽는 사람의 목소리는 서로 다른 정보다. 문장을 정확히 읽어도 다른 사람처럼 들릴 수 있고, 목소리는 닮았는데 단어를 빼먹을 수 있다. 따라서 논문의 평가표도 내용 일치, 화자 유사도, 사람이 듣는 품질을 나누어 봐야 한다.
IndexTTS는 XTTS와 Tortoise 계열의 방식을 바탕으로 한다. 언어 모델이 파형의 모든 sample을 한 번에 예측하는 대신, 먼저 압축된 음성 표현을 순서대로 만든다. 이후 별도의 decoder가 이 표현을 실제 소리로 복원한다. 문장을 쓰는 모델과 녹음 신호를 만드는 모델 사이에 압축된 설계도가 있는 셈이다.
이 설명은 모든 음성 합성 시스템의 우열을 정하는 기준은 아니다. 논문은 다중 codebook 방식, 확산 기반 방식, 혼합 구조의 장단점을 설명하고 혼합 구조를 선택한다. 여기서 확산 방식이 느리거나 스트리밍하기 어렵다는 설명을 후속 모든 모델에 적용해서는 안 된다. 비교 대상의 버전과 구현에 따라 결과가 달라진다.
3. IndexTTS architecture: 텍스트·참조 음성에서 파형까지
3.1 텍스트 tokenizer와 reference audio의 conditioning 경로
예를 들어 중국어 안내 문장을 특정 화자의 목소리로 읽으려 한다고 하자. 텍스트 tokenizer는 안내 문장을 작은 기호로 나눈다. 참조 음성은 별도의 조건 encoder를 통과한다. 이 encoder는 “무슨 말을 새로 읽을 것인가”보다 “어떤 화자의 특징을 유지할 것인가”를 전달한다.
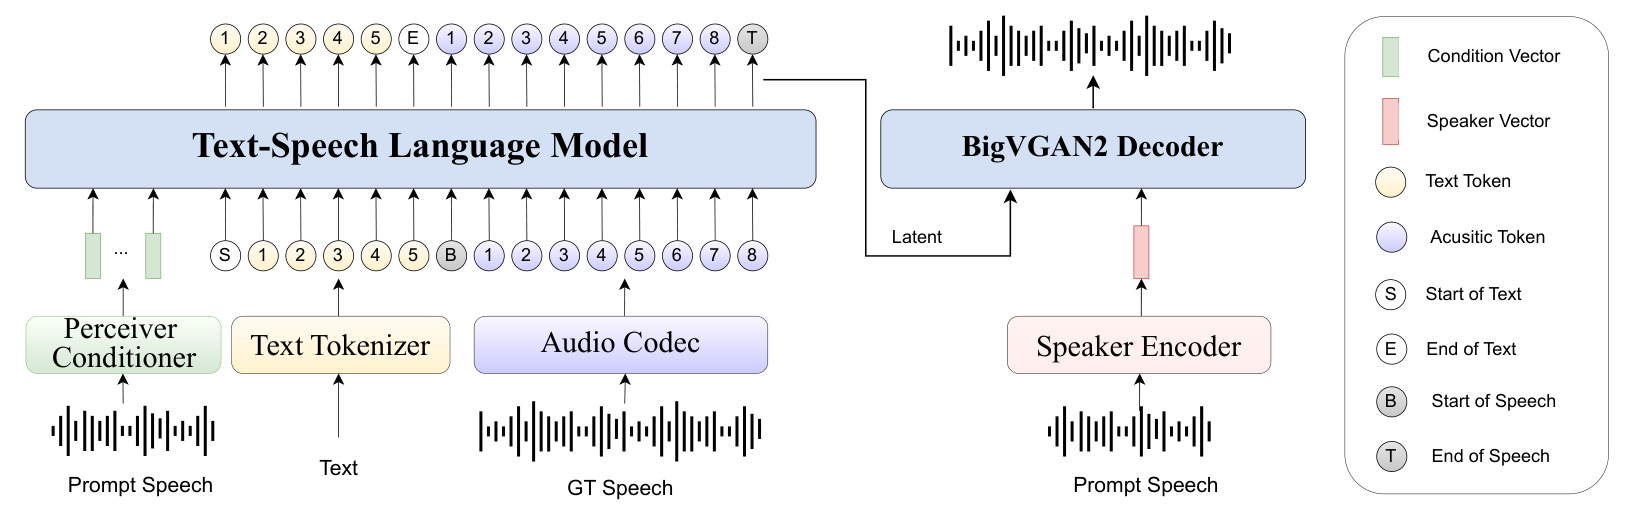
Figure 1에서 왼쪽의 Perceiver Conditioner는 참조 음성 정보를 언어 모델의 조건으로 보낸다. 아래의 Audio Codec은 학습할 정답 음성을 token으로 바꾼다. 이 정답 음성 입력은 학습 구조를 설명하는 부분이다. inference 때 새로 생성할 정답 녹음을 미리 제공해야 한다는 뜻이 아니다.
오른쪽에서는 참조 음성이 Speaker Encoder도 통과한다. 화자의 특징은 언어 모델 단계뿐 아니라 파형 생성 단계에도 전달된다. 두 경로를 합쳐 “음성 하나를 그냥 복사한다”고 이해하면 안 된다. 읽을 내용은 새 텍스트로 정하고, 참조 음성은 조건을 제공한다.
3.2 SEQ3: reference transcript 없이 speech token 생성하기
논문은 텍스트·음성 token을 배열하는 세 가지 형식을 비교해 설명한다. SEQ1은 참조 문장과 새 문장, 참조 음성과 새 음성을 길게 이어 붙인다. SEQ2는 텍스트에서 음성 token을 생성하는 배열이다. 저자들은 참조 전사문을 포함하는 음성 prompt inference 방식과, 화자 정보를 압축해서 넣는 SEQ3를 대비한다.
IndexTTS가 사용하는 SEQ3의 inference 시작 상태는 다음과 같다.
화자 조건 → 텍스트 시작 → 새로 읽을 문장 → 텍스트 끝 → 음성 시작입력에서 생성으로 넘어가는 경계를 그림으로 보면 다음과 같다.
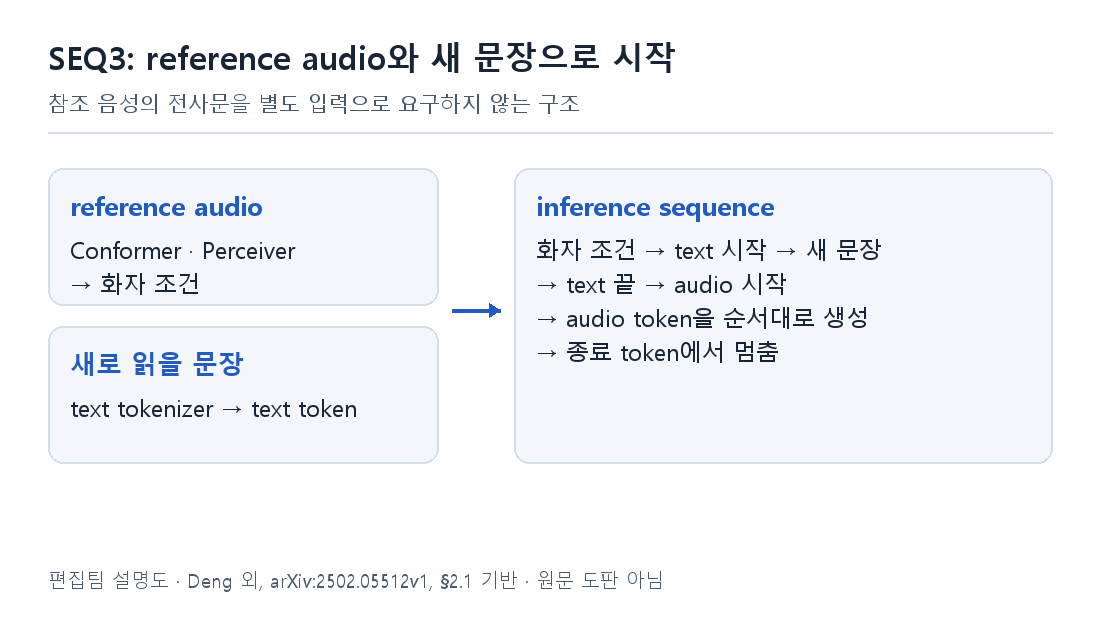
이 뒤에 음성 token을 하나씩 생성하고 종료 token에서 멈춘다. 따라서 입력 계약은 참조 음성 + 새 텍스트다. 참조 음성의 전사문을 별도로 적을 필요가 없다. 언어가 다른 참조 음성을 사용할 때 ASR로 먼저 받아 적는 단계를 줄일 수 있다는 것이 저자들의 설명이다.
다만 이 논문에는 SEQ1·2·3을 동일한 모델과 학습 예산으로 바꿔가며 얻은 결과표가 없다. 입력 구조의 차이는 확인할 수 있지만, 최종 성능 개선 중 얼마가 SEQ3 덕분인지 계산할 수는 없다.
3.3 Conformer·Perceiver conditioner의 역할
음성에서 화자를 구분하려면 순간적인 음색과 시간에 따른 변화가 모두 중요하다. Conformer는 주변 구간의 패턴을 보는 convolution과 멀리 떨어진 구간의 관계를 보는 attention을 결합하는 encoder다. 이 시스템에서는 참조 음성을 조건 표현으로 바꾸는 데 사용된다.
Perceiver는 길이가 다른 입력을 일정한 수의 latent representation으로 모으는 역할로 이해하면 된다. 참조 음성 길이가 달라도 언어 모델에 전달할 조건을 정리하는 것이다. 저자들은 이 조합이 화자 유사도와 실행 간 안정성을 개선한다고 설명한다. 그러나 화자 encoder만 바꾼 통제 실험이나 여러 참조 음성을 섞는 정량 평가를 별도로 제공하지 않는다. 저자들은 여러 참조 음성을 길이 제한 없이 활용하거나 다른 화자의 특징도 통합할 수 있다고 설명한다. 이는 논문의 기능 주장이다. 이 글이 확인한 초기 infer 함수는 참조 파일 하나를 받으며, 여러 화자 혼합의 품질이나 길이 확장 성능을 수치로 검증한 결과는 제시되지 않는다. 그 기능 설명과 검증된 성능 범위는 구분해야 한다.
3.4 Audio token·hidden state·BigVGAN2의 연결
파형은 초당 수만 개의 sample을 가진다. 이를 그대로 언어 모델이 다루기보다 음성을 적은 수의 token으로 압축하면 sequence가 짧아진다. 논문은 약 5천만 parameter 규모의 음성 tokenizer, 24kHz 입력, 약 25Hz 음성 token을 설명한다.
언어 모델은 이 token을 예측한다. 최종 파형 생성기는 token 번호만 다시 읽는 방식으로 설명되지 않는다. 논문은 언어 모델 마지막 hidden state, 즉 token을 결정할 때 사용한 연속적인 내부 표현을 BigVGAN2에 전달한다고 명시한다. 이 표현을 화자 조건과 함께 소리로 바꾼다.
본문은 25Hz 표현을 100Hz로 보간한 뒤 24kHz 파형을 만든다고 서술한다. 공개된 v1 설정에는 이 보간 분기가 꺼져 있는 차이가 있다. 이 차이는 뒤의 코드 절에서 별도로 확인한다. 논문의 개념도만으로 실제 checkpoint의 sample 수를 계산하면 맞지 않을 수 있다.
4. 병음 발음 제어: 학습 방식과 오류 교정률 94%의 의미
4.1 한자·병음 혼합 학습과 BPE 전처리
중국어에서는 한 글자가 문맥에 따라 다른 발음을 가질 수 있다. 이런 글자를 다음자라고 한다. 드물게 등장하는 글자도 모델이 발음을 잘못 배웠을 수 있다. IndexTTS는 한자와 병음을 함께 학습해, 사용자가 발음을 지정할 수 있게 한다.
훈련에서는 표본의 50%를 무작위로 고르고, 선택한 표본 안에서 중국어 글자의 20%를 후보로 고른다. 후보가 다음자가 아닐 때 해당 병음으로 대체한다. 훈련에서 모호하지 않은 대응을 가르치고, 사용 시에는 틀린 다음자의 올바른 발음을 병음으로 지정하는 구조다. “다음자만 골라 병음으로 바꾸며 훈련했다”는 설명과는 다르다.
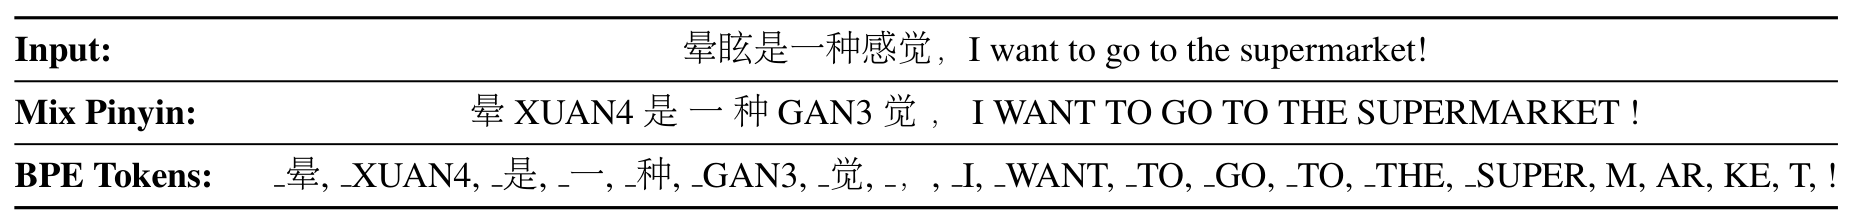
표의 XUAN4, GAN3에서 숫자는 성조를 나타낸다. 영어는 대문자로 정리되고, SUPERMARKET은 여러 조각으로 나뉜다. 이것이 BPE가 하는 일이다. 단어 전체에만 번호를 주는 대신 자주 나타나는 부분을 재사용한다. 텍스트 vocabulary는 총 12,000개이며, 논문은 중국어 글자 8,400개와 병음 1,721개, 영어 조각 및 특수 기호를 설명한다.
표 자체는 입력 변환 예시다. 이 예시 하나가 발음 교정률을 증명하는 것은 아니다. 실제 교정 효과는 다음의 별도 평가를 봐야 한다.
4.2 발음 교정률 계산: 전체 2,500문장과 오류 465문장
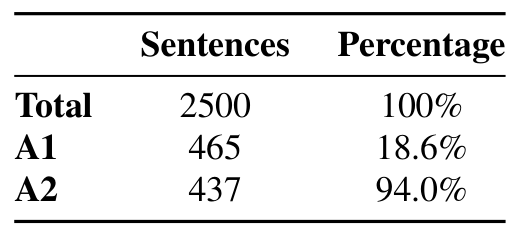
저자들은 다음자가 포함된 중국어 문장 2,500개를 평가했다. 먼저 한자만 입력했을 때 465문장에서 다음자 발음 오류가 발생했다. 전체의 18.6%다. 이후 이 오류 문장에 올바른 병음을 섞자 437문장이 교정됐다.
분모를 식으로 쓰면 혼동이 줄어든다.
여기서 437은 병음으로 교정된 문장 수, 465는 처음 틀렸던 문장 수다. 교정되지 않은 문장은 28개이며, 이는 원래 2,500문장의 약 1.12%다. 이 절차는 발견한 오류를 사람이 올바른 병음으로 고치는 상황을 평가한다. 전체 문장을 자동으로 재생성한 시스템의 종합 정확도를 그대로 측정한 수치는 아니다.
전체 평가 집합과 오류 집합을 나누어 놓으면 각 비율의 분모가 분명해진다.
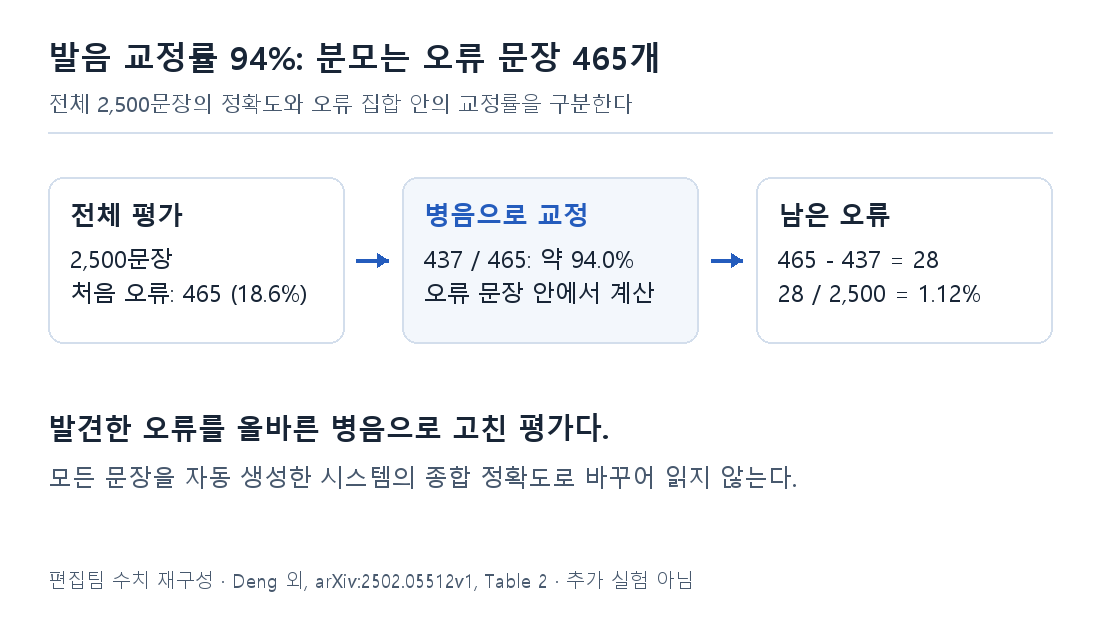
남은 오류가 잘못된 학습 데이터 때문일 수 있다는 설명은 저자들의 추정이다. 해당 28문장의 학습 데이터를 추적해 원인을 입증한 실험은 제시하지 않는다. “병음을 넣으면 반드시 발음이 고쳐진다”는 보장으로 읽어서는 안 된다.
5. VQ·FSQ 비교: audio token codebook 이용률
5.1 VQ와 FSQ의 quantization 방식
연속적인 음성 특징을 token 번호로 바꾸려면 quantization가 필요하다. VQ는 여러 대표 vector 중 가까운 것을 고른다. 큰 사전을 만들어도 일부 항목만 선택되면 나머지는 거의 쓰이지 않는다. 이것이 codebook 이용률이 낮다는 의미다.
FSQ는 각 좌표를 정해진 몇 단계 값으로 반올림하고, 그 조합을 기호로 쓴다. 학습으로 대표 vector 전체를 이동시키는 VQ와 다른 quantization 방식이다. 논문은 다른 모델 설정을 유지하고 quantizer를 바꿔, 6천 시간과 3만 4천 시간 데이터에서 이용률을 비교했다.
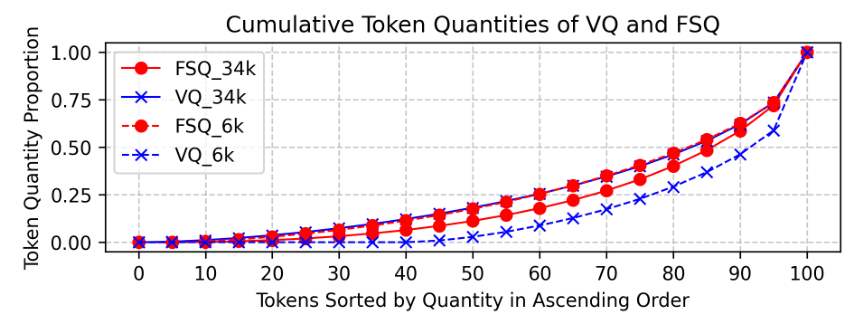
가로축은 사용 빈도가 낮은 token부터 정렬한 누적 위치다. 세로축은 그 token들이 전체 발생 횟수에서 차지하는 누적 비중이다. 곡선이 오른쪽에서 가파르게 오르면 자주 쓰는 일부 token에 사용량이 몰린다는 뜻이다. 논문이 말하는 “절반의 token이 80% 이상을 차지한다”는 설명은 빈도가 높은 절반으로 읽어야 한다.
5.2 6천·3만 4천 시간 데이터와 codebook size 비교
저자들은 6천 시간 조건에서 VQ 이용률이 약 55%라고 보고한다. 그러나 3만 4천 시간 조건에서는 VQ도 거의 100%에 접근한다. 따라서 이 결과는 “VQ는 본질적으로 코드 대부분을 낭비한다”는 결론을 지지하지 않는다. 적어도 이 설정에서는 데이터 규모가 결과를 바꾼다.
또 하나의 비교 조건이 있다. VQ는 8,192개 코드, 코드 vector 차원 512로 명시되어 있다. FSQ의 단계 수는 [8, 8, 8, 6, 5]다. 이 수를 곱하면 가능한 조합은 15,360개다. 명목 코드 수가 같은 두 quantizer를 비교한 것은 아니다. 이용률은 각자의 전체 코드 수를 분모로 사용하므로 이 차이를 남겨 두어야 한다.
이 실험은 quantizer 변경이라는 통제 비교지만, 최종 TTS의 음질·오류율·화자 유사도를 VQ와 FSQ별로 나눈 결과표는 없다. 사전을 고르게 쓴다는 사실만으로 소리가 더 좋다고 결론 내릴 수 없다. 실제 공개 v1 checkpoint의 설정은 VQ를 사용한다.
6. IndexTTS 학습 데이터와 CER·WER·SS 평가 조건
훈련 원자료는 인터넷 음성 12만 시간이다. 저자들은 Demucs를 이용한 음성 분리, 화자 구간 분리와 필터링을 거쳐 중국어 2만 5천 시간, 영어 9천 시간을 남겼다고 설명한다. 음성 인식으로 전사문을 만들고, 문장 의미와 실제 멈춤을 반영해 구두점을 추가했다. 구두점을 통해 멈춤을 제어하려면 학습 텍스트에도 멈춤 단서가 있어야 하기 때문이다.
평가는 네 dataset에서 진행했다. AISHELL-1과 LibriSpeech test-clean은 상대적으로 깨끗한 음성이다. CommonVoice에서는 중국어 2,000개, 영어 1,000개를 선택했다. 각 화자에게 둘 이상의 표본이 있는 조건에서, 평가 문장과 다른 동일 화자의 표본을 무작위로 참조 음성으로 고른다. 같은 녹음을 답안과 참조로 동시에 쓰는 설정은 아니다.
| 지표 | 실제로 계산하는 것 | 이 지표만으로 알 수 없는 것 |
|---|---|---|
| 중국어 CER | Paraformer가 인식한 글자와 기준 텍스트의 오류율 | 목소리가 자연스럽거나 같은 사람처럼 들리는지 |
| 영어 WER | Whisper-large V3가 인식한 단어의 오류율 | 중국어 CER와 완전히 같은 단위의 성능 |
| SS | ERes2Net 화자 embedding의 cosine similarity | 사람이 느끼는 전체 음질·운율 |
| MOS | 사람이 듣고 매긴 운율·음색·음질 점수 | 평가자·척도가 달라져도 유지되는 절대적 품질 |
CER는 글자, WER는 단어가 기준이다. 둘 다 낮을수록 내용이 잘 보존됐다는 신호지만 단위가 같지는 않다. SS는 두 음성의 특징 vector 방향이 얼마나 비슷한지를 본다. 녹음 환경과 화자 인식 모델의 특성도 영향을 줄 수 있어, 인간의 청취 평가와 순위가 달라도 곧바로 모순은 아니다.
7. TTS benchmark: CER·WER와 speaker similarity 비교
같은 dataset 안에서 모델별 CER·WER와 SS를 비교해야 한다.
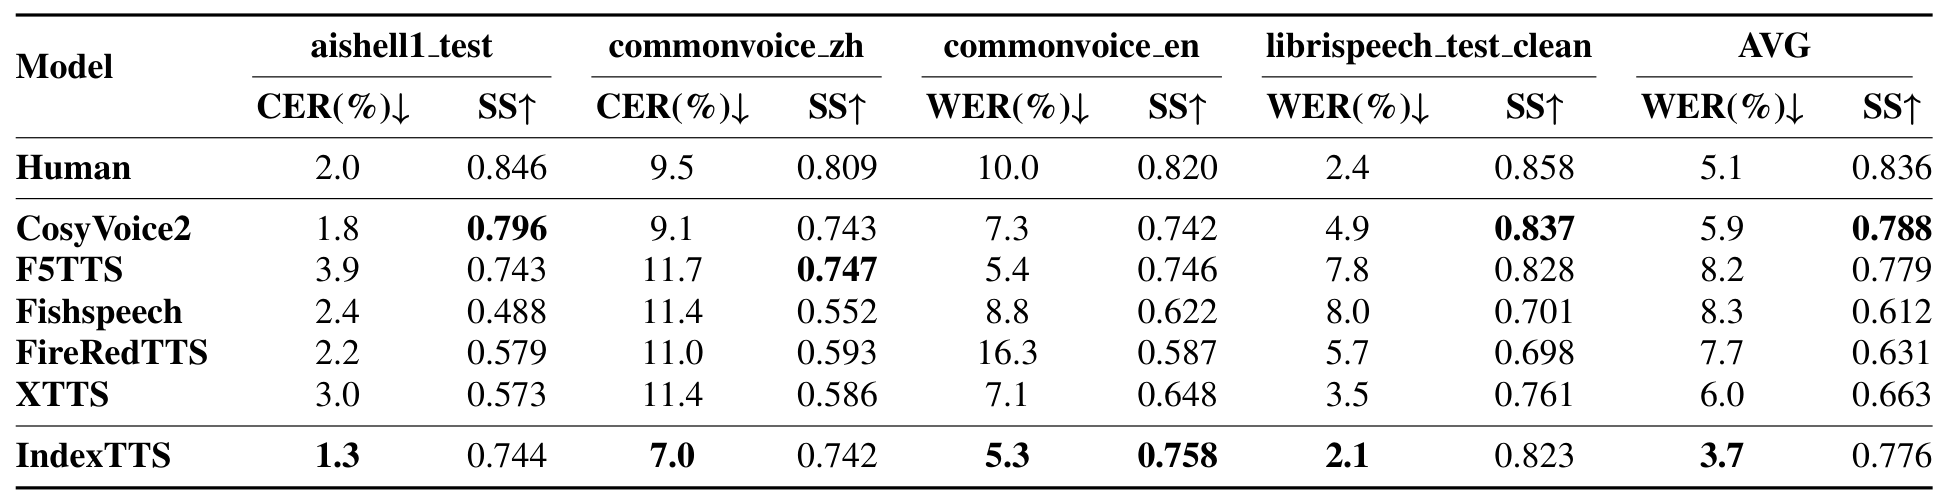
IndexTTS의 AISHELL-1 CER는 1.3%로 CosyVoice2 1.8%보다 0.5%p 낮고, CommonVoice 중국어는 7.0% 대 9.1%로 2.1%p 낮다. 영어 LibriSpeech WER는 XTTS 3.5%에서 2.1%로 줄었다. 네 테스트셋의 오류율 열 모두에서 비교 모델보다 낮은 값을 보인다. 즉 reference transcript를 요구하지 않는 구조에서도 내용 일관성을 확보했다는 것이 표의 주된 결과다. SS에서는 같은 순위가 유지되지 않으므로, 아래에서는 각 dataset의 오류율과 speaker similarity를 분리해 수치로 비교한다.
내용 오류율이 낮은 모델이 화자 유사도에서도 항상 앞서지는 않으며, 논문에 정의되지 않은 AVG 집계 방식은 별도로 가정하지 않는다.
7.1 AISHELL·CommonVoice 중국어의 CER
AISHELL-1의 CER는 CosyVoice2 1.8%에서 IndexTTS 1.3%로, 절대 0.5%포인트 낮다. CommonVoice 중국어는 9.1%에서 7.0%로, 2.1%포인트 낮다. 같은 두 모델을 비교해도 dataset에 따라 차이의 크기가 달라진다.
다른 비교 모델까지 보면 IndexTTS의 두 값은 각각 최저다. 그러나 모델별 학습 자료와 구조가 다르므로 이 표는 전체 시스템 비교다. 발음 혼합 학습이나 Conformer 하나의 인과적 효과를 분리한 실험은 아니다.
Human 행의 CER는 2.0%, 9.5%다. 합성 음성의 ASR 오류율이 이보다 낮다고 “사람보다 더 좋은 목소리”라는 결론은 나오지 않는다. 사람의 녹음에는 음성 인식기가 어려워하는 변동이 있을 수 있다. 이 지표가 측정하는 것은 기준 텍스트와 ASR 출력의 일치다.
7.2 LibriSpeech·CommonVoice 영어의 WER
CommonVoice 영어에서 IndexTTS의 WER는 5.3%이고 F5-TTS는 5.4%다. 이 비교의 차이는 0.1%포인트에 불과하다. 반면 LibriSpeech에서는 IndexTTS 2.1%, XTTS 3.5%로 1.4%포인트 차이가 난다. CosyVoice2 4.9%와 비교하면 차이는 더 커진다. 어느 모델을 기준으로 삼았는지 없이 “오류가 크게 줄었다”고만 쓰면 이 차이를 지워버린다.
Table 3의 AVG 오류율은 IndexTTS 3.7%, CosyVoice2 5.9%로 보고되어 있다. 다만 IndexTTS의 네 오류율을 단순 평균하면 3.925%다. 중국어 CER와 영어 WER가 섞여 있고, 논문은 AVG의 정확한 집계 weight를 설명하지 않는다. 따라서 원표의 집계값 3.7을 보존하되 단순 평균이라고 부르지 않는다. 이 리뷰도 새 weight를 추측해 값을 고치지 않았다.
각 비교의 confidence interval이나 반복 실행 분산도 제시하지 않는다. 특히 5.3과 5.4처럼 작은 차이는 표의 관측 순위와 통계적으로 확실한 우위를 구분해야 한다.
7.3 Speaker similarity와 AVG 집계의 한계
IndexTTS의 SS는 네 dataset 순서대로 0.744, 0.742, 0.758, 0.823이다. CommonVoice 영어에서는 비교한 합성 모델 중 가장 높지만, AISHELL-1과 LibriSpeech에서는 CosyVoice2가, CommonVoice 중국어에서는 F5-TTS가 더 높다.
AVG 열에서도 IndexTTS 0.776은 CosyVoice2 0.788보다 0.012 낮고 F5-TTS 0.779보다 0.003 낮다. 반면 기존 기반 모델인 XTTS 0.663보다 0.113 높다. 기반 모델 대비 개선과 비교한 모든 시스템 중 최고는 다른 주장이다. 이 표는 전자를 지지하며, 후자는 지지하지 않는다.
SS의 AVG 역시 네 열의 단순 평균과 일치하지 않는다. 출력된 네 값을 평균하면 IndexTTS는 0.76675, CosyVoice2는 0.7795, F5-TTS는 0.766이다. 단순 평균에서는 IndexTTS가 F5-TTS보다 아주 조금 높아져 두 모델의 순서도 바뀐다. 따라서 위의 0.776·0.788·0.779 비교는 논문이 보고한, 집계 방식이 설명되지 않은 AVG 열에 한정한다. 이것을 곧바로 네 dataset의 동일 가중 평균이나 모든 조건의 우위로 부르지 않는다.
8. MOS 청취 평가: prosody·음색·음질 결과
저자들은 전체 테스트셋에서 100개를 무작위로 골라 이중 맹검 MOS 평가를 수행했다. 운율, 음색 유사도, 음질을 나누어 평가한다. 이때 무조건 매끈한 낭독을 높게 평가하는 것이 아니라, 참조 음성의 말더듬·멈춤·공간감까지 얼마나 비슷한지를 중시했다고 설명한다.
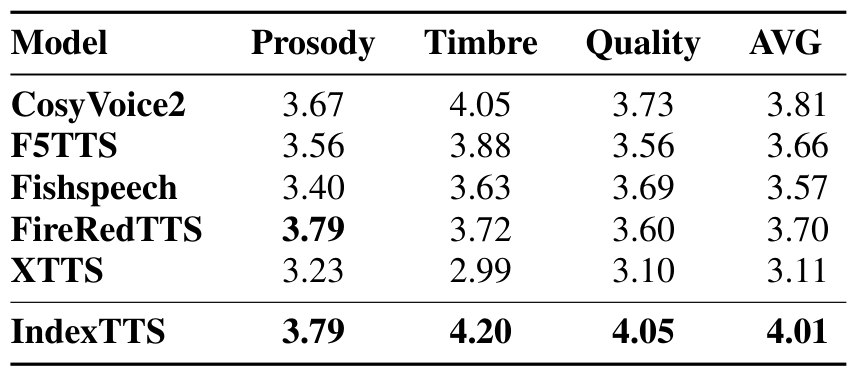
CosyVoice2와 비교하면 운율은 3.67→3.79, 음색은 4.05→4.20, 음질은 3.73→4.05다. 절대 차이는 각각 0.12, 0.15, 0.32점이다. 이 비교에서는 음질 차이가 가장 크다. AVG는 3.81→4.01로 0.20점 높다.
그러나 운율 3.79는 FireRedTTS와 같으므로 모든 항목에서 단독 1위라고 할 수 없다. 또한 평가자 수, 점수 척도의 상세 기준과 confidence interval을 충분히 제시하지 않는다. “100명이 평가했다”거나 “통계적으로 유의하게 우수했다”는 문장을 추가할 근거가 없다. 100은 선택한 음성 표본 수다.
앞선 SS의 보고 AVG에서 CosyVoice2가 높았던 것과 MOS에서 IndexTTS가 높게 나온 것은 측정 방법의 차이를 드러낸다. 어떤 결과를 사용할지 결정하려면 자동 화자 인식기의 점수가 필요한지, 실제 청취자가 느끼는 참조 음성 재현이 필요한지부터 정해야 한다.
9. Inference 속도: 생성 시간과 GPU utilization 비교
실행 시간 평가는 테스트 표본 200개를 무작위로 골라 합성한 총시간과 GPU 이용률을 측정했다. 논문에 나온 전체 표는 다음과 같다.
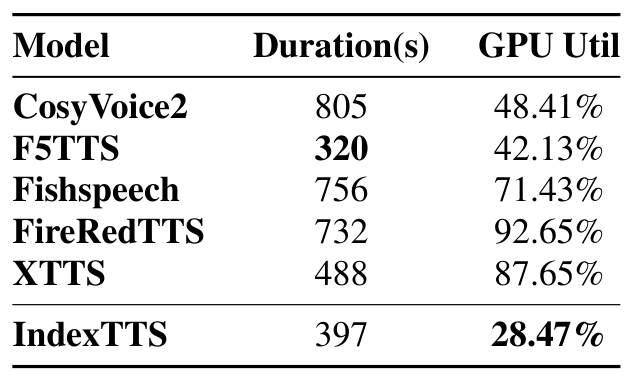
IndexTTS는 XTTS의 488초보다 91초 짧아 약 18.6% 감소했고, CosyVoice2의 805초보다 408초 짧아 약 50.7% 감소했다. 그러나 F5-TTS 320초보다 77초, 약 24.1% 더 오래 걸렸다. “기반 모델보다 빠르다”는 설명은 가능하지만 “비교 모델 중 가장 빠르다”는 설명은 표와 맞지 않는다.
GPU 이용률 28.47%는 해당 측정에서 GPU가 얼마나 사용됐는지 나타내는 값이다. 메모리 사용량이나 요금이 28.47%라는 뜻이 아니다. 이용률이 낮으면 자원이 덜 필요할 수도 있지만, CPU 처리나 순차 실행 때문에 GPU가 기다리는 시간이 많을 수도 있다. 이 표만으로 원인을 결정할 수 없다.
GPU 기종, 동시 처리 수, 생성한 총 음성 길이와 메모리 사용량도 명확히 제시하지 않는다. 따라서 실시간 계수, 특정 GPU에서의 throughput, 절감 비용을 이 숫자에서 새로 계산하지 않는다. 표는 저자들이 측정한 200표본 조건의 결과로 한정한다.
10. IndexTTS ablation: 확인한 효과와 분리하지 못한 효과
시스템에는 여러 변화가 함께 들어갔다. 한자·병음 혼합 입력, Conformer 기반 화자 조건, Perceiver, BigVGAN2, 학습 데이터 확대가 있다. 그러나 변화가 많다는 사실은 각 변화의 효과가 모두 입증됐다는 뜻이 아니다.
quantizer 비교는 VQ를 FSQ로 바꿔 이용률을 본 통제 실험이다. 발음 평가도 오류 문장에 병음을 추가했을 때 얼마나 고쳐지는지 직접 비교한다. 반면 Conformer만 제거하거나, BigVGAN2만 다른 decoder로 바꾼 성능표는 없다. Table 3–5의 모델 비교로 그 빈칸을 채울 수는 없다.
저자들이 밝힌 한계는 중국어·영어만 지원하고, 지시문에 따른 목소리 생성과 풍부한 감정 표현이 부족하다는 것이다. 웃음·망설임·놀람 같은 표현의 제어는 향후 과제로 제시한다.
추가 관찰은 구성요소별 효과 분리, 평가자·반복 실행 불확실성, 속도 실험 환경 정보가 부족하다는 점이다. 이는 “효과가 없다”는 증거가 아니다. 현재 공개된 결과만으로 어떤 설명까지 할 수 있는지를 제한한다. 특히 이후 버전에서 추가한 감정 제어를 이 첫 논문의 실험 성과로 소급해서 적으면 안 된다.
11. IndexTTS v1 코드: inference 입력과 재현 설정
11.1 논문 v1과 공개 코드·checkpoint 버전
현재 저장소의 최신 코드는 후속 모델을 포함할 수 있다. 이 글에서는 초기 inference 코드가 공개된 뒤의 2025년 3월 28일 커밋 c9bea55903f4b10e0fe5ca1ec01d12b4772dde99를 읽었다. README는 모델과 inference 코드 공개일을 3월 25일로 기록한다. 논문 제출일은 arXiv의 2월 8일을 사용한다.
checkpoint 설정은 IndexTeam/Index-TTS의 고정 리비전에서 확인했다. 설정 파일을 내려받아 읽었으며 모델 weight를 실행한 것은 아니다. 논문의 시스템 설명, 이후 공개된 실행 코드, 직접 실행한 결과를 같은 증거로 취급하지 않는다.
11.2 IndexTTS.infer 입력과 sampling 설정
inference 진입점은 indextts/infer.py의 IndexTTS.infer(audio_prompt, text, output_path)다. 참조 음성은 모노로 평균하고 24kHz로 resampling한다. 텍스트는 normalization 후 문장부호로 나뉘며, 문장별로 합성한 파형을 이어 붙여 24kHz의 16비트 정수 WAV로 저장한다.
from indextts.infer import IndexTTS
# 검토한 v1 코드의 입력 예시다. 이 리뷰에서 실행한 결과는 아니다.
tts = IndexTTS(cfg_path="checkpoints/config.yaml", model_dir="checkpoints")
tts.infer(
    audio_prompt="reference_voice.wav",
    text="欢迎来到我们的频道。",
    output_path="output.wav",
)
장치는 cuda:0으로 고정되어 있다. 초기화에서 DeepSpeed, KV cache, half precision을 끈다. 생성에는 do_sample=True, top_p=0.8, top_k=30, temperature=1.0, num_beams=3, repetition_penalty=10.0, 최대 음성 token 600을 사용한다. 생성 batch는 1, length_penalty는 0이다. 명시적인 난수 seed는 이 진입점에 없다. 생성된 코드에서는 마지막 두 위치를 codes[:, :-2]로 제거한 뒤 파형 생성에 쓸 hidden state를 다시 추출한다. 마지막 두 위치를 제거하는 근거는 이 코드만으로 확정하지 않는다.
이 값들은 읽은 공개 코드의 값이다. 논문의 속도 표가 정확히 이 설정으로 측정됐다고 확인한 것은 아니다. 같은 모델 이름만 맞추고 현재 기본값으로 실행하면 초기 논문과 동일한 조건이 되지 않는 이유다.
11.3 G2P와 TextNormalizer의 차이
논문은 글자를 발음 기호로 일괄 변환하는 G2P 전단을 없앴다고 설명한다. 그러나 실제 코드에는 숫자·문장부호 등을 정리하는 TextNormalizer가 있다. 병음 뒤의 성조 숫자를 복원하는 처리도 포함한다. 이후 CJK 글자를 나누고 영어를 대문자로 바꾼 뒤 SentencePiece에 넣는다.
따라서 “문자열을 아무 처리 없이 그대로 넣는다”고 이해하면 병음과 숫자가 다르게 처리되는 문제를 놓칠 수 있다. 상대 경로 checkpoints/bpe.model도 사용하므로 작업 디렉터리를 맞춰야 한다. checkpoint 폴더만 다른 곳에 복사한다고 모든 경로가 자동으로 따라 바뀌는 구조는 아니다.
11.4 Model size·VQ 설정과 audio frame rate
읽은 설정의 언어 모델은 20층, 차원 1,024, attention head 16개다. 텍스트 token 수는 12,000, 음성 코드는 8,194개이며 이 중 8,192와 8,193은 시작·종료 기호다. 설정의 최대 텍스트 token은 402, 최대 음성 token은 605이며, 앞서 inference 함수가 지정하는 생성 한도 600과 구분한다. 화자 조건은 6블록 Conformer와 Perceiver를 사용한다. 음성 tokenizer는 8,192개 코드와 512차원 코드 vector를 갖는 VQ다.
sample 단위에서는 논문과 차이가 있다. 설정의 24,000Hz와 압축 길이 1,024를 나누면 초당 23.4375개 표현이다. mel hop 256은 93.75Hz에 해당한다. 논문의 25Hz·100Hz를 정확한 정수 속도로 복사하면 실제 프레임 수와 어긋난다.
같은 1초라도 어떤 표현의 개수를 세는지에 따라 숫자가 달라진다. 아래는 논문 표기와 검토한 설정의 계산을 구분한 설명도다.
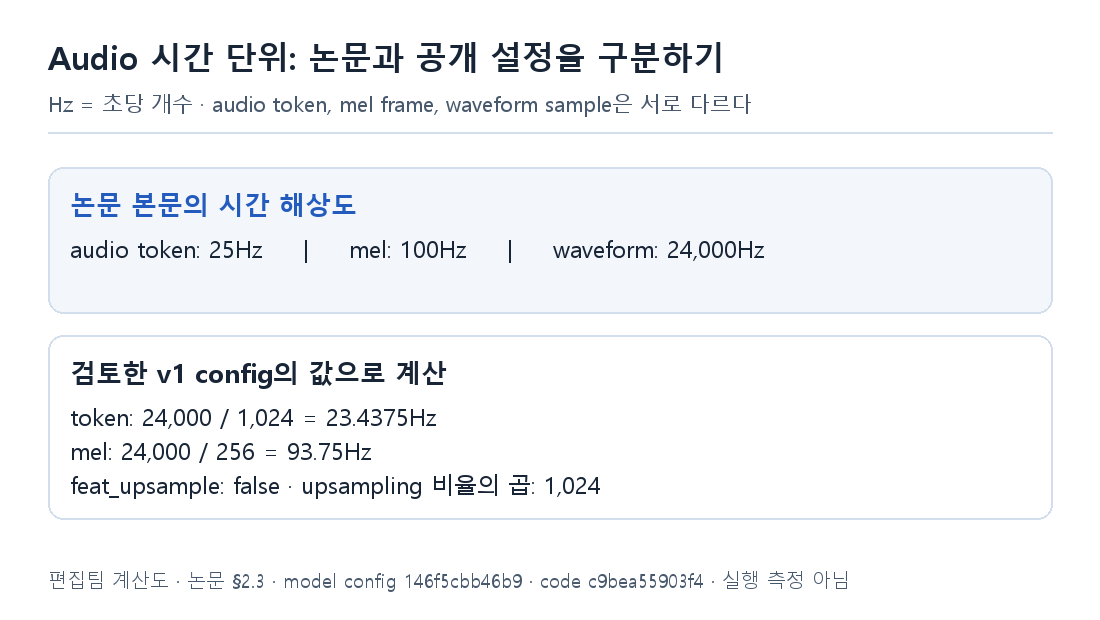
또한 설정의 feat_upsample: false 때문에 BigVGAN/models.py의 명시적 4배 선형 보간 분기는 실행되지 않는다. 대신 공개 설정의 upsampling 비율 [4, 4, 4, 4, 2, 2]의 곱은 1,024다. 논문의 “보간 후 decoder” 설명과 공개된 경로를 동일하다고 덮어쓰지 않고 차이로 기록한다. 어느 구현이 논문의 특정 실험에 사용됐는지 이 자료만으로 단정하지 않는다.
11.5 공개 inference와 원실험 재현의 차이
README는 Python 3.10과 ffmpeg 설치를 안내한다. 일부 라이브러리는 버전이 고정되어 있지만 PyTorch·CUDA를 포함한 전체 환경이 완전히 고정된 것은 아니다. 이번 검토에서는 그 환경을 설치해 음성을 생성하거나 사람의 청취 점수를 다시 측정하지 않았다.
검토한 커밋의 전체 파일 목록에는 원실험용 전체 학습 데이터나 끝까지 실행하는 학습·평가 pipeline이 없다. README는 테스트셋 공개를 설명하지만, 이 스냅샷 안에서 모든 평가 음성과 절차의 완결성을 확인할 수는 없다. 외부 데모가 있다는 사실도 전체 테스트셋과 평가 코드가 재현 가능하다는 증거와 다르다.
원실험을 재현하려면 먼저 모델·tokenizer·코드 리비전을 함께 고정하고, 네 dataset의 정확한 문장 목록과 참조 음성 매칭을 확보해야 한다. 그다음 ASR·화자 인식기 버전과 생성 설정, 반복 seed를 기록해야 한다. 속도는 GPU와 생성 음성 길이까지 함께 측정해야 비교할 수 있다. 논문이 공개하지 않은 learning rate·전체 학습 단계·하드웨어를 설정 파일의 일부 필드로 추측해 채워 넣어서는 안 된다.
12. IndexTTS v1의 한계와 후속 비교
IndexTTS 첫 논문의 실용적인 기여는 잘못 읽힌 발음을 사용자가 수정할 수 있는 입력 계약으로 만든 데 있다. 참조 전사문 없이 화자 조건을 주고, 언어 모델과 파형 생성기를 연결한 시스템의 평가도 함께 제공한다.
가장 강한 결과는 오류 집합에서의 병음 교정과 네 테스트셋의 낮은 내용 오류율이다. 가장 조심할 지점은 그 결과를 모든 음성 품질·속도·언어로 넓히는 것이다. 목소리 유사도와 청취 평가는 서로 다른 순위를 냈고, 가장 빠른 모델도 아니었다.
다음 비교로는 같은 데이터와 생성 설정에서 한자·병음 혼합, 화자 encoder, 파형 생성기를 하나씩 바꾸는 실험이 유용하다. 그래야 어느 변화가 발음 제어를 만들었고, 어느 변화가 음색·음질·실행 시간에 영향을 줬는지 분리할 수 있다. 이 논문은 그 출발점을 제공하지만, 모든 원인을 확정한 결과표까지 제공하지는 않는다.
13. 출처
-
IndexTTS 원문 PDF, arXiv:2502.05512v1: 전체 5쪽, Figure 1–2와 Table 1–5.
-
초기 v1 공개 코드 고정 커밋: inference·전처리·모델·decoder와 전체 파일 목록.
-
공개 checkpoint 설정 고정 리비전: 모델 크기, VQ와 음성 sample 설정.
자료 확인·수정: 2026년 9월 16일. 검토한 원문과 공개 구현의 버전은 위에 고정했다. 이번 수정에서는 전문 용어, 설명 문장, 검색 주제가 드러나는 제목과 이미지 배치를 보완했다.
관련 글
Paper Review
IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech — 감정·발화 길이 제어 원리 분석
IndexTTS2의 T2S·S2M, GRL 감정 분리, GPT latent와 duration control을 설명한다. WER·SS·MOS, ablation과 공개 inference 코드의 제한을 원문 figure·table로 분석한다.
Paper Review
IndexTTS 2.5 Technical Report — multilingual TTS·GRPO 학습 분석
IndexTTS2.5의 multilingual TTS, 언어 conditioning, GRPO와 25Hz codec을 설명한다. 언어별 WER·SS, cross-lingual 감정 전이와 Zipformer·공개 DiT 구현의 차이를 분석한다.
Paper Review
A Defense of the Quadratic Model — LLM 학습의 Gauss–Newton 근사와 안정성 분석
A Defense of the Quadratic Model의 Gauss–Newton 근사, Lanczos spectrum과 학습 안정성을 설명한다. batch 64 예제, 원문 figure·table, 공개 코드로 근사가 맞는 조건과 반례를 분석한다.