LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts — MoE inference 비용과 latent-space expert 분석
LatentMoE의 down-projection·expert·up-projection을 계산 예제로 설명한다. 95B·hybrid benchmark, 실제 throughput과 3.46배 simulation, Megatron-Core 구현의 조건을 구분한다.
- #논문 리뷰
- #LatentMoE
- #Mixture of Experts
- #MoE inference
- #latent space
- #throughput
원문: Venmugil Elango 외 NVIDIA 연구진, LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts. arXiv:2601.18089v1, 전체 18쪽을 읽고 작성했다. arXiv 최초 공개일은 2026년 1월 26일이며 PDF 표지와 연구 소개 글은 1월 27일을 표시한다. 여기서는 이 arXiv 기술 논문을 검토하며 별도로 확인하지 않은 학회 채택 이력을 붙이지 않는다.
논문 정보 · 원문 PDF · NVIDIA 연구 소개 · 검토한 후속 공식 구현
원문 그림 1–7과 표 1–5를 직접 발췌했다. 작은 그래프의 확대 영역과 표의 중요한 열은 별도 도판으로 덧붙였으며, 조합한 발췌에는 그 사실을 표시했다. 원문의 arXiv 배포 조건은 CC BY 4.0이다. 실험값은 논문 보고값이고, 비율·차이 계산은 그 값에 대한 편집팀의 산술이다. 공식 후속 코드는 정적으로 읽어 대조했다. 이 글을 위해 모델을 학습하거나 GPU 처리속도를 측정하거나 비공개 시뮬레이터를 실행하지 않았다.
1. LatentMoE 요약: expert 입력 폭을 줄여 MoE 비용 낮추기
LatentMoE의 핵심은 expert가 처리하는 vector 폭을 줄여 얻은 계산·전송 여유를 더 많은 expert 선택에 쓰는 것이다. 논문은 먼저 serving 병목을 분석하고, 그 분석에 맞춘 latent projection 구조를 제안한 뒤, accuracy와 실제 serving 비용을 나누어 검증한다.
비슷한 active parameter 규모에서 더 높은 benchmark 점수가 첫 번째 주요 결과다. 95B Transformer의 MMLU Pro는 standard MoE 29.26에서 Accurate LatentMoE 34.91로 5.65점 높아졌다. 약 73B Mamba-attention hybrid에서도 48.30에서 52.87로 4.57점 높아졌다. 서로 다른 두 model family에서 정확도 개선을 보였다는 것이며, 모든 task의 개선 폭이 같다는 뜻은 아니다.
두 번째 질문은 그 정확도를 얻기 위해 실제 inference 속도를 얼마나 지불하는가다. 73B hybrid 실측에서 concurrency 4의 throughput은 standard MoE 509.8, LatentMoE 528.5 tokens/s/GPU다. concurrency 1에서는 206.6→181.6, 128에서는 1725.9→1625.8로 낮아진다. 즉 구조만으로 항상 빨라지는 것이 아니라, 비슷한 serving 비용에서 더 높은 정확도를 얻는 trade-off를 보여준다.
Trillion-parameter 규모의 1.24–3.46배는 accuracy-matched 비교 모델을 구성한 simulation 결과다. 본문은 왜 기존 expert 계산이 비싼가 → latent 구조가 비용을 어떻게 바꾸는가 → 실제 학습의 accuracy와 throughput → 더 큰 모델의 예측 순서로 진행한다. 측정과 예측을 구분하면서 논문이 주장하는 accuracy per FLOP/parameter의 근거를 따라간다.
2. MoE inference 병목: expert 계산·memory·communication
2.1 Expert·router·active parameter의 의미
문장 속 다음 token을 예측하는 모델을 생각해 보자. 일반적인 dense model은 각 층의 같은 신경망을 모든 token에 적용한다. expert 혼합, 즉 Mixture of Experts(MoE)는 그 자리에 여러 expert 신경망을 두고 token마다 일부를 선택한다. 어느 expert에 보낼지 점수를 매기는 작은 장치가 router다. 점수가 높은 expert 몇 개만 고르는 방식을 top-k routing이라고 한다.
expert가 64개 있고 token당 6개를 고른다면, 그 층에 저장한 expert weight는 64개분이지만 한 token이 직접 거치는 expert weight는 6개분이다. 전자는 전체 parameter, 후자는 활성 parameter 차이를 이해하는 출발점이다. 실제 모델의 활성 parameter에는 attention, 항상 켜진 공유 expert 등도 들어가므로 단순히 전체 모델 크기의 6/64라고 계산할 수는 없다.
항상 켜지는 공유 expert는 여러 token에 공통으로 필요한 변환을 담당하도록 학습되는 경로다. 선택되는 expert와 달리 token마다 빠지지 않는다. 논문 그림에서 SE가 이 경로를 가리키며, E1·E2 같은 표시는 선택 가능한 expert를 가리킨다. 어느 expert가 “수학 전용”이라고 사람이 미리 정해 둔다는 뜻은 아니다.
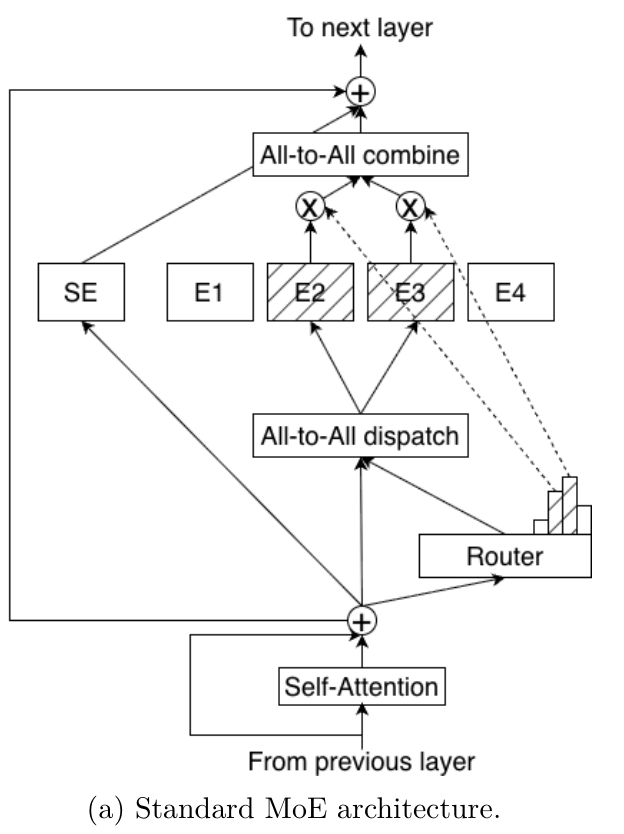
기본 MoE에서는 routed expert도 원래 hidden dimension의 입력을 받는다. LatentMoE가 줄이는 부분을 이해하려면 router와 shared expert까지 모두 압축하는 구조로 오해하지 않아야 한다.
2.2 Compute·memory read·all-to-all communication 구분
한 expert에 token 하나만 보내더라도 그 expert의 큰 weight 행렬을 읽어야 한다. 같은 expert에 token 수백 개를 묶어 보내면 읽은 weight를 여러 token의 계산에 활용하기 쉬워진다. 이 때문에 즉시 응답해야 하는 작은 batch와 많은 요청을 모아 처리하는 큰 batch의 병목이 달라진다. batch는 함께 처리하는 token 묶음이다.
작은 batch에서는 GPU가 계산할 준비를 마쳤는데도 메모리에서 weight가 도착하기를 기다릴 수 있다. 큰 batch에서는 계산을 충분히 묶더라도 expert가 여러 GPU에 분산돼 있어 전송을 기다릴 수 있다. FLOPs는 곱셈·덧셈 같은 부동소수점 연산량을 세는 값이다. 이 숫자에 메모리와 네트워크의 대기 시간이 그대로 들어 있는 것은 아니다.
따라서 이 논문이 묻는 질문은 “활성 parameter가 적은가”에서 한 단계 더 나간다. 정확도를 얼마 얻기 위해, 어떤 길이의 vector를 몇 군데로 보내고, 얼마만큼의 weight를 읽어야 하는가를 함께 묻는다. 실제 서비스에서 유용한 관점이지만, 뒤에서 보는 단순 비용식이 모든 시스템의 응답시간을 정확히 예측하는 것은 아니다.
3. MoE 성능 모델: memory bandwidth·communication 병목
3.1 Expert당 token 수와 weight 재사용
원문은 설명용 시스템으로 Qwen3-235B-A22B의 expert 128개, 활성 8개, token 폭 4,096, 중간 폭 1,536을 잡는다. expert를 64개 GPU에 나누면 GPU당 expert가 2개다. 이 설정은 뒤에서 학습하는 95B 모델의 설정과 다르다. 서로 다른 모델 이름을 같은 실험으로 이어 붙이면 안 된다.
논문은 GB200의 FP4 계산 피크를 10 PFLOP/s, HBM 메모리 대역폭을 8 TB/s로 두고 계산량과 읽어야 할 바이트의 비율을 분석한다. FP4는 이 모델에서 사용하는 4비트 수치 표현이며, PFLOP/s와 TB/s는 각각 초당 계산과 전송 능력이다. 1바이트를 가져올 때 충분히 많은 계산을 하지 않으면 메모리가 계산기를 따라가지 못한다.
그 경계는 논문의 가정에서 FLOP/byte다. 계산 강도는 “전송 1바이트당 수행하는 연산 수”라는 뜻이다. expert 하나가 처리하는 평균 token 수를 t라고 놓으면 원문의 단순 모델은 다음과 같다.
분자의 2tdm은 token 수와 행렬 크기에 따라 늘어나는 계산량이다. 분모의 dm은 weight 부분, t(d+m)은 token에 따라 늘어나는 데이터 이동 부분이다. token 수가 작을수록 weight 읽기를 여러 token이 나눠 쓰는 효과가 작다. 이 식의 계수는 논문이 선택한 FP4 expert 비용 모델에 따른다. 모든 SwiGLU·quantization 구현의 바이트를 그대로 세는 범용 공식은 아니다.
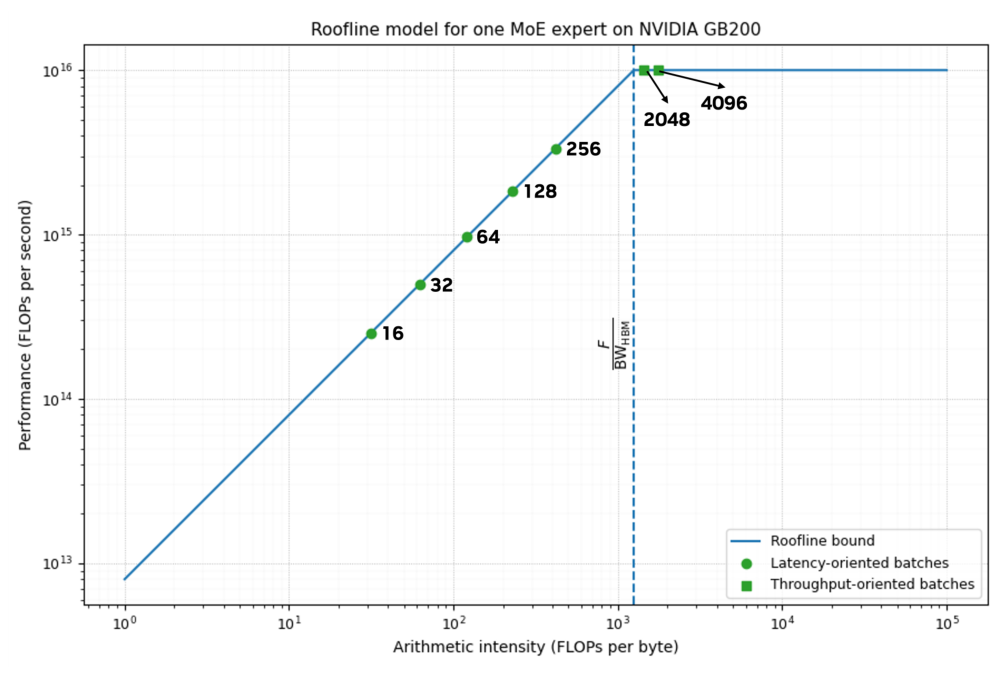
d=4,096, m=1,536을 넣으면 I가 1,250 이상이 되려면 expert당 약 1,418개 이상의 token이 필요하다는 것이 원문의 계산이다. 그림의 16·32·64·128·256은 전체 서비스 동시 접속자 수가 아니라 routing 뒤 expert 하나가 받는 token 수다. 낮은 지연이 필요한 요청에서 그 수가 작다면 큰 GPU의 이론상 계산 능력을 다 쓰기 어렵다는 설명이다.
이 그림은 지붕처럼 꺾이는 상한선을 그린 roofline 분석이다. 왼쪽에서는 메모리 공급량이, 오른쪽에서는 계산 피크가 상한을 정한다. 균등 routing, peak bandwidth, 선택한 데이터 이동식을 전제로 만든 분석이므로 실제 모든 모델에서 경계가 정확히 1,418이라고 다른 조건에도 그대로 적용할 수는 없다.
3.2 Large batch에서 communication이 커지는 이유
충분한 token을 묶어 expert 계산을 효율적으로 하더라도 token을 다른 GPU로 보내야 한다. 원문은 보낼 때 FP4 0.5바이트, 결과를 모을 때 BF16 2바이트를 가정한다. GPU당 expert 2개와 expert당 t개 token을 고려하면 한 층의 통신량은 5td에 비례하고, 두 expert 계산량은 4tdm에 비례한다.
통신 시간과 계산 시간의 비율을 나누면 t와 d가 상쇄된다.
F는 앞의 계산 피크, BWNVL은 한 방향 NVLink 대역폭이다. 논문은 양방향 1,800 GB/s를 각 방향 900 GB/s로 구별해 대입하고 약 9라는 비율을 얻는다. 양방향 값을 그대로 한 방향에 넣으면 다른 숫자가 나온다. 이 역시 단순 모델에서의 expert 단계 비교이며 실제 요청 전체에서 네트워크가 반드시 계산의 9배를 차지한다는 측정은 아니다.
여기서 중요한 설계 변수는 K·d다. 보내는 token의 대상 수 K나 vector 폭 d를 줄이면 전송량을 줄일 수 있다. expert 안쪽 중간층 폭 m만 줄이면 계산량은 줄어도 보내는 vector 크기는 그대로다. 따라서 FLOPs를 줄인 변화가 통신 병목에서는 속도 향상으로 이어지지 않을 수 있다.
4. LatentMoE architecture: down-projection·expert·up-projection
그림은 아래에서 위로 읽는다. 앞선 attention 계산을 마친 token 표현이 들어오면 세 갈래가 생긴다.
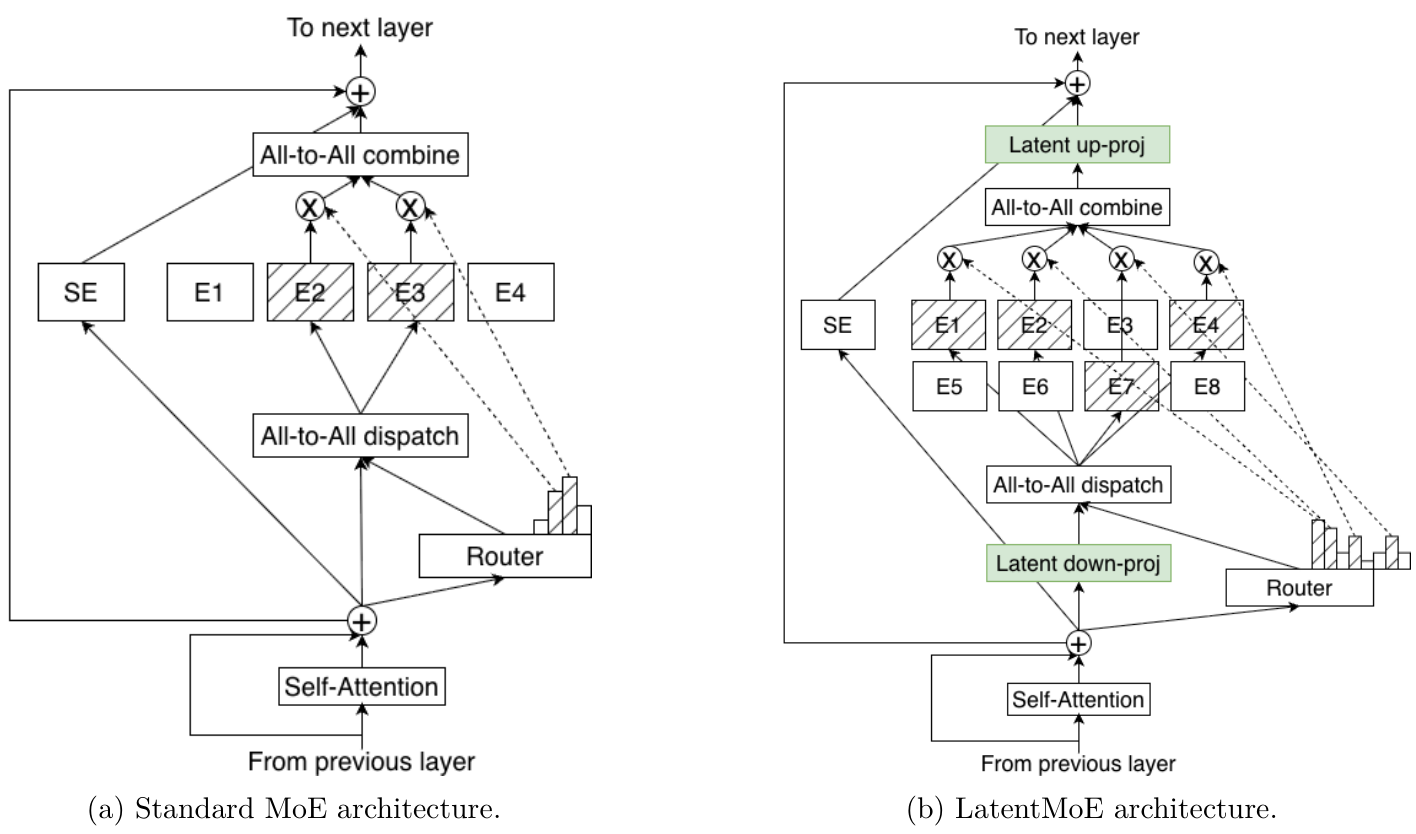
원래 크기의 입력은 router와 공유 expert로 간다. 선택된 expert에게 전달할 입력만 latent space로 낮추는 선형 변환을 거친다. 여기서 latent space는 학습한 변환으로 만든 더 짧은 vector 공간을 뜻한다. 원문 내용을 요약하는 자연어 문장을 만든다는 뜻은 아니다.
여러 GPU가 서로 필요한 token을 보내는 통신이 all-to-all dispatch다. 선택된 expert가 계산한 뒤 결과를 되돌려 모으는 과정이 combine이다. LatentMoE는 dispatch와 combine 모두 짧은 vector 공간에서 수행한다. 결과를 모은 다음 한 번 원래 폭으로 올리고, 공유 expert 결과를 더한다. 각 expert의 결과를 먼저 원래 폭으로 늘린 뒤 통신하면 논문이 노린 combine 통신 절감이 사라진다.
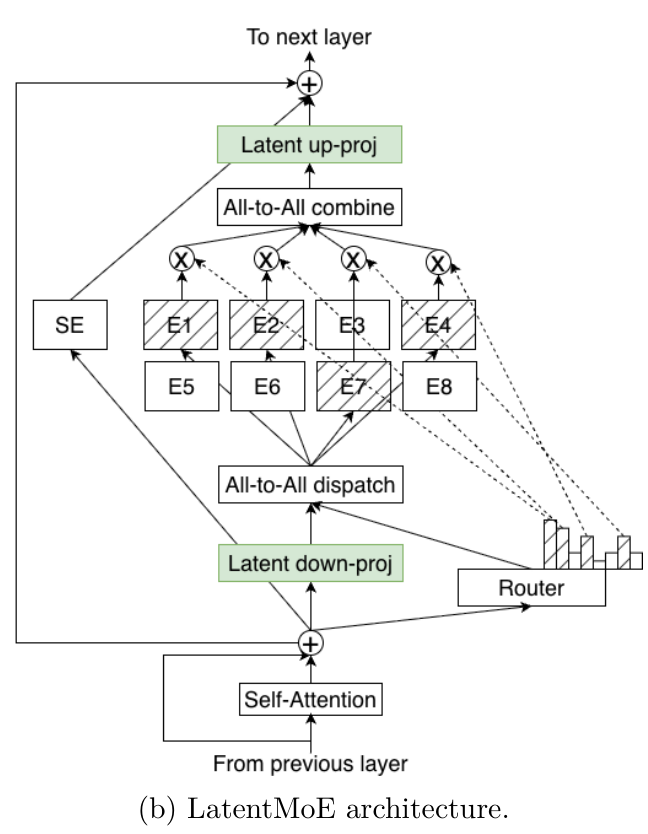
두 선형 변환은 expert마다 따로 만드는 것이 아니라 해당 MoE 층의 선택 expert 경로가 함께 사용한다. 선형 변환 자체도 학습할 parameter와 계산량이 있다. 따라서 expert 경로를 줄인 비율과 전체 모델의 실제 속도 향상 비율을 같게 놓을 수는 없다. attention과 공유 expert 비용도 그대로 남는다.
5. Latent-space 계산 예제: hidden size 2,048에서 512로
5.1 Latent size와 expert 수를 바꾸는 방법
논문의 작은 모델은 원래 token 폭 2,048, 전체 선택 가능 expert 64개, token당 활성 expert 6개를 사용한다. expert 내부에서 한 번 넓어지는 중간층 폭은 1,408이다. 원문은 이 값을 각각 d, N, K, m으로 쓴다. 공유 expert는 2개다.
압축비를 4로 정하면 expert 경로에 보낼 vector 폭은 512가 된다. 이 짧은 폭을 ℓ, 원래 폭을 나눈 비율을 α라고 쓴다. 전체 expert는 64×4=256개로 늘린다. 효율형은 그중 6개를, 정확도형은 6×4=24개를 고른다. 두 경우 모두 중간층 폭 1,408과 공유 expert 2개는 유지한다.
한 token을 보내는 숫자의 수만 단순히 세어 보자. 기존에는 6×2,048=12,288개, 효율형은 6×512=3,072개, 정확도형은 24×512=12,288개다. 정확도형이 더 많은 expert를 쓰면서도 같은 규모의 전송량을 유지한다는 말은 이 계산에서 나온다. 이 예제는 패딩·통신 메타데이터·로드 불균형을 뺀 원소 수 비교이며 실제 네트워크 측정값은 아니다.
5.2 Token의 projection·routing·expert 계산 순서
token을 압축하고, 선택 expert의 결과를 가중합한 다음 복원한다. 공유 expert 결과는 별도로 더한다. 두 변형을 한 식으로 나타내면 다음과 같다.
x는 원래 token vector다. 아래 화살표가 붙은 W는 d개 숫자를 ℓ개로 바꾸는 학습 행렬이고, 위 화살표 W는 다시 d개로 바꾼다. E는 expert 신경망이다. 선택 집합 T는 N′개 중 K′개 expert를 고른 결과이며, p′는 해당 expert 출력에 곱하는 router weight다. 마지막 합은 S개 공유 expert를 뜻한다. 원문의 식 1·2가 나눈 두 변형을 설명하기 위해 공유 expert의 인덱스 표기만 별도로 정리했다.
효율형에서는 N′=αN, K′=K다. 정확도형에서는 N′=αN, K′=αK다. router weight는 원래 입력 x로 계산하며 원문 수식은 로 적는다. router 행렬의 출력 행 수는 늘어난 전체 expert 수 N′에 대응한다. 폭 512의 압축 vector로 router를 호출하는 구현이라면 이 논문의 명시적 식과 달라진다.
예를 들어 2,048→512→1,408→512→2,048이라는 숫자 흐름을 생각하면 된다. 첫 번째와 마지막 변환은 공유하는 latent projection이고, 가운데 512→1,408→512가 선택된 expert 내부다. SwiGLU처럼 내부에 게이트를 사용하는 경우 실제 행렬 수는 더 많다. 그래서 이 차원 예제는 계산 순서를 설명하는 것이며 정확한 전체 FLOPs 공식은 아니다.
6. Efficient·Accurate LatentMoE: active expert와 비용 차이
효율형 ℓ-MoEeff는 expert 하나의 입력·출력 폭을 줄이고 token당 실행하는 expert 수를 유지한다.
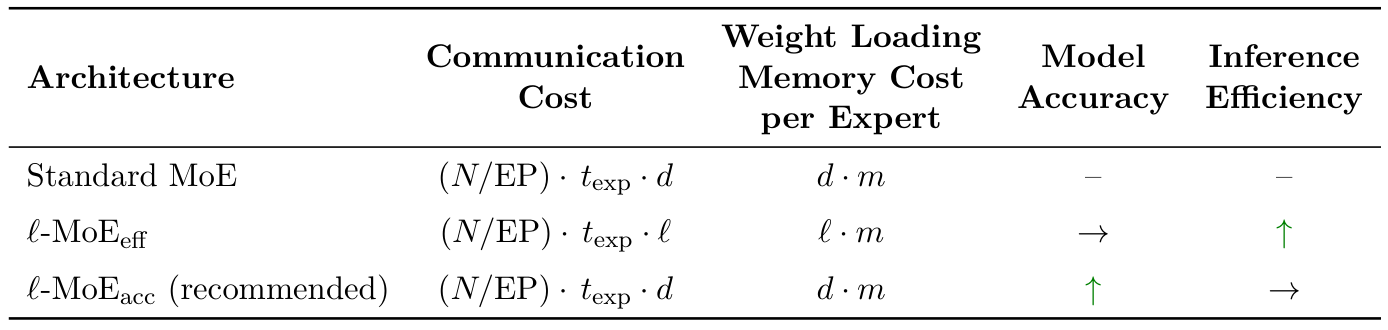
따라서 같은 token의 선택 expert 경로에서 읽고 계산해야 할 weight가 줄어든다. 다만 전체 expert 수는 4배로 늘렸으므로 전체 저장 weight가 4분의 1이 되는 모델은 아니다. 실제 표 3에서도 효율형의 전체 parameter는 94.8B로 기준 94.4B와 거의 같다.
정확도형 ℓ-MoEacc는 작아진 expert를 더 많이 실행한다. expert 경로의 계산·통신 규모를 대체로 유지하면서 더 다양한 expert 조합을 사용할 수 있게 한다. 늘어난 router, latent projection, 항상 실행하는 부분까지 포함하면 정확히 같은 비용은 아니다. 논문이 사용하는 “같은 비용”은 주요 경로의 대략적인 규모와 실제 측정에서의 근접성을 함께 보아야 한다.
표 1의 헤더는 Weight Loading Memory Cost per Expert라고 적고 정확도형 행을 d·m으로 표시한다. 이 값은 물리적인 expert 하나의 행렬이 다시 d·m 크기가 됐다는 뜻으로 읽으면 식 2와 맞지 않는다. 정확도형의 개별 expert 폭도 ℓ이며, 더 많은 expert를 실행했을 때의 동등한 활성 비용 규모가 d·m에 대응한다. 표의 요약 표기와 실제 행렬 모양을 나눠 읽어야 한다.
또한 N이 늘어도 token당 통신량은 반드시 늘지 않는다. 균등 routing을 가정하면 expert당 token 수는 전체 token 수×K/N이고, GPU당 expert 수 N/EP와 곱할 때 N이 상쇄된다. EP는 expert를 나누어 배치한 GPU 수다. 그러나 이 상쇄가 router 연산, 모든 expert의 메모리 배치, 작은 행렬의 실행 효율까지 비용 0으로 만든다는 뜻은 아니다.
7. Latent dimension ablation: expert hidden size와의 차이
7.1 Expert intermediate size를 유지하는 이유
expert 하나가 입력을 1,408개 중간 값으로 넓힌 뒤 비선형 함수를 적용한다고 생각해 보자. 이런 expert 6개를 켜면 token은 여러 비선형 변환을 거친다. 논문은 그 대략적인 양을 K·m에 비례하는 유효 비선형 예산으로 본다. K나 m을 줄이면 이 예산도 줄어 정확도가 나빠질 수 있다는 논리다.
저자들은 한 은닉층 신경망에 대한 Barron 근사 이론을 이 직관의 근거로 연결한다. 다만 해당 함수·근사 조건에서의 오차 경계가 현대 언어 모델 전체의 정확도를 보장하는 정리는 아니다. 입력 폭을 줄여도 정확도가 유지될 것이라는 설계 가설과, 실제 학습에서 확인할 결과를 구분해야 한다.
7.2 Latent compression의 task별 한계
서로 구별해야 하는 정보가 많은데 숫자 몇 개만 남기면 중요한 차이가 사라진다. 논문은 과제에 필요한 최소 표현 자유도를 유효 특징 순위 라고 부른다. latent width ℓ가 이보다 작아지면 정확도가 나빠진다는 원칙이다. 이는 가능한 압축비가 무한하지 않다는 경고로 읽는 편이 정확하다.
이 논문은 를 직접 측정하는 algorithm이나 모든 과제의 순위를 주지 않는다. 뒤의 압축비 4·8 비교로 특정 학습 설정에서 4배 압축이 잘 작동함을 보일 뿐이다. “512차원이 모든 언어 과제의 본질적 차원”이라는 결론은 나오지 않는다.
7.3 Expert 수와 routing 조합
작은 예를 들면 4개 중 2개를 고르는 조합은 6개지만, 8개 중 4개를 고르는 조합은 70개다. N과 K를 함께 늘리면 선택 조합의 수가 크게 늘어난다. 논문은 이를 조합적 희소성으로 설명한다. 여러 token이 서로 다른 expert 조합을 사용해 표현을 나눌 여지가 커진다는 뜻이다.
그러나 조합이 많다는 계산만으로 실제 router가 그 조합을 고르게 쓰거나 각 expert가 의미 있는 전문성을 학습한다는 것이 증명되지는 않는다. 균형을 잡는 학습 방법과 실제 정확도 검증이 필요하다. 압축, expert 증가, 활성 expert 증가의 역할을 나눠 보는 다음 제거·변경 실험이 그래서 중요하다.
8. LatentMoE 학습 설정과 benchmark
8.1 세 model family의 architecture·size 조건
16BT-2BA는 전체 약 16B, 활성 약 2B를 뜻한다.
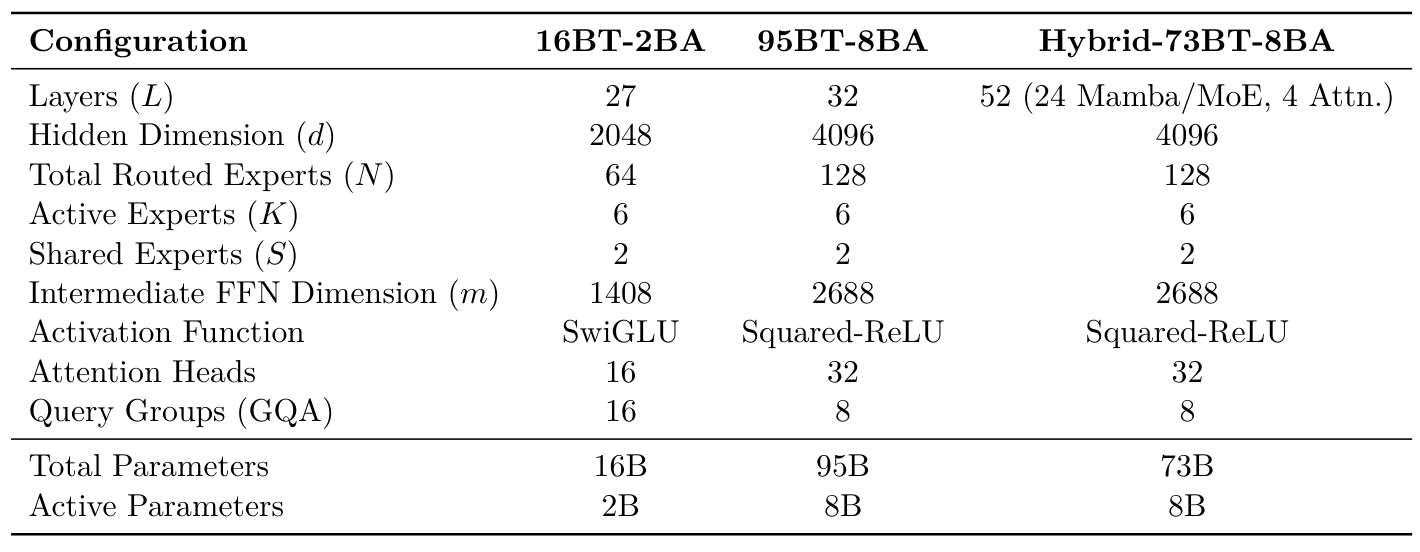
이 작은 모델은 27층, 폭 2,048, expert 64개 중 6개 활성, 공유 expert 2개, 중간 폭 1,408, SwiGLU activation을 사용한다. attention head와 query group은 각각 16개다. 논문은 DeepSeek-v2-lite의 구조와 hyperparameter를 바탕으로 작은 모델의 변경 실험을 했다고 설명한다.
95BT-8BA는 32층, 폭 4,096, expert 128개 중 6개 활성, 공유 expert 2개, 중간 폭 2,688이다. activation function는 Squared-ReLU이며 attention head 32개, query group 8개다. GQA는 여러 query가 key·value 쪽을 공유하는 grouped-query attention 구조다. 여기서는 작은 모델의 SwiGLU와 큰 모델의 Squared-ReLU도 다르므로 크기만 키운 한 변수 실험이라고 부르면 안 된다.
Hybrid-73BT-8BA는 attention 외에 이전 상태를 갱신하며 sequence를 처리하는 Mamba-2 블록을 섞는다. 표는 총 52층을 24 Mamba/MoE와 4 attention으로 표시한다. Mamba와 MoE를 각각 세는 구성으로 읽으면 24쌍과 attention 4개에 해당한다. 기본 d·N·K·S·m과 attention head·query group 값은 큰 Transformer와 같다. Mamba-2 쪽 설정은 head 128개, head dimension 64, state dimension 128, group 8이다. 이 숫자를 attention head 32개와 혼동하면 안 된다.
8.2 Learning rate schedule과 token budget
큰 Transformer는 learning rate를 최대 1.2×10⁻³에서 최소 3×10⁻⁶으로 내리는 cosine 일정을 사용한다. hybrid는 일정 기간 learning rate를 유지하고 마지막 구간에 낮추는 WSD 일정을 사용하며 최대 8×10⁻⁴, 마지막 15%에서 8×10⁻⁶까지 감소시킨다. 모델군이 다르면 이 일정도 다르다.
두 활성 8B 모델군 모두 sequence 길이 8,192, batch 768, learning rate 준비 구간 8.4B token을 사용한다. 768×8,192는 한 batch 약 629만 token이다. 논문은 약 600만으로 표현한다. expert별 token 쏠림을 막기 위해 10⁻⁴ 계수의 균형 loss와 DeepSeek의 aux-loss-free 전략을 함께 썼다고 적는다. 이름에 loss-free가 있다고 이 설정의 모든 보조 loss가 0인 것은 아니다.
작은 모델의 그림은 약 1T token까지, 큰 Transformer의 표 3은 300B token 시점, hybrid 표 4는 1T token 시점이다. 원문 전체를 “모든 95B 모델을 1T 학습한 비교”로 요약하면 틀린다. 학습 데이터 혼합 비율·tokenizer·전체 optimizer 설정·무작위 seed·반복 실험 횟수는 이 18쪽 자료만으로 완전하게 복원할 수 없다.
8.3 지식·reasoning·코드·수학 benchmark의 차이
MMLU와 MMLU Pro는 여러 분야의 지식·reasoning을 묻는 객관식 평가다. Pro는 별도 평가 구성으로, 같은 척도의 쉬운/어려운 한 행이라고 단순 합산할 수 없다. 이 글에서는 원문 표에 제시된 각 점수와 그 차이를 그대로 비교한다.
Code는 HumanEval, HumanEval+, MBPP, MBPP+의 평균이다. 설명에 맞는 프로그램을 생성하고 테스트를 통과하는지를 보는 과제들을 묶은 값이다. Math는 GSM8K CoT와 MATH-500의 평균이다. CoT는 중간 풀이 과정을 활용하는 평가 조건을 뜻한다. Commonsense는 RACE, ARC-Challenge, HellaSwag, Winogrande 평균으로, 독해·reasoning·문맥에 맞는 선택 등을 묶는다.
따라서 Code 평균이 올랐다고 네 개 구성 평가가 모두 올랐다고 단정할 수 없고, Math 평균 하나로 초등 산술과 어려운 수학 문제의 변화를 분리할 수도 없다. 원문은 이 표에서 구성 평가별 행, 평가 prompt·샷 수 전체, 반복 분산을 제공하지 않는다. 아래에서는 보고된 평균 단위에서의 개선이라고 표현한다.
9. Small-model ablation: 압축률·expert 수·top-k 비교
9.1 Latent compression 4배·8배 비교
첫 비교는 얼마나 압축할 수 있는지 묻는다. 16B 기본 모델 위에서 효율형 구성을 사용하며 압축비를 바꾼다. 4배 압축은 폭 512, 8배 압축은 폭 256에 대응한다. 이때 전체 expert 수도 압축비에 따라 함께 늘리고, 그 외 기본 학습 설정은 유지한다. 따라서 단순히 입력 차원 하나만 줄이는 실험은 아니다.
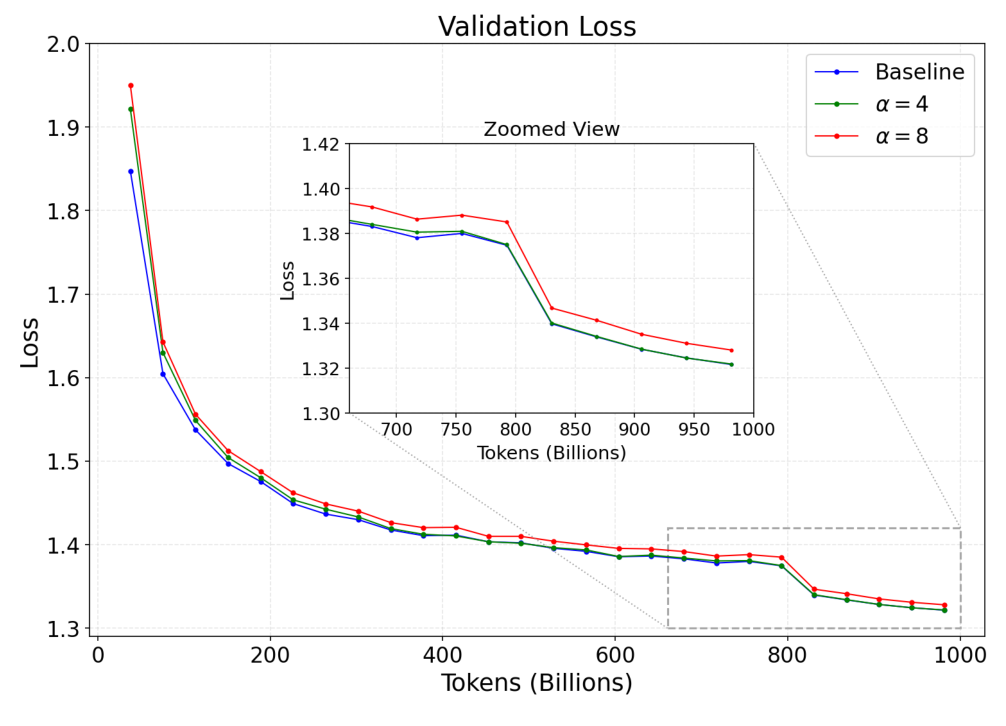
검증 loss는 학습에 사용한 목적을 별도의 검증 데이터에서 계산한 값이다. 같은 프로토콜 안에서는 낮을수록 다음 token 예측이 잘 맞는 방향이지만, loss 0.01 차이가 특정 업무 정확도 몇 %로 직결되는 것은 아니다. 그림에서 4배 압축은 기준 곡선과 거의 겹치고, 8배 압축은 그보다 위에 남는다.
이 결과가 지지하는 결론은 이 설정에서 4배 압축을 선택할 근거가 있다는 것이다. 8배에서는 더 많은 expert를 두더라도 줄어든 입력 정보나 학습 조건의 영향을 완전히 보상하지 못한 것으로 볼 수 있다. 이것은 편집팀의 해석이며 두 원인을 따로 분리한 실험은 없다. 논문 문장은 α≤4에서 품질이 유지된다고 설명하지만, 제시된 그림의 범례는 기준·4·8이다. 모든 중간 압축비를 독립적으로 검증한 전체 실험표가 제공된 것은 아니다.
9.2 Total expert 수 ablation
다음은 4배 압축을 고정하고 expert 수를 비교한다. 한쪽은 원래처럼 64개만 두고, 다른 쪽은 제안대로 256개를 둔다. token당 고르는 수는 효율형의 6개이며 중간 폭과 기본 hyperparameter도 유지한다. 이 비교는 “압축만 하면 되는가, 선택 가능한 expert를 늘리는 보완이 필요한가”를 직접 묻는다.
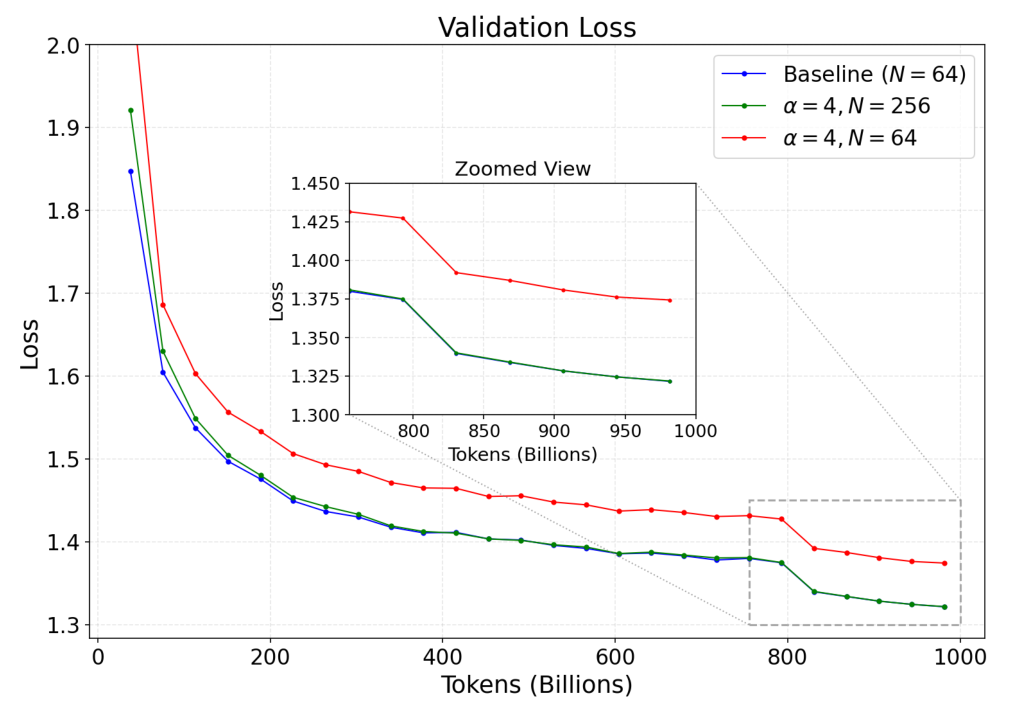
전체 곡선에서 같은 압축률이라도 expert 수에 따라 loss가 달라지는 점을 먼저 보자. 아래 확대도에서는 학습 후반의 간격을 더 자세히 확인한다.
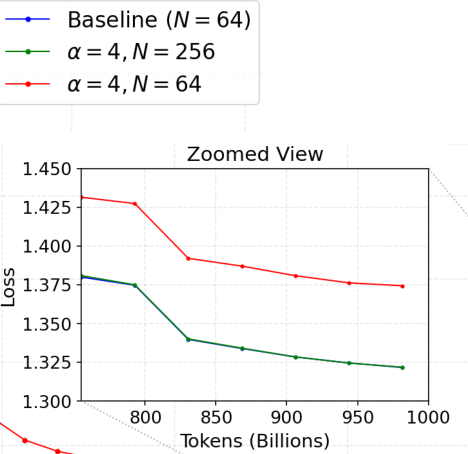
이 조건에서는 전체 expert 수 증가가 압축에 따른 성능 저하를 보완한다. 다만 전체 parameter도 함께 변하므로 “같은 전체 크기에서 router 선택지만 늘린 효과”라고 부를 수 없다. 64개로 압축한 모델은 저장 parameter 자체가 줄고, 256개 모델은 이를 다시 늘린다. 원문은 별도 광범위한 hyperparameter 탐색을 피하는 설계로 제안한다. 그림의 높은 loss만으로 gradient 발산이나 학습 실패가 직접 관찰됐다고 표현해서도 안 된다.
9.3 Active expert 수 ablation
세 번째 비교는 폭 512, 전체 expert 256개인 상태에서 활성 수를 6개와 24개로 바꾸는 것이다. 전자가 효율형, 후자가 정확도형이다. 이 비교에서는 정확도형이 효율형보다 expert 계산을 더 한다. 정확도형의 비용이 비슷하다는 기준은 압축 전 기본 모델이며, 효율형과 같은 비용이라는 뜻은 아니다.
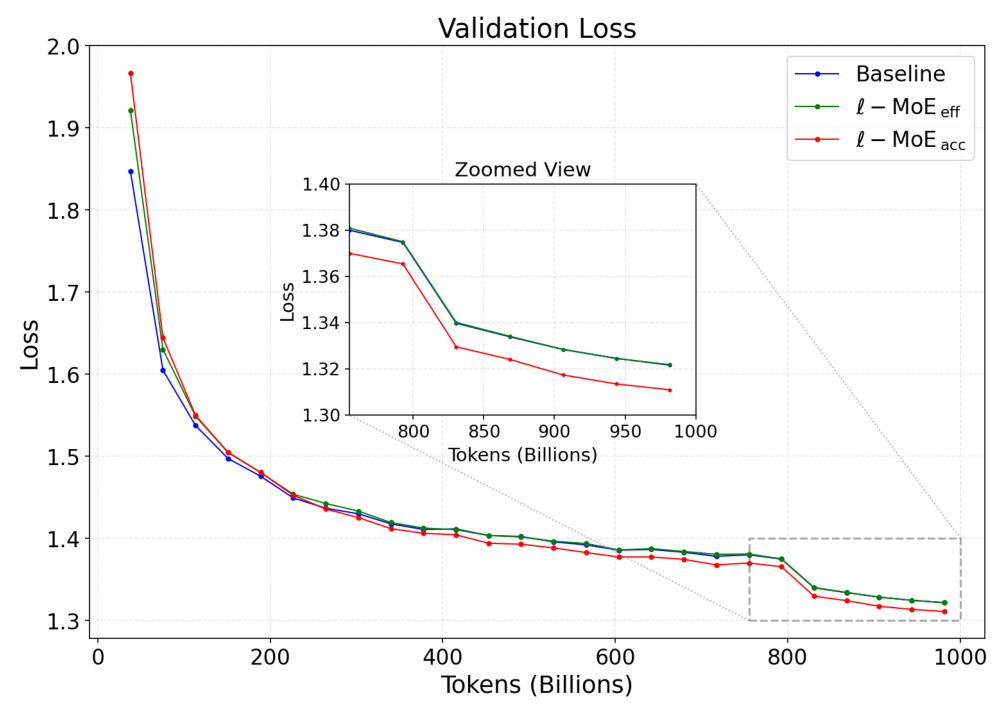
이 비교에서는 Acc 설정의 loss가 더 낮게 나타난다. 아래 확대도는 후반 구간의 차이를 보여 주며, 속도 비교 결과를 대신하는 그림은 아니다.
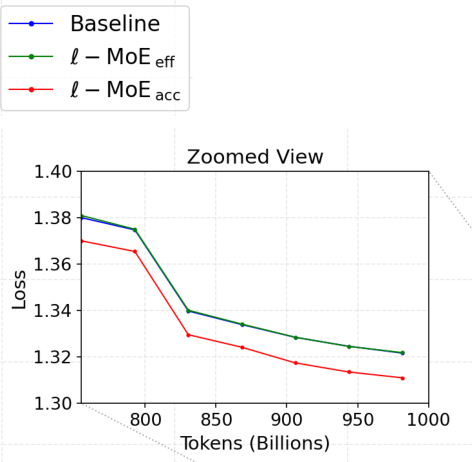
이 결과는 압축으로 아낀 expert 경로 비용을 다시 써서 검증 loss를 낮출 수 있다는 주장을 지지한다. 각 곡선의 같은 학습 token 시점을 비교해야 하며, 초기 몇 점의 높낮이만 보고 최종 모델을 평가하면 안 된다. 여기에도 반복 seed나 오차막대가 없으므로 작은 차이의 통계적 확실성까지 확인한 것은 아니다.
10. 95B Transformer benchmark: 지식·reasoning·코드·수학
10.1 95B model의 training loss curve
큰 Transformer는 기본 폭 4,096을 1,024로 줄이고, 전체 expert 128개를 512개로 늘린다. 효율형은 활성 6개, 정확도형은 활성 24개다. 원문은 기본 모델에 맞춘 hyperparameter를 그대로 사용했다고 설명한다. 그림 6의 가로축은 300B token까지이며, 앞의 작은 모델 1T token 그래프와 범위가 다르다.
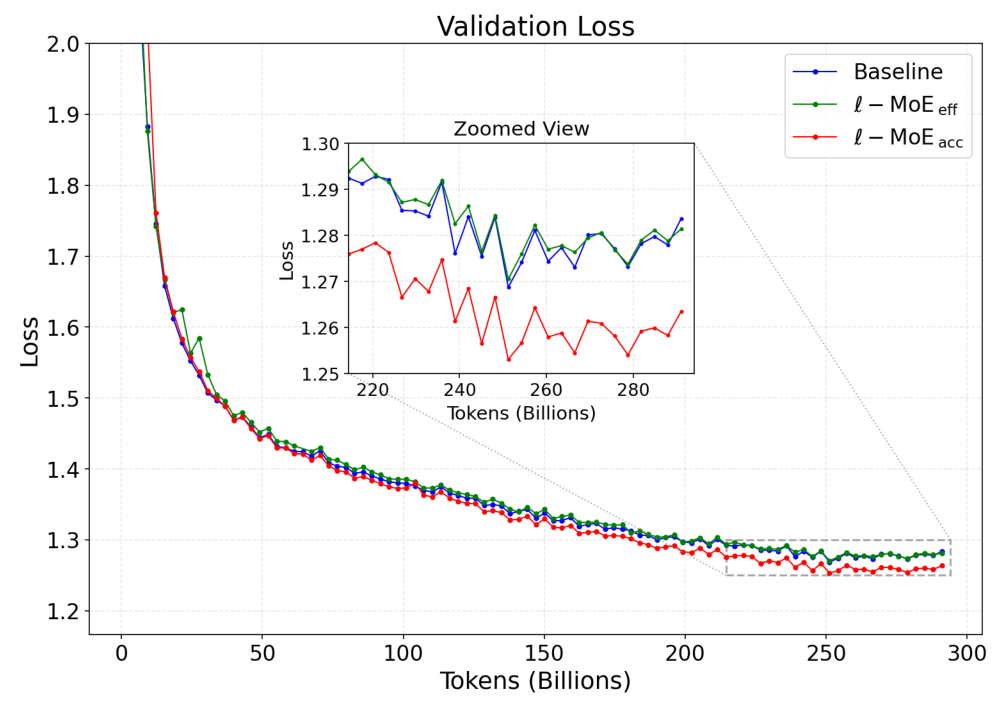
95B 모델의 비교도 같은 token 예산 안에서 읽어야 한다. 아래 확대도는 300B token 실험의 후반을 보여 주며, 이후 1T token 결과와 섞지 않는다.
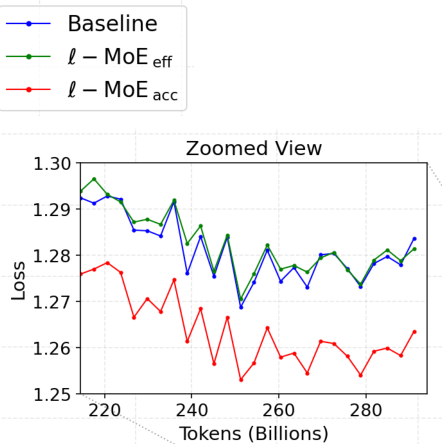
작은 모델에서 본 방향이 큰 모델에서도 이어진다는 근거다. 그림의 확대 구간이 출렁이는 것은 각 평가 시점의 값이 일정하지 않다는 뜻이지, 그 자체가 통계적 오차 범위를 제공한다는 뜻은 아니다. 구체적인 downstream 성능은 다음 표에서 별도로 확인한다.
10.2 Total parameter와 active parameter 비교
기준 모델은 활성 8.47B·전체 94.4B다.
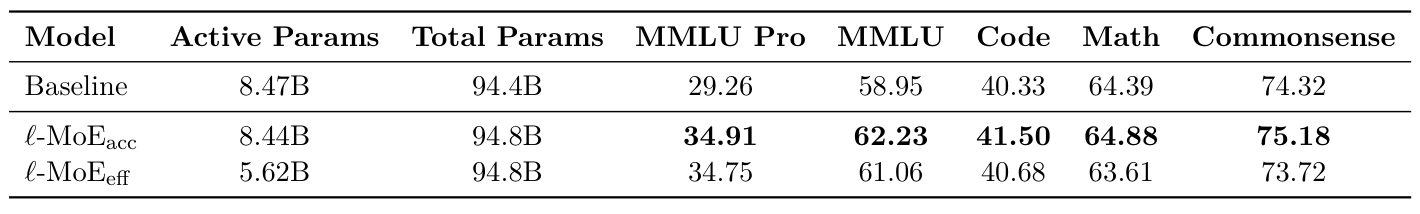
정확도형은 활성 8.44B·전체 94.8B, 효율형은 활성 5.62B·전체 94.8B다. “95B”는 반올림한 모델군 이름이며 정확한 표 값은 이와 같다. 정확도형은 전체·활성 규모가 거의 같은 비교이고, 효율형은 전체 크기를 유지하면서 활성 크기를 약 33.65% 줄인 비교다.
33.65%는 (8.47−5.62)/8.47을 계산한 값이다. 이는 전체 응답시간이 33.65% 줄었다는 뜻이 아니다. 투영, attention, 공유 expert, 통신, 실제 커널 이용률이 남는다. 활성 parameter 감소와 실측 throughput을 분리해 두어야 뒤의 표 5를 모순 없이 읽을 수 있다.
10.3 지식·reasoning·코드 benchmark 개선
MMLU Pro는 기준 29.26, 정확도형 34.91, 효율형 34.75다.
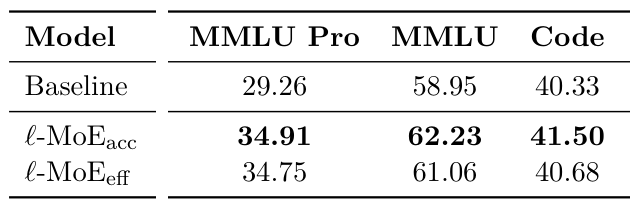
정확도형의 개선은 5.65포인트다. MMLU는 58.95에서 정확도형 62.23으로 3.28포인트 오르고, 효율형도 61.06을 기록한다. 이 표에서는 정확도형이 효율형보다 약간 높지만, 두 변형 모두 기준보다 높은 지식·reasoning 점수를 보인다.
Code 평균은 기준 40.33, 정확도형 41.50, 효율형 40.68이다. 정확도형의 개선은 1.17포인트로 MMLU Pro보다 작다. 이를 보고 latent compression이 모든 능력을 같은 비율로 개선한다고 말할 수 없다. 어느 입력 표현과 expert 분화가 어떤 과제에 더 도움이 됐는지에 대한 내부 분석은 이 결과표만으로 분리되지 않는다.
10.4 Efficient 변형의 수학·상식 benchmark 하락
Math는 기준 64.39에서 정확도형 64.88로 0.49포인트 오른다.
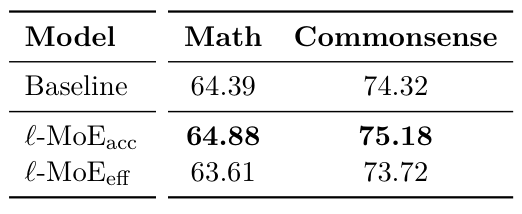
그러나 효율형은 63.61로 0.78포인트 낮다. Commonsense도 정확도형은 74.32에서 75.18로 0.86포인트 오르지만, 효율형은 73.72로 0.60포인트 낮다.
따라서 정확도형은 이 다섯 보고 열에서 일관되게 개선됐다고 말할 수 있다. 효율형은 세 열에서 개선되고 두 열에서 하락한 채 활성 크기를 줄였다고 설명해야 한다. 원문 캡션의 “comparable to or better”를 모든 능력이 보존됐다는 보장으로 바꾸면 독자의 선택에 중요한 약점을 지우게 된다.
11. Mamba·attention hybrid benchmark 결과
11.1 1T token으로 학습한 hybrid model 비교
기준 hybrid는 활성 8.09B·전체 72.6B다.
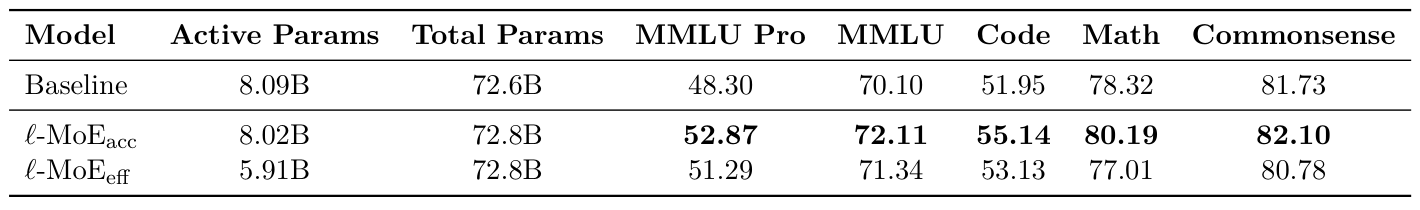
정확도형은 8.02B·72.8B, 효율형은 5.91B·72.8B다. 효율형의 활성 감소는 약 26.95%다. Transformer에서 약 33.65%였던 것과 비율이 다른 이유를 생각할 때는, 압축하지 않는 모델 부분이 전체에서 차지하는 몫과 구조가 다르다는 점을 고려해야 한다. 정확한 비용 분해 측정은 표에 없다.
이 표의 높은 점수를 앞선 Transformer와 바로 비교해 “Mamba를 넣어서 그만큼 올랐다”고 해석하면 안 된다. 전체 크기·층 구성·learning rate 일정·학습 token 예산이 함께 다르다. 논문이 직접 통제한 비교는 각 모델군 안에서의 기준·효율형·정확도형이다.
11.2 Hybrid의 지식·코드 benchmark 변화
MMLU Pro는 기준 48.30에서 정확도형 52.87로 4.57포인트 오른다.
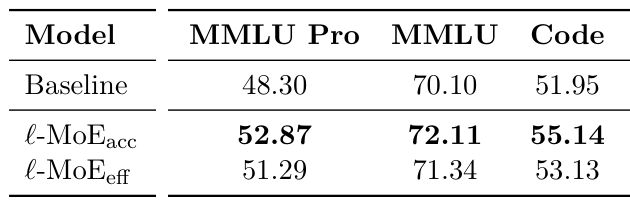
효율형도 51.29로 2.99포인트 높다. MMLU는 70.10에서 정확도형 72.11로 2.01포인트, 효율형 71.34로 1.24포인트 오른다.
Code는 기준 51.95, 정확도형 55.14, 효율형 53.13이다. 정확도형의 코드 평균 개선은 3.19포인트다. 앞의 Transformer 비교보다 코드 변화가 더 크게 나타나지만, 학습 예산과 구조가 달라 어느 요소가 그 차이를 만들었는지 이 두 표만으로 결정할 수 없다. 그럼에도 다른 모델군에서도 latent expert 경로가 유효하다는 확장 근거는 된다.
11.3 Efficient hybrid의 약한 결과
Math는 기준 78.32에서 정확도형 80.19로 1.87포인트 오르는 반면 효율형은 77.01로 1.31포인트 낮다.
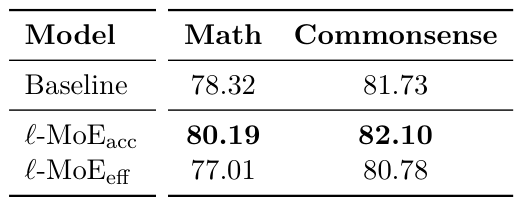
Commonsense는 기준 81.73, 정확도형 82.10, 효율형 80.78이다. 정확도형의 이득은 0.37포인트로 작고 효율형은 0.95포인트 낮다.
두 모델군에서 효율형의 수학·상식 평균이 모두 떨어졌다는 점은 실무 선택에 의미가 있다. 활성 계산을 줄이는 선택이 과제에 따라 값을 치를 수 있다는 반복된 관찰이다. 다만 원문은 구성 dataset별 원인 분석과 통계적 검정을 제공하지 않으므로 “수학 reasoning은 압축에 본질적으로 취약하다”라는 일반 법칙까지 도출할 수는 없다.
12. 실측 throughput: 73B hybrid의 GPU·batch 조건
12.1 73B hybrid에서 concurrency에 따라 달라지는 실측 throughput
이제 정확도에서 실제 실행으로 넘어간다. 원문은 Hybrid-73BT-8BA를 Hopper H100 두 개에서 vLLM으로 실행하고 FP8 per-tensor quantization을 사용했다고 설명한다. per-tensor는 tensor 단위로 quantization 스케일을 잡는 조건이다. 앞서 설명용 roofline에서 가정한 GB200·FP4 시스템과는 다른 설정이다.
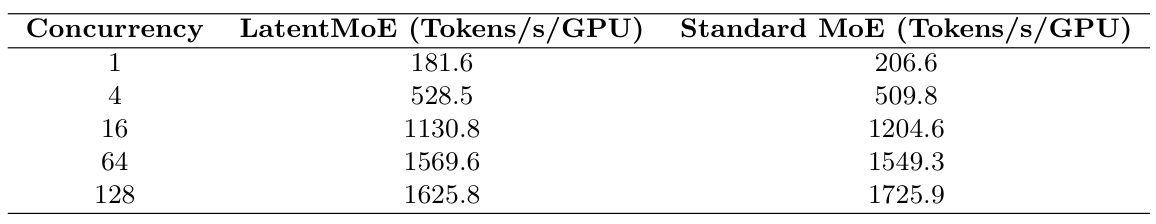
동시 요청 1개에서 LatentMoE는 181.6, 기준은 206.6 tokens/s/GPU다. 기준 대비 약 12.10% 낮다. 4개에서는 528.5 대 509.8로 약 3.67% 높다. 16개에서는 1,130.8 대 1,204.6으로 약 6.13% 낮고, 64개에서는 1,569.6 대 1,549.3으로 약 1.31% 높다. 128개에서는 1,625.8 대 1,725.9로 약 5.80% 낮다.
이 비율은 각 행에서 (LatentMoE/기준−1)×100으로 계산했다. 숫자 하나로 정리하면 중요한 방향이 사라진다. 정확도를 높인 모델이 여러 동시성에서 비슷한 수준의 throughput을 유지하지만, 전 구간 속도 향상을 보이지는 않는다. 특히 동시 요청 1개를 중시하는 용도라면 약 12%의 throughput 하락을 그냥 넘길 수 없다.
원문은 높은 동시성에서 최대 약 6% 하락이라고 서술한다. 표의 16개 행을 그대로 계산하면 약 6.13%이므로 반올림된 설명으로 읽을 수 있다. 그러나 이 문장을 전체 동시성에 적용하면 1개 행의 하락을 빠뜨린다. 또한 §4.3.1 도입은 앞선 측정을 95B 규모라고 부르지만, 실제 측정 설명과 표의 대상은 73B hybrid다. 이 글에서는 구체적으로 명시된 실측 대상을 따른다.
12.2 같은 active size에서 throughput이 달라지는 이유
작은 행렬은 GPU의 계산 장치를 충분히 채우지 못할 수 있다. 원문도 expert의 행렬을 줄인 뒤에는 작은 행렬에 맞는 GEMM 커널을 쓰는 최적화가 필요하다고 지적한다. GEMM은 일반적인 행렬 곱 연산이다. 같은 연산 수라도 행렬 모양과 작업을 GPU에 나누는 방법에 따라 걸리는 시간이 달라진다.
저자들은 선택 expert와 공유 expert를 별도 CUDA stream에서 겹쳐 실행하는 방안도 제안한다. stream은 GPU에 작업 순서를 제출하는 실행 흐름이다. 이 제안이 표 5에서 이미 모두 구현돼 효과를 검증했다는 뜻은 아니다. 원문은 추가 최적화 가능성으로 적는다.
표 5에는 입력·출력 길이, 반복 횟수와 오차, 정확한 vLLM 버전·커널 설정, GPU 메모리 세부형, 시간 분해가 없다. 첫 token 지연과 사용자별 token 간 지연도 따로 보고하지 않는다. 따라서 이 throughput 표를 모든 서비스의 사용자 체감 속도나 재현 가능한 명령 하나로 바꿀 수는 없다.
13. Trillion-parameter 비교: model size와 iso-accuracy
13.1 Iso-size와 iso-accuracy 비교의 차이
한 모델이 같은 크기에서 더 정확하다면, 기존 구조를 더 크게 만들어 정확도를 맞춘 뒤 속도를 비교할 수 있다. 예를 들어 새 구조 1조 모델의 점수에 도달하려면 기존 구조가 1.35조 필요하다고 가정하는 것이다. 그러면 새 구조는 더 큰 비교 모델보다 빨라 보일 가능성이 크다. 그 비교가 타당한지는 1.35조라는 정확도 대응을 얼마나 잘 입증했는가에 달려 있다.
논문은 이를 Effective Parameter Multiplier(EPM), 즉 유효 parameter 배수로 표현한다. 먼저 기준 모델 크기 N과 점수의 관계를 f(N)으로 맞춘다. 새 구조의 점수 S를 기준 곡선에서 역으로 찾으면 그 점수를 내는 기준 모델 크기 를 얻는다. 물리적으로 가진 parameter 보다 가 크다면 같은 크기로 더 높은 점수를 낸 셈이다.
λ가 EPM이며, 는 정확도를 맞추기 위해 구성할 기준 모델 크기다. 이 식은 원문 식 3·4의 의미와 그다음 정의를 묶었다. 역함수는 점수에서 필요한 크기를 되찾는 계산이라는 뜻이다. 점수가 실제로 그 크기 함수만으로 결정된다는 가정이 맞지 않으면 대응도 달라진다.
13.2 Qwen dense scaling curve를 Kimi MoE에 적용하는 조건
원문은 Qwen-3-Dense의 0.6B·1.7B·4B·8B·14B·32B 모델 MMLU 정확도에 라는 로그 선형식을 맞춘다고 설명한다. a는 모델을 로그 규모로 키울 때 점수가 얼마나 변하는지, b는 기준 높이를 정하는 계수다. 그 뒤 Kimi-K2-1T-LatentMoE에 대해 λ≈1.35를 추정했다고 보고한다.
1T×1.35=1.35T이므로 약 350B를 더한 기본 구조가 대응한다는 계산이다. 실제 비교용 구조는 Kimi-K2의 층 수를 61에서 80으로 늘려 구성한다. 61→80의 층 수 비율은 약 1.31이며, 논문이 보고한 parameter 목표 약 1.35와 수학적으로 같은 비율은 아니다. 층 수만의 비율로 정확한 총parameter를 다시 단정해서는 안 된다.
여기에는 큰 가정이 들어 있다. dense model군에서 맞춘 MMLU의 크기 관계를 매우 큰 MoE 구조의 정확도 대응으로 옮긴다. 이 논문은 맞춘 a·b, 각 원점수와 잔차, λ의 불확실성, 실제 1.35T 모델을 학습해 정확도가 일치했음을 보이는 별도 표를 제공하지 않는다. 따라서 “동일 정확도를 실측으로 맞춘 1.35T 모델”보다 스케일링 가정으로 정확도를 맞춘 비교 구조라고 부르는 것이 정확하다.
14. Inference simulation: prefill·decode와 최대 3.46배의 조건
14.1 Decode-heavy workload의 simulation
논문은 20만 개가 넘는 운영점을 비공개 시뮬레이터로 평가해 throughput과 사용자 속도의 경계를 그렸다고 설명한다.
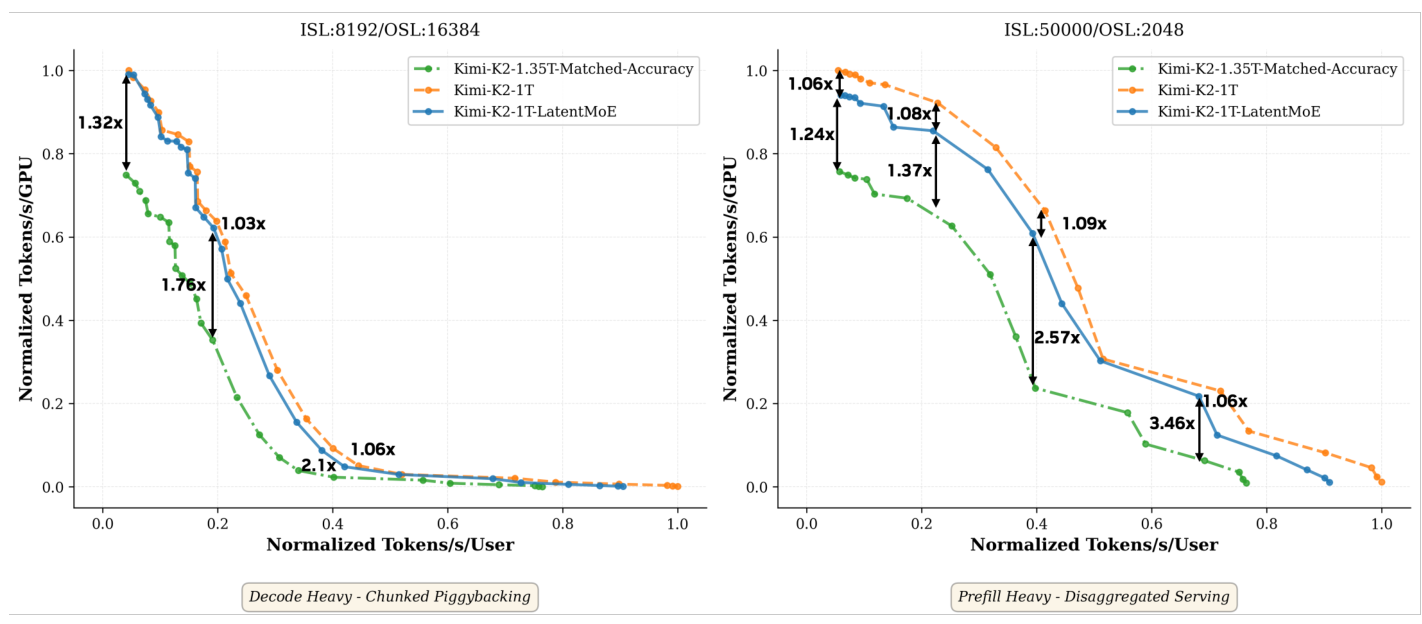
여기서 운영점은 실행·batch·병렬 구성 등의 선택으로 얻는 성능 조합을 뜻한다. 제공된 자료에는 그 전체 구성과 시뮬레이터 보정 오차가 공개돼 있지 않다.
가로축은 normalized tokens/s/user, 세로축은 normalized tokens/s/GPU다. 오른쪽으로 갈수록 한 사용자가 token을 받는 속도가 높고, 위로 갈수록 GPU 하나가 전체적으로 처리하는 token 수가 많다. 둘을 동시에 끝없이 높일 수 없으므로 어느 쪽을 더 중시하는지에 따른 경계를 그린다. 이런 비교에서 다른 선택보다 두 축 모두 나쁘지 않은 경계를 Pareto frontier라고 한다. 절대 초 단위 지연이 가로축에 표시된 것은 아니다.
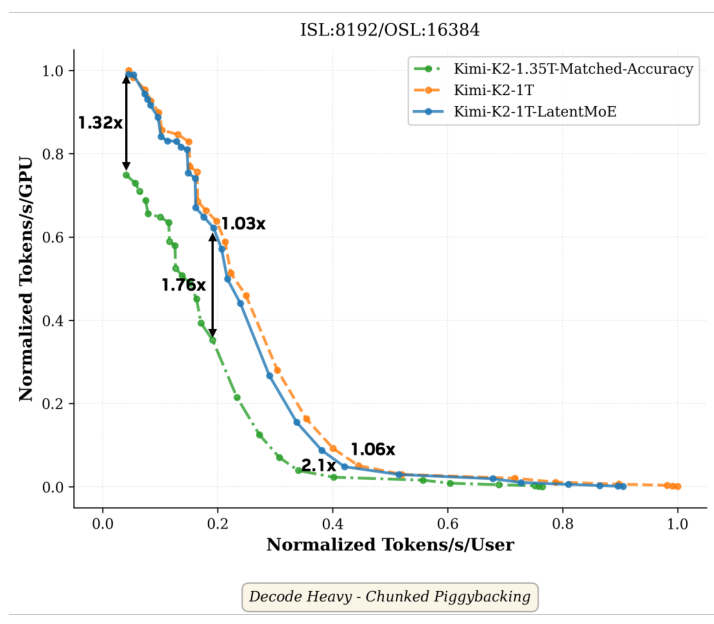
왼쪽은 입력을 읽는 시간보다 긴 답을 만들어 내는 decode 비중이 큰 설정이다. 원문은 입력 길이 ISL 8,192, 출력 길이 OSL 16,384를 표시한다. 입력 처리 조각을 생성 작업과 함께 배치하는 chunked piggybacking 방식을 모델링했다. 특정 사용자 속도를 유지할 때 LatentMoE의 GPU당 throughput이 크게 만든 1.35T 구조보다 높은 구간을 보여 준다.
그러나 원래 1T 모델인 주황은 파랑과 매우 가깝거나 더 높다. 이 그림의 큰 이득은 “원래 Kimi-K2 1T보다 모든 조건에서 훨씬 빠르다”는 결과가 아니다. 정확도 이득을 기존 구조의 크기 증가로 대신 얻으려 하면 더 비쌀 수 있다는 시뮬레이션 논리다. 두 비교선을 바꾸면 결론이 달라진다.
14.2 Prefill-heavy workload의 최대 3.46배 simulation
오른쪽은 긴 문서를 읽고 비교적 짧게 답하는 prefill 중심 조건이다.
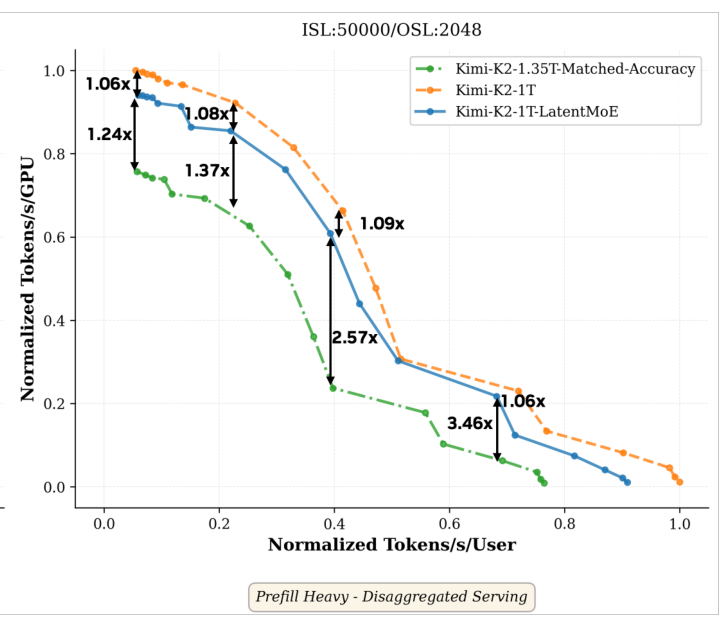
입력 길이는 50,000, 출력 길이는 2,048이며 입력 처리와 생성 처리를 나누는 disaggregated serving을 모델링했다. 원문이 예측한 파랑 대 초록의 비율은 표시된 운영점에 따라 1.24·1.37·2.57·3.46배다.
화살표가 세로라는 점이 중요하다. 같은 가로 위치, 즉 같은 normalization 사용자 token 속도에서 GPU당 throughput의 차이를 표시한다. 어떤 사용자의 요청 완료 시간이 직접 측정으로 3.46배 짧아졌다는 뜻은 아니다. normalization 축이므로 이 그림만으로 초당 실제 몇 token을 처리하는지도 복원할 수 없다.
주황 원래 1T와 파랑 LatentMoE 사이에는 1.06·1.08·1.09·1.06배처럼 가까운 차이가 표시된다. 원문은 latent projection으로 생기는 추가 비용이 원래 모델 대비 최대 약 9% 범위에서 가깝다고 설명한다. 이것도 이 예측 조건의 결과이지 latent projection의 보편적인 FLOPs 증가율이나 모든 환경의 지연 상한은 아니다.
최대 3.46배를 인용하려면 따라서 네 가지가 함께 따라와야 한다. 비공개 시뮬레이션이라는 근거 종류, 정확도 대응을 추정해 더 크게 만든 1.35T 비교 대상, 긴 입력 조건, 그리고 특정 throughput 경계에서의 최대값이다. 이 조건을 지우고 일반 속도 향상 숫자만 남기면 논문이 제공한 증거보다 강한 주장이 된다.
15. Megatron-Core LatentMoE 코드: projection·router·config
15.1 MoE projection과 expert 입출력 경로
검토한 코드는 NVIDIA Megatron-LM의 core_v0.17.0, commit 9539a12e1b04a68423f57b3eb41d6125161dca24다. commit 시점은 2026년 4월 14일로 논문 공개 뒤다. 논문 당시 실행 코드를 그대로 공개한 태그라고 가정하지 않고 후속 공식 구현의 동작을 확인하는 데 사용했다.
moe_layer.py의 정상 forward 경로는 원래 입력으로 공유 expert와 router를 먼저 호출한다. 이어 preprocess()에서 fc1_latent_proj로 폭을 줄이고 dispatch에 보낸다. expert 계산과 combine 뒤 postprocess()에서 fc2_latent_proj로 폭을 복원하고 공유 expert 출력을 더한다. 논문의 데이터 이동 순서와 맞는다.
experts.py의 선택 expert 입력·출력 차원도 moe_latent_size를 사용한다. 반면 공유 expert는 원래 hidden_size를 유지한다. router의 weight도 전체 expert 수×원래 hidden 크기다. 이 차이를 실제 shape에서 확인했으므로 “압축한 token으로 routing한다”는 흔한 잘못된 구현 설명을 피할 수 있다.
투영 두 개의 parameter는 bias를 빼면 합계 2dℓ다. 입력 token 수를 T라 하면 곱셈·덧셈을 2 FLOPs로 세는 관례에서 두 투영은 약 4Tdℓ 연산을 추가한다. 이것은 코드의 행렬 모양에서 계산한 설명용 값이며 논문의 실제 실행시간 측정값은 아니다. expert 비용을 비교할 때 이 항을 빠뜨리지 않는 데 의미가 있다.
15.2 Latent size·expert 수·top-k config의 관계
TransformerConfig의 moe_latent_size는 기본 None이며, 값이 있으면 latent projection 크기를 정한다. 이 dataclass 필드에서 --moe-latent-size CLI 옵션이 생성되고, 인자는 MCore 설정으로 전달된다. 단순히 이름만 있는 비활성 옵션은 아니다.
그러나 이 값이 전체 expert 수 N이나 top-k K를 자동으로 곱해 주지는 않는다. 예를 들어 앞의 작은 모델에 맞춘 구조를 만들려면 hidden size 2,048과 latent size 512 외에도 num_experts=256을 별도로 정해야 한다. 효율형은 moe_router_topk=6, 정확도형은 moe_router_topk=24다. 원래 64개·6개를 그대로 두고 latent size만 512로 바꾸면 그림 4의 압축만 한 쪽에 가깝고, 논문의 추천 정확도형이 아니다.
shared expert·intermediate layer·activation·layer 수·학습 설정도 따로 맞춰야 한다. 코드의 기본 top-k는 2이므로 옵션을 빼먹으면 논문의 6 또는 24와 다르다. 여기의 숫자는 구조 대응 예제이며, 누락된 데이터·optimizer·분산 설정까지 채운 학습 실행 명령은 아니다.
15.3 Router softmax와 top-k 적용 순서
router가 expert 점수 4개를 만들고 그중 2개를 선택한다고 하자. 전체 4개 점수를 먼저 확률로 만든 뒤 상위 2개만 남기면, 남긴 확률의 합은 보통 1보다 작다. 반대로 상위 2개를 먼저 고른 뒤 그 둘만 확률로 만들면 합이 1이 된다. 고른 expert가 같더라도 출력에 곱하는 weight는 달라진다.
원문 식은 전체 점수에 softmax를 적용한 p′를 만든 뒤 선택 집합을 합산한다. 반면 이 공개 코드의 기본은 moe_router_score_function="softmax", moe_router_pre_softmax=False로, 기본 softmax 경로에서 top-k 선택 뒤 normalization한다. moe_utils.py에서 이 분기를 확인할 수 있다.
논문의 명시적 식에 맞추려면 --moe-router-pre-softmax를 따로 설정해야 한다. 다만 실제 논문 학습 recipe가 공개된 것은 아니므로 저자들이 내부 실행에서 어느 옵션을 썼는지 이 기본값만으로 단정하지 않는다. 공식 코드가 있다는 사실과 논문 수식의 normalization 순서가 기본 설정에 그대로 반영돼 있다는 주장은 다르다.
15.4 Megatron-Core 실행 전 config 제약
이 pin에서 latent projection은 Transformer Engine 설치를 요구한다. 선택 expert를 순차적으로 실행하는 구현을 고르더라도 투영 층 자체에 이 조건이 걸린다. inference-optimized 분기도 해당 확인 뒤 실행 층을 선택하므로 이 버전에서 의존성이 저절로 사라지는 것은 아니다.
또한 latent projection과 moe_shared_expert_overlap=True는 함께 쓸 수 없다. 전처리 경로가 실행 중 assertion으로 막는다. 논문이 추가 최적화로 제안한 공유 expert 겹침이 이 공개 pin의 latent 경로에서 지원된다고 생각하고 켜면 실패한다. 논문의 향후 개선 제안과 검토한 릴리스의 기능을 구별해야 하는 구체적인 예다.
CLI는 latent size가 양수이고 MoE·MCore 모델인지 확인한다. 그러나 CLI를 거치지 않고 TransformerConfig(moe_latent_size=0)을 직접 만들면 조건식 차이가 생길 수 있다. 투영 생성 쪽은 0을 꺼진 값으로 취급하지만 expert 차원 쪽은 None인지로 판단하기 때문이다. 사용하지 않을 때는 None, 사용할 때는 양수를 주는 경계를 지켜야 한다. 이는 코드 정적 검토에서 발견한 위험이며 이 글에서 실제 오류 실행을 재현한 것은 아니다.
15.5 공식 unit test가 확인하는 범위
실제 테스트 파일은 test_latent_moe_layer.py다. allgather·alltoall 두 dispatcher, latent size 8·16, 세 expert 구현을 조합한 12가지 조건을 정의한다. 작은 hidden size 32, expert 4개, top-k 2를 사용해 공유·선택 expert와 router의 차원, 한 번의 forward 결과 차원을 확인한다.
이 테스트의 핵심은 들어갈 때 d, 선택 expert에서는 ℓ, 나올 때 다시 d라는 구조가 연결됐는지다. 여러 GPU 사이의 통신량·성능, gradient와 optimizer 갱신, 학습 수렴, 논문 표 3–5나 시뮬레이션 그림 7을 검증하는 테스트는 아니다. 이번 리뷰에서는 GPU 테스트 자체를 실행하지 않고 테스트 코드의 확인 항목을 읽었다.
재현을 이어가려면 구조·normalization·부하 균형 설정을 명시한 뒤, 공개된 작은 테스트의 범위와 별도로 backward 수치와 실제 분산 통신을 확인해야 한다. 논문 결과 재현에는 학습 데이터·token 예산·평가 프로토콜과 동일한 실행 환경도 필요하다. 비공개 시뮬레이터의 최대값을 이 공식 모듈 테스트 통과로 검증했다고 대신할 수는 없다.
16. LatentMoE의 한계와 추가 검증
16.1 저자가 남긴 kernel·communication 최적화
저자들은 작은 expert 행렬에 맞는 커널과 공유·선택 expert의 실행 겹침을 추가 개선 방향으로 제시한다. 따라서 vector 폭을 줄인 설계의 이론적 이득이 현재 소프트웨어에서 모두 실현됐다고 주장하지 않는다. 같은 하드웨어에서도 커널 구현과 batch 조건에 따라 표 5가 달라질 여지가 있다.
기본 모델에 맞춘 hyperparameter를 그대로 썼으므로 LatentMoE에 별도 튜닝하면 더 좋아질 가능성도 언급한다. 그러나 가능성과 측정된 개선은 구분해야 한다. 추가 튜닝으로 어느 점수가 얼마나 오르는지 이 논문에는 없다. quantization·pruning·다른 잔차 연결 방법과 결합할 수 있다는 제안도 조합별 검증 결과와 같지 않다.
16.2 Simulation과 측정값의 해석 범위
첫째, “optimal”이라는 제목을 전역 최적성 증명으로 읽지 않는다. 제한된 압축비·모델군·학습 조건에서 더 좋은 절충을 보인 설계 탐색이다. 모든 MoE 구조와 모든 장치·트래픽을 이겼다는 실험은 없다.
둘째, 효율형이 정확도를 보존한다는 요약은 과제별 평균과 함께 읽는다. 두 모델군 모두 수학·상식 하락이 반복됐다. 같은 비용 정확도형과 낮은 활성 비용 효율형을 한 모델의 동시 장점처럼 합치면 안 된다.
셋째, 검증 loss 곡선·실제 throughput 표·비공개 시뮬레이션은 서로 다른 증거다. 특히 Qwen dense model의 크기 곡선을 Kimi MoE에 옮긴 EPM 추정의 불확실성이 큰 모델 비교에 영향을 줄 수 있다. 정확도를 실제로 맞춘 모델끼리 동일한 입력·출력 조건에서 측정하면 이 부분을 더 강하게 검증할 수 있다.
넷째, 논문 전체 18쪽에서 본문은 15쪽 첫 부분까지이고 나머지는 참고문헌이다. 별도의 실험 부록은 이 버전에 없다. 숨겨진 부록에 학습 데이터나 전체 재현 설정이 있는 것으로 가정하지 않았다. 공개되지 않은 항목은 공개되지 않은 상태로 남겨야 한다.
17. LatentMoE와 다른 model compression 방법 비교
quantization은 숫자 하나를 저장하고 계산하는 precision를 줄이는 방법이다. expert pruning는 일부 expert를 제거하고, 병합은 여러 expert 정보를 더 적은 수로 합치는 방향이다. LatentMoE는 token이 expert 경로를 통과할 때의 vector 폭과 expert 조합을 함께 설계한다. 바꾸는 지점이 다르므로 함께 사용할 가능성은 있지만, 이 논문이 모든 조합의 정확도·성능을 검증한 것은 아니다.
저자들은 가장 가까운 작업으로 MoLAE를 든다. 논문 §5의 비교에 따르면 MoLAE는 학습 후 expert weight의 저랭크 근사를 이용하고, 정확도 저하를 줄이기 위해 latent projection을 그룹화하며 일부 expert 행렬인 FC2 쪽에 압축을 제한한다. 이 서술은 LatentMoE 저자들이 제시한 비교 관점이다. 이 리뷰에서 MoLAE 원문과 구현을 별도로 재현해 직접 성능을 겨룬 것은 아니다.
LatentMoE 쪽의 차이는 dispatch 전부터 짧은 vector를 사용하고, 절감분을 전체 expert 수와 활성 expert 수에 재투자하는 데 있다. 이미 학습한 임의의 MoE 모델에 후처리 압축을 붙이면 같은 결과가 난다고 읽으면 안 된다. 제시된 정확도 근거는 해당 구조로 pre-training한 모델 비교다.
원문은 여러 잔차 경로를 연결하는 mHC와도 상호보완적일 수 있다고 제안한다. mHC는 expert 입력 폭보다 잔차 정보의 연결 구조를 바꾸는 쪽이다. 논문은 둘을 실제로 함께 학습한 비교 결과를 제시하지 않으므로 결합 가능성은 후속 질문으로 남는다. Nemotron-3 Super·Ultra 채택 역시 원문과 NVIDIA 소개가 보고한 적용 사례로 구분하며, 이 논문의 95B·73B 결과를 곧바로 그 제품 전체 성능으로 옮기지 않는다.
이 연구에서 배울 가장 실용적인 점은 expert 계산량과 실제로 옮기는 정보량을 같은 설계표 위에 놓는 것이다. 정확도형은 비슷한 모델 규모에서 여러 평가 평균을 높였고, 효율형은 활성 크기를 줄이는 대신 일부 능력 저하를 보였다. 다음으로 가장 필요한 비교는 동일 정확도를 실제로 확인한 모델끼리 입력·출력 길이와 하드웨어를 고정해 측정하고, 원래 폭 routing·압축·expert 증가가 각각 만든 차이를 분리하는 것이다. 그런 근거가 있어야 최대 시뮬레이션 숫자에서 실제 서비스 선택으로 안전하게 넘어갈 수 있다.
18. 출처
- 원문 PDF, arXiv:2601.18089v1: method·학습 설정·전체 실험과 figure·table의 근거.
- 검토한 후속 공식 구현: 본문에서 대조한 공개 구현·설정의 고정 버전.
moe_layer.py: 본문에서 대조한 공개 구현·설정의 고정 버전.experts.py: 본문에서 대조한 공개 구현·설정의 고정 버전.TransformerConfig: 본문에서 대조한 공개 구현·설정의 고정 버전.
자료 확인·수정: 2026년 9월 16일. 검토한 원문과 공개 구현의 버전은 위에 고정했다. 이번 수정에서는 전문 용어, 설명 문장, 검색 주제가 드러나는 제목과 이미지 배치를 보완했다.
관련 글
Paper Review
A Defense of the Quadratic Model — LLM 학습의 Gauss–Newton 근사와 안정성 분석
A Defense of the Quadratic Model의 Gauss–Newton 근사, Lanczos spectrum과 학습 안정성을 설명한다. batch 64 예제, 원문 figure·table, 공개 코드로 근사가 맞는 조건과 반례를 분석한다.
Paper Review
IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System — voice cloning·병음 발음 제어 분석
IndexTTS v1의 SEQ3 입력, Conformer·Perceiver와 BigVGAN2 구조를 설명한다. 병음 교정률 94%의 분모, CER·WER·SS·MOS와 inference 속도를 원문 figure·table과 코드로 분석한다.
Paper Review
IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech — 감정·발화 길이 제어 원리 분석
IndexTTS2의 T2S·S2M, GRL 감정 분리, GPT latent와 duration control을 설명한다. WER·SS·MOS, ablation과 공개 inference 코드의 제한을 원문 figure·table로 분석한다.