Nanbeige4.2-3B: Unlocking Agentic Capabilities in a Compact Model — 소형 LLM의 looped Transformer·agent 학습 분석
Nanbeige4.2-3B의 looped Transformer, executable data, SFT와 RLHF를 설명한다. length reward 계산, agent benchmark·평가 budget·공개 코드의 한계를 원문 figure·table로 분석한다.
- #논문 리뷰
- #Nanbeige4.2-3B
- #AI agent
- #looped Transformer
- #RLHF
- #agent benchmark
1. Nanbeige4.2-3B 요약: 작은 모델의 reasoning과 agent 학습
Nanbeige4.2-3B는 작은 model에 범용 agent 능력을 모으기 위해 looped pre-training, 실행 환경에 근거한 SFT, 단계별 RL을 결합한다. 논문의 주장은 parameter 수만 줄였다는 것이 아니라, repository·도구·office 환경을 넘나드는 작업을 하나의 작은 model로 수행한다는 데 있다.
최종 평가에서 SWE-bench Verified는 Nanbeige 63.6, Qwen3.5-9B 53.1, Gemma4-12B 44.2다. Terminal-Bench 2.0도 각각 44.1·29.2·21.1이다. 일반 agent 평가의 MCP-Atlas는 Nanbeige 57.8 대 Qwen3.5-9B 47.4다. 이 결과는 여러 agent task에서 작은 model의 경쟁력을 보여주지만 model마다 pre-training data와 연산량을 같게 맞춘 비교는 아니다.
학습 과정의 중요한 결과는 정확도와 reasoning 길이를 함께 개선했다는 것이다. Figure 7에서 PinchBench accuracy는 55.9%→74.7%, 평균 output token은 20.7K→9.7K로 변한다. LiveCodeBench도 65.5%→72.5%, 25.9K→15.4K다. 짧게 답하도록 만드는 것만이 아니라 task success를 유지·개선하며 불필요한 출력을 줄이는 것이 length-controlled RL의 목표다.
같은 OpenClaw framework로 비교한 GDPval은 Nanbeige 68.8, Qwen3.5-9B 38.0이다. 반면 SciCode와 일부 instruction-following task에서는 더 강한 비교 모델이 남아 있다. 본문은 반복 계산으로 만든 base → 실행 가능한 SFT 환경 → reasoning·agent RL의 변화 → 최종 benchmark와 OpenClaw 전이 순서로 각 contribution과 근거를 연결한다.
아래 overview는 agent·reasoning task별 비교를 한눈에 보여준다. 각 task의 정확한 조건과 점수는 뒤의 benchmark 설명에서 확인한다.
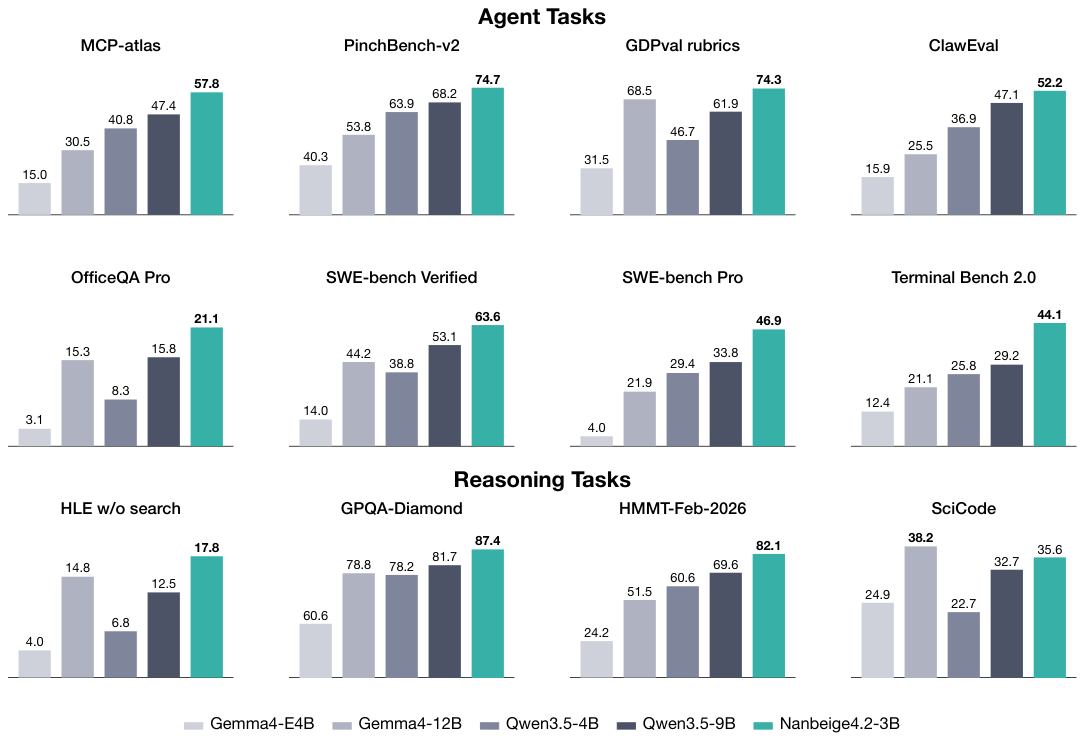
그림 1의 Nanbeige HMMT 점수는 82.1인데 표 3은 82.8이다. Gemma4-E4B의 PinchBench는 그림에서 40.3, 표에서 33.3이다. 이 차이를 설명하는 평가 설정이나 집계 변경은 원문에 없다. 이 글은 결과 설명에서 표 3을 기준으로 삼되, 불일치를 그대로 남긴다. 공개 모델 저장소의 해당 HMMT 평가 기록도 82.1이어서 단순한 반올림으로 처리할 수 없다.
리뷰 대상은 Nanbeige4.2-3B 원문 v2다. Nanbeige LLM Lab·Boss Zhipin의 연구로, 2026년 7월 24일 처음 제출됐고 이 버전은 7월 27일 공개됐다. 학회 채택 논문으로 표기되지 않은 사전 공개 논문이다. 본문과 부록을 포함한 17쪽을 읽고 원문 그림·표·평가 설정을 발췌했다. 저자 명단과 교신저자 Yang Song은 부록 A에 있다. 공개 모델의 같은 날짜 코드도 별도로 확인했다. 여기서 보고하는 점수는 저자들의 결과이며, 이 리뷰에서 모델 학습이나 inference를 실행해 재현한 결과가 아니다.
2. AI agent 배경: answer·action·environment state
2.1 Agent action이 environment state를 바꾸는 과정
단일 문제 풀이에서는 입력을 읽고 답을 출력하면 평가가 끝날 수 있다. agent는 “어느 파일을 열 것인가”부터 선택한다. 잘못된 파일을 읽으면 다음 reasoning의 근거가 틀어지고, 잘못된 도구 인자를 보내면 작업 자체가 실행되지 않는다. 중간에 생긴 실패를 보고 경로를 바꾸는 능력이 필요하다.
이 논문에서 trajectory는 요청부터 완료까지의 여러 차례 상호작용 기록을 뜻한다. 모델의 응답, 도구 호출, 실행 환경의 반환값이 함께 들어간다. 예를 들어 파일 검색 → CSV 읽기 → 합계 계산 → 오류 발견 → 코드 수정 → 다시 실행이 하나의 trajectory가다. 실제 논문 데이터의 예시를 인용한 것이 아니라, 뒤의 데이터 설계를 이해하기 위한 설명용 예다.
또 하나 구분할 것은 모델과 실행 틀이다. 모델은 다음 행동을 제안한다. 실행 틀은 사용할 도구, 시스템 지시, 기록을 유지하는 방법, 제한 시간을 정한다. 논문이 쓰는 scaffold 또는 harness가 이 실행 틀을 가리킨다. 같은 모델도 파일 편집 방식이나 대화 보존 방식이 달라지면 다른 결과를 낼 수 있다.
2.2 Looped Transformer·SFT·RLHF·process reward의 의미
| 용어 | 이 논문에서의 구체적인 의미 |
|---|---|
| 반복 구조, Looped Transformer | 같은 신경망 층 묶음에 중간 표현을 다시 넣어 두 번 계산한다. |
| supervised fine-tuning, SFT | 좋은 작업 기록의 다음 응답을 따라 생성하도록 학습한다. |
| reinforcement learning, RL | 생성한 응답이나 행동에 점수를 주어 더 좋은 선택을 늘린다. |
| RLHF | 사람이 원하는 응답 특성을 반영한 reward model로 형식·관련성·종료 등을 보정한다. |
| rubric | “올바른 파일을 만들었는가”처럼 결과나 행동을 평가하는 구체적인 기준이다. |
| process reward | 최종 성공 여부 외에 중간 tool action에도 주는 점수다. |
| Think / Non-Think | 명시적인 reasoning 내용이 있는 응답과, 그런 내용을 생략하는 응답 모드다. |
이 표의 세 가지 학습 단계는 역할이 다르다. SFT는 가능한 작업 경로를 보여 준다. RLHF는 반복이나 형식 오류로 경로가 끊어지는 일을 줄인다. reasoning·agent RL은 길이와 작업 성공을 직접 다룬다. 뒤의 결과를 읽을 때도 어느 단계의 전후 비교인지 구분해야 한다.
3. Pre-training: looped Transformer의 반복 계산
3.1 같은 Transformer layer를 다시 계산하는 loop
작은 모델의 능력을 키우는 직접적인 방법은 층을 추가하는 것이다. 하지만 층마다 별도의 weight를 저장하면 모델 크기도 커진다. Nanbeige는 첫 번째 통과에서 만든 중간 표현을 같은 층 묶음에 다시 넣는다. 사람에게 두 번 읽으라고 하는 것과 완전히 같은 과정은 아니지만, 저장한 계산 규칙을 다시 적용한다는 점은 직관적으로 이해할 수 있다.
층 묶음을 함수 라고 쓰면, 핵심 구조를 설명하는 식은 다음과 같다.
는 입력 token을 vector로 바꾼 표현이고, 과 는 첫 번째·두 번째 통과 결과다. 두 식의 아래첨자 가 같다는 것이 핵심이다. weight를 두 벌 만들지 않는다. 이 식은 원문의 설명을 풀어 쓴 개념식이며 normalization·위치 정보·cache 처리를 모두 표시한 실제 코드 식은 아니다.
그렇다고 계산이 공짜가 되지는 않는다. 같은 층을 다시 실행해야 한다. 공개 설정에서는 22개 층을 두 번 통과하므로 층 실행은 44회에 해당하지만, 서로 다른 weight를 가진 층은 22개다. 저장할 parameter 수가 같은 일반적인 한 번 통과 모델과 계산량까지 같다고 비교하면 안 된다.
3.2 2회 loop와 from-scratch pre-training 조건
저자들은 일반 Transformer를 먼저 학습한 뒤 반복 구조로 바꾸는 방법보다, 처음부터 반복 구조로 학습하는 쪽이 더 좋았다고 설명한다. 반복해서 쓰일 것을 전제로 내부 표현이 형성되는 편이 유리하다는 해석이다. 이 비교의 정확한 점수와 학습 비용은 별도 표로 제공되지 않는다.
통과 횟수를 늘리는 실험도 했다고 한다. 두 번 통과는 일반 Transformer 대비 약 75%의 token efficiency를 유지하면서 능력을 높였고, 더 많이 통과하면 추가 개선은 작고 학습은 느려지며 불안정해졌다는 설명이다. 그러나 token efficiency의 측정 정의와 장비·throughput 수치가 제시되지 않아 이를 “inference 속도가 75%”라고 바꿔 읽을 수 없다.
과거 token의 정보를 보관하는 KV cache를 두 통과 사이에서 공유하는 변형도 검토했다. cache 크기는 절반이 되지만 성능 개선이 작아 최종 모델은 공유하지 않는 구성을 선택했다. 이 역시 정확한 성능 차이와 통제 조건이 없는 서술 결과다. 뒤에서 읽을 표 1은 반복 구조만 하나씩 바꾼 ablation이 아니다.
3.3 Looped pre-training 이후 base benchmark의 변화
pre-training 데이터는 28조 token이다. 수학, 코드, 합성 질의응답의 비중을 높이고 agent trajectory도 소량 포함했다. 각 종류의 정확한 비율은 공개하지 않았다. 따라서 결과는 반복 구조와 개선된 데이터 구성을 합친 모델의 결과로 읽어야 한다.
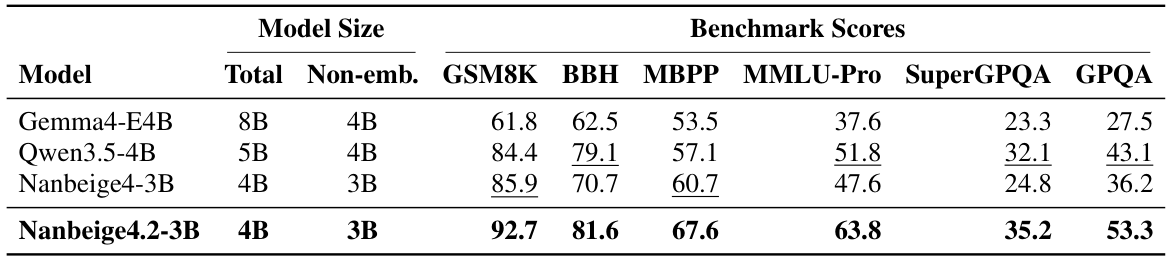
이전 Nanbeige4-3B와 비교하면 GSM8K는 85.9에서 92.7, BBH는 70.7에서 81.6으로 올랐다. 각각 수학 문장 문제와 다양한 어려운 reasoning 과제를 다룬다. 짧은 프로그램을 만드는 MBPP도 60.7에서 67.6으로 상승했다. 지식과 reasoning이 섞인 MMLU-Pro는 47.6에서 63.8, SuperGPQA는 24.8에서 35.2, GPQA는 36.2에서 53.3이다.
표에 있는 Qwen3.5-4B와 Gemma4-E4B보다도 여섯 점수가 모두 높다. 예를 들어 Qwen의 GPQA 43.1에 비해 Nanbeige는 53.3이다. 다만 이 비교는 모델별 pre-training 데이터와 구조가 다르다. “반복 계산 하나로 10.2점이 올랐다”는 인과 해석은 성립하지 않는다.
모델 이름의 숫자도 동일한 기준이 아니다. 표 1은 Nanbeige를 전체 4B·embedding 제외 3B, Qwen을 5B·4B, Gemma E4B를 8B·4B로 적는다. 적은 weight로 좋은 결과를 냈다는 관찰과, 같은 계산·데이터 예산에서 가장 효율적이라는 주장은 구분해야 한다.
4. Coding agent data: 실행 가능한 repository task 만들기
4.1 Repository snapshot과 hidden patch 분리
버그 수정 학습 데이터를 만들 때 “이런 버그를 고쳐라”라는 문장만 합성하면 문제가 실제로 존재하는지 알기 어렵다. 수정 결과를 판정할 기준도 모호해진다. 논문은 실제 저장소의 변경 기록에서 문제를 만들고, 수정 직전 상태를 실행 환경으로 복원한다.
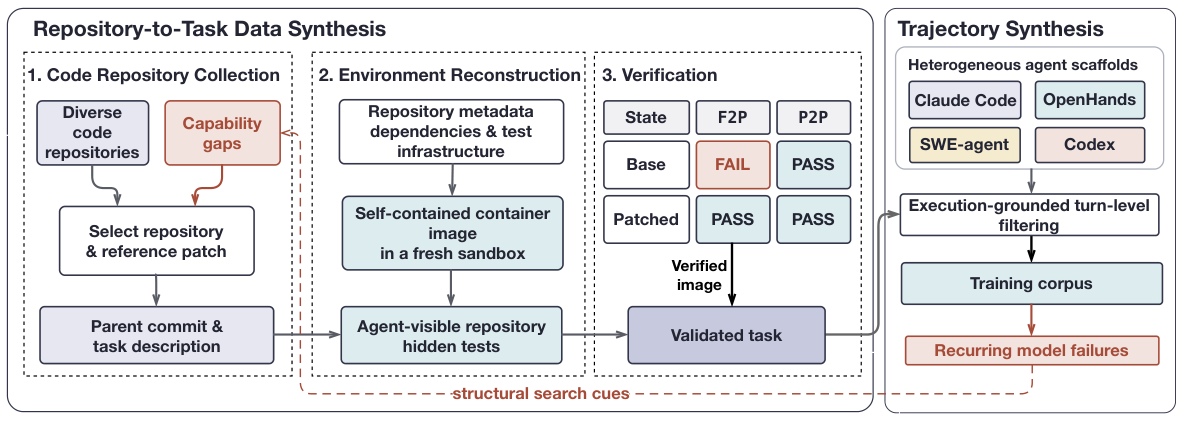
기준 수정본에 해당하는 패치를 고른 뒤 그 부모 커밋으로 컨테이너를 만든다. 모델에는 수정 전 저장소와 작업 설명을 보여 준다. 정답 패치와 채점용 테스트는 숨긴다. 테스트는 평가할 때 주입한다. 이렇게 해야 모델이 정답 파일을 읽어 복사하는 것과 문제를 해결하는 것을 구분할 수 있다.
저장소를 고르는 기준에도 모델의 실패를 사용한다. 예를 들어 여러 파일 사이의 관계를 못 찾아 자주 실패한다면 그런 구조가 있는 저장소를 더 찾는 식이다. 이는 설명을 위한 예시이며 논문이 특정 실패 유형의 개수나 실제 검색어를 제공한 것은 아니다. 원문은 반복적으로 관찰한 실패를 다음 저장소 탐색의 단서로 바꾼다고 설명한다.
4.2 Coding task 예제: 할인 계산 버그 수정
다음은 원문 데이터가 아닌 이해를 위한 가상 작업이다. 요청은 “할인율 0일 때도 주문 합계가 정상적으로 계산되도록 고쳐라”라고 하자. 수정 전 코드는 할인율을 잘못 처리해 0으로 나누는 오류가 난다. 올바른 경로는 관련 함수를 찾고, 경계 조건을 수정하고, 할인율 0과 기존 할인 사례를 모두 확인하는 것이다.
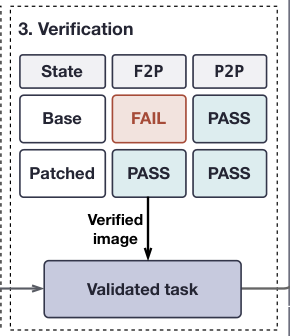
첫 번째 테스트 묶음은 수정 전 실패하고 수정 후 성공해야 한다. 이것이 fail-to-pass, F2P다. 예시에서는 할인율 0인 주문이 여기에 해당한다. 두 번째 묶음은 수정 전후 모두 성공해야 한다. 이것이 pass-to-pass, P2P다. 할인율 10%인 정상 주문이 갑자기 틀어지지 않는지 보는 것이다.
이 두 조건을 함께 두면 “모든 주문을 0원으로 반환해 예외만 없애기” 같은 엉뚱한 수정은 탈락할 수 있다. 다만 테스트가 모든 잘못된 해법을 잡는다는 보장은 없다. 논문은 작업 설명·숨겨진 테스트·기준 패치가 같은 요구를 표현하는지 점검하고, 깨졌거나 불안정하거나 명세가 부족한 문제는 고치거나 버린다고 설명한다.
4.3 성공 trajectory 안의 잘못된 action 처리
같은 문제를 Claude Code, OpenHands, SWE-agent, Codex 기반 실행 틀 등에서 풀게 해 다양한 작업 경로를 모은다. 도구 이름이나 편집 방식이 달라도 문제 해결의 핵심을 배우게 하려는 설계다. 그러나 이런 다양성만으로 새로운 모든 도구에 generalization이 보장되지는 않는다. 그 효과만 분리한 비교표는 없다.
우선 최종 패치가 목표 테스트와 회귀 테스트를 통과한 trajectory를 고른다. 그 안에서도 잘못된 도구 호출, 끝나지 않는 반복, 불필요한 행동, 문맥 잘림을 점검한다. 마지막에는 모델 메시지·도구 호출·환경 반환값을 공통 형식으로 맞춘다. 실패를 어떻게 학습 loss에서 제외하면서도 문맥에는 남기는지는 7장에서 다시 살펴본다.
원문에는 이 pipeline의 전체 시스템 prompt, 실제 저장소 작업 한 건의 완전한 대화, 필터별 통과율이 없다. 따라서 위 할인 예시를 “논문이 공개한 학습 sample”로 오해하면 안 된다.
5. Tool-use data: 도구 연결과 난도 조절
5.1 세 tool environment의 feedback 차이
여러 도구를 쓴다는 것은 도구 이름을 많이 외운다는 뜻이 아니다. 고객 검색의 반환값인 고객 ID를 주문 조회의 입력으로 넘기는 것처럼, 앞선 결과가 다음 행동의 인자가 되어야 한다. 논문은 수천 개의 실제 MCP 서버 도구 명세에서 이런 연결 가능성을 검토한다. MCP는 여기서 모델이 외부 도구를 호출할 때 사용하는 연결 규약을 뜻한다.
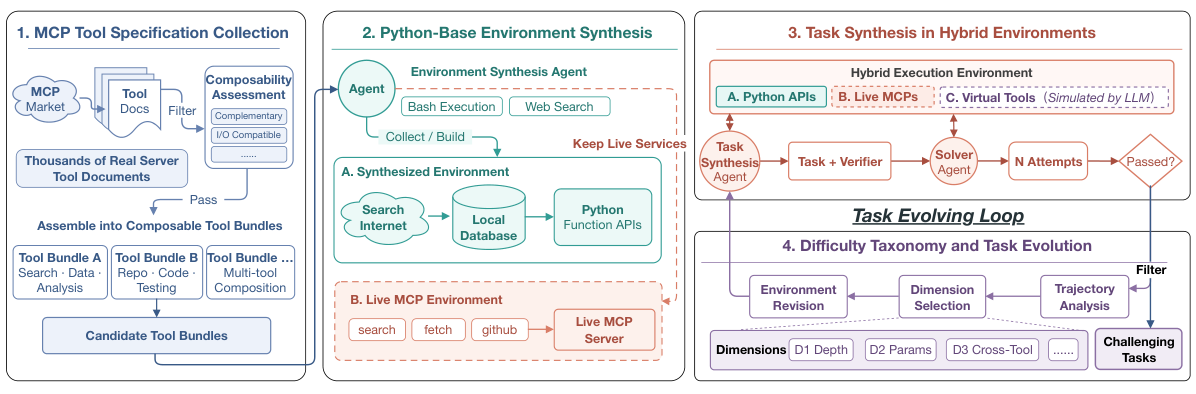
함께 쓸 수 있는 도구를 묶은 다음, 인터넷에서 관련 데이터를 모아 로컬 데이터베이스에 저장하고 Python 함수 형태의 도구를 만든다. 그러나 모든 환경을 정적인 함수로 바꿀 수는 없다. 오늘의 검색 결과나 변하는 저장소 상태는 실제 온라인 서비스를 남겨 두고, 복잡한 실행 환경을 재구성하기 어려운 도구는 언어 모델로 출력을 모사한다.
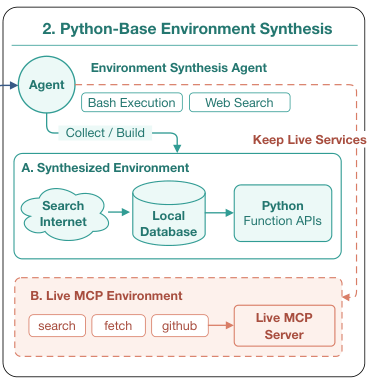
예를 들어 고정된 고객 목록 조회는 로컬 함수로 반복 실행하기 쉽다. 최신 뉴스 검색은 온라인 도구를 쓰는 편이 자연스럽다. 복잡한 사내 시스템의 반응을 언어 모델로 대신 만든다면 작업 종류는 넓힐 수 있지만, 실제 시스템의 오류와 상태 변화까지 같다고 볼 수는 없다. 이 예시들은 세 환경의 차이를 설명하는 해석이며, 원문에 공개된 특정 고객 데이터가 아니다.
따라서 이 데이터의 강점은 실행 가능한 도구와 실제 데이터를 일부 결합했다는 데 있다. 모든 환경이 완전히 실제 서비스와 같다는 증거는 아니다. 합성 환경의 타당성을 따로 평가한 수치는 제공되지 않는다.
5.2 Task generator의 난도 조절
작업 생성기는 자연어 요청과 Python 검증 함수를 함께 만든다. 해결 모델이 여러 번 시도한 뒤 안정적으로 푸는 문제는 더 어렵게 바꾼다. 도구를 연결하는 단계 수를 늘리거나, 필요한 정보를 찾기 어렵게 하거나, 입력 인자를 직접 reasoning하게 하는 식이다.
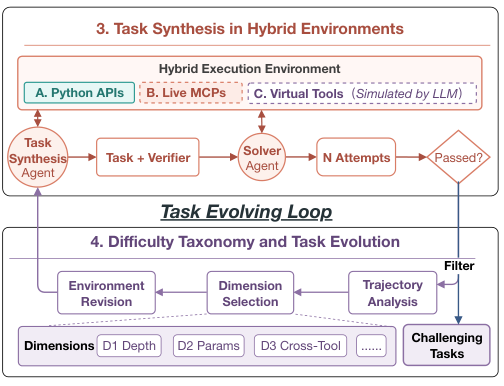
처음에는 “고객 42의 주문을 조회하라”였다가 다음에는 “지난주 환불이 가장 많았던 고객을 찾아 주문 사유를 분석하라”로 바뀔 수 있다. 후자는 고객 ID를 먼저 알아내고 여러 도구 결과를 연결해야 한다. 이것도 구조를 설명하기 위한 가상 예다. 구체적인 생성 prompt와 시도 횟수 N의 값은 원문에 없다.
개발 중 빠르게 확인할 별도 과제 묶음도 만든다. 저자들은 학습 데이터와 분리했다고 설명한다. 다만 정확한 항목 수와 데이터가 공개되어 있지 않아 독자가 이 글만으로 중복 여부를 재검사할 수는 없다. 나중에 그림 6의 학습 경향은 이 빠른 검증용 과제에서 측정한다.
6. Office task data: 문서·표·파일 사이의 관계
사무 작업은 답변 문장보다 최종 파일이 중요할 때가 많다. 보고서 숫자와 스프레드시트 숫자가 맞아야 하고, 발표 자료가 원문 보고서의 조건을 유지해야 한다. 논문은 금융·무역·법률·의료 등 여러 분야의 보고서, 슬라이드, 표, PDF, 이메일을 모아 이런 작업을 구성한다.
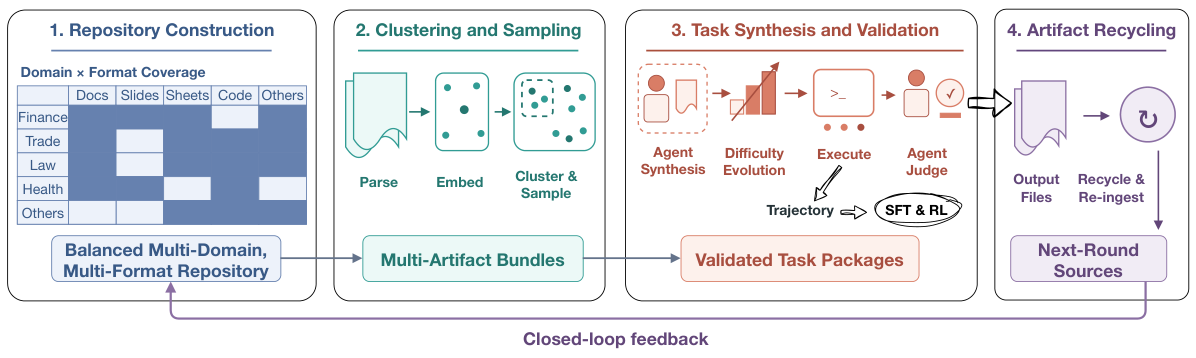
먼저 문서를 읽어 공통 표현으로 바꾸고 의미가 비슷한 자료끼리 묶는다. 여기서 embedding은 문서 내용을 비교하기 위한 vector 표현이다. 관련 있는 파일을 함께 고르면 “이 표를 근거로 보고서를 수정하라”처럼 여러 자료를 연결하는 문제를 만들 수 있다.
작업 생성기는 요청과 채점 기준을 함께 만든다. 여러 파일의 일관성, 필요한 도구, 절차 길이, 제약 조건 등을 바꾸면서 난도를 높인다. 다른 공개 모델들이 실제로 작업해 trajectory와 결과 파일을 만든 뒤, 별도 판정 agent가 요구사항 충족·채점 기준의 일관성·과정 품질을 확인한다.
예를 들어 결과물이 “분기 매출 요약”이라면 합계가 맞는지만 볼 것이 아니라 통화 단위, 대상 기간, 제외한 항목까지 맞아야 한다. rubric은 이런 조건을 평가 항목으로 나눈 것이다. 원문에는 그 항목 전체나 실제 업무 요청의 완전한 예시가 없으므로, 여기서 특정 채점 배점을 논문 설정처럼 만들지는 않는다.
검증을 통과한 파일은 다음 작업의 재료로 다시 넣는다. 자료를 계속 확장할 수 있다는 장점이 있다. 반대로 판정기가 놓친 오류가 다음 합성에 이어질 가능성도 있다. 이는 재사용 구조에서 도출한 추가 관찰이며, 저자들이 측정해 보고한 오류율은 아니다.
7. SFT: long context·실패 복구·loss masking
7.1 64K·256K context와 SFT token 구성
긴 작업 기록을 처음부터 같은 비율로 학습시키는 대신, 최대 학습 문맥을 64K, 128K, 256K로 늘리는 세 단계를 사용한다. 초반에는 수학·과학·코드 reasoning을 중심에 두고, 뒤로 갈수록 긴 도구 작업을 많이 학습한다.
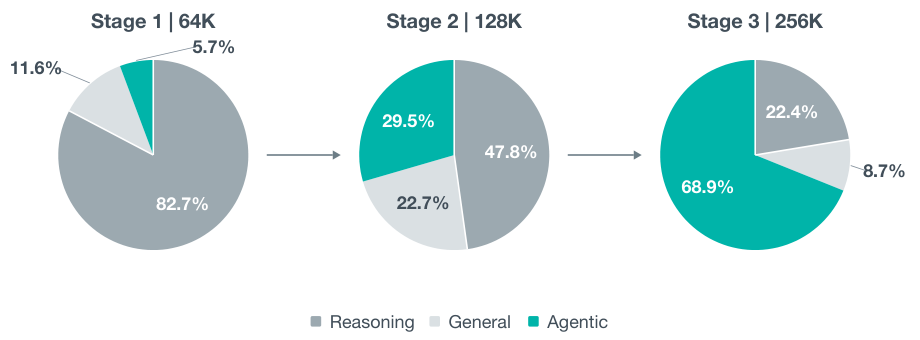
64K 단계는 reasoning 82.7%, 일반 지시 11.6%, agent 5.7%다. 128K에서는 각각 47.8%, 22.7%, 29.5%가 된다. 256K에서는 reasoning 22.4%, 일반 지시 8.7%, agent 68.9%로 작업 기록이 중심이 된다. 각 단계의 세 비율은 100%로 합쳐진다.
여기서 중요한 단위는 목표 token이다. 긴 작업 한 건은 짧은 질의응답 한 건보다 훨씬 많은 학습 token을 차지할 수 있다. 따라서 “마지막 단계에서 데이터 파일의 68.9%가 agent sample”이라고 바꿔 말할 수 없다. 단계별 전체 token 수와 sample 수가 없으므로 실제 데이터 건수를 역산할 수도 없다.
7.2 실패 action의 loss mask와 관찰 기록
도구 호출을 한 번 잘못한 뒤 오류 메시지를 읽고 복구해 결국 성공한 기록을 생각해 보자. 실패 부분을 통째로 지우면 다음 행동이 왜 필요한지 이해하기 어렵다. 반대로 모든 응답을 그대로 학습시키면 잘못된 도구 호출까지 정답처럼 따라 하게 된다.
논문은 각 모델 응답 차례에 학습 여부를 표시하는 0 또는 1의 mask를 둔다. 잘못된 응답은 loss 계산에서 제외하지만, 그 응답과 도구의 오류 메시지는 뒤의 문맥에 그대로 남긴다. 예를 들어 잘못된 열 이름으로 CSV를 읽은 행동은 따라 배우지 않고, column not found를 본 뒤 올바른 열 이름을 찾는 행동은 학습한다.
이 원리를 간단히 표시하면 다음과 같다. 실제 논문의 완전한 최적화식이 아니라 mask의 역할을 풀어 쓴 식이다.
는 모델의 응답 차례, 는 그 차례의 응답을 학습하는 loss다. 이면 그 응답을 정답으로 학습하지 않는다. 다만 다음 응답이 읽는 문맥에서 삭제한다는 뜻은 아니다. 이 차이가 “실수 없이 행동하는 모양”과 “실수한 뒤 회복하는 방법”을 함께 다루게 한다.
mask 판정에는 실행 결과와 평가 기준을 쓴다고 설명하지만, 모든 기준의 prompt나 경계값은 공개하지 않았다. 따라서 동일한 원리의 구현과 동일한 학습 데이터의 재현은 다른 문제다.
8. 2단계 RLHF: reasoning·coding·agent 성능 변화
SFT 이후에도 모델은 같은 생각을 반복하거나, 답을 두 번 쓰거나, 잘못된 형식으로 도구를 호출하거나, 끝내야 할 때 계속 생성할 수 있다. 논문은 개별 응답을 평가하는 reward model로 이런 행동을 먼저 조정한다. 정답성, 관련성, 형식, 적절한 종료를 reward하고 반복과 비정상적 연속 생성을 줄인다. 안전성과 사용자 친화성도 reward 특성에 포함한다고 설명한다.
처음에는 Think 응답을 학습하고 다음 단계에서는 주로 Non-Think 응답을 학습한다. 그러나 표 2의 세 모델은 모두 Think 모드, 같은 decoding 설정으로 평가한다. 마지막 열의 이름은 학습 단계이지, 평가에서 reasoning을 끈다는 뜻이 아니다.
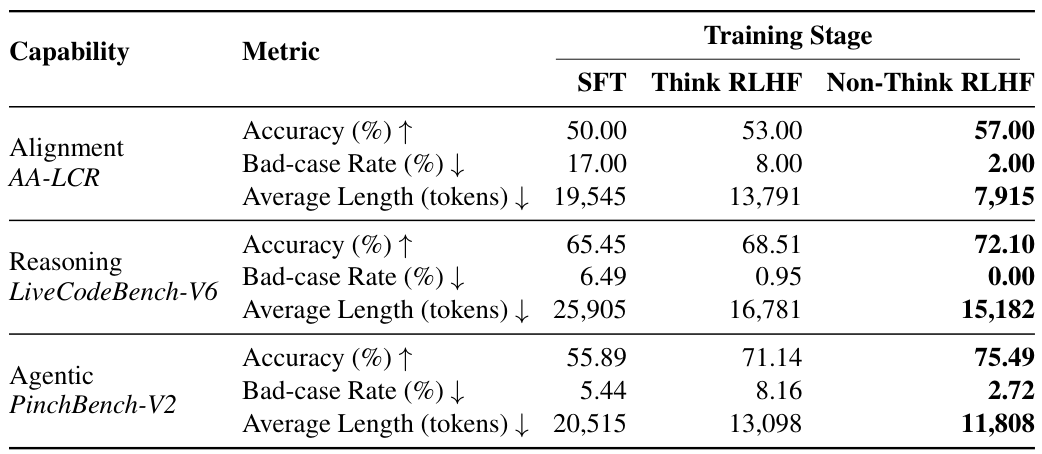
표의 bad-case는 형식 오류가 있거나 길이 제한을 초과한 사례의 비율이다. 일반적인 정답 실패율과 같지 않다. 문장이 정상적으로 끝났지만 답이 틀린 경우도 있다. 따라서 bad-case가 0%인 평가를 “모든 문제를 맞혔다”라고 읽으면 안 된다.
8.1 AA-LCR: long-context reasoning
긴 문맥을 읽고 reasoning하는 AA-LCR 정확도는 50.00%에서 53.00%, 57.00%로 오른다.
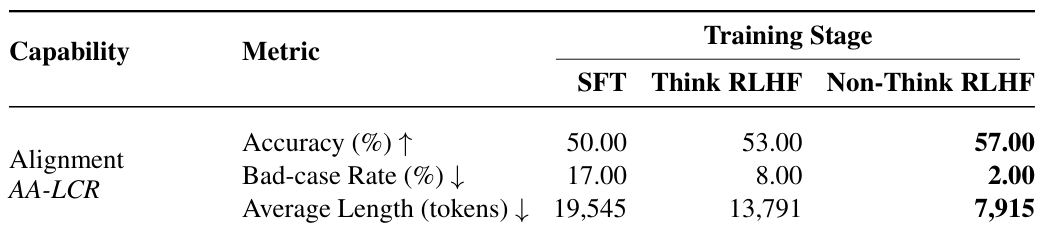
문제 응답 비율은 17.00%에서 8.00%, 2.00%로 줄고, 평균 출력은 19,545token에서 13,791token, 7,915token으로 짧아진다.
답을 더 짧게 하면서도 정확도가 높아졌다는 점이 핵심이다. 반복이나 비정상적 종료를 줄이면 기존 reasoning 능력이 결과로 연결되기 쉬워진다는 저자들의 해석과 맞는다. 다만 세 지표가 함께 변했다고 정확도 상승분 전체가 형식 개선 때문에 생겼다고 분해할 수는 없다.
8.2 LiveCodeBench-V6: coding reasoning
LiveCodeBench 정확도는 65.45%에서 68.51%, 72.10%로 오른다.
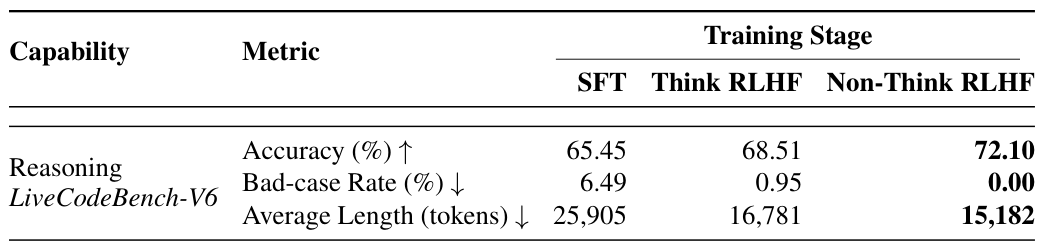
문제 응답 비율은 6.49%에서 0.95%, 0.00%다. 평균 길이는 25,905token에서 16,781token, 15,182token이다.
마지막 모델에도 약 28%의 정답 실패가 남는다. bad-case 0%는 논문이 지정한 형식·길이 문제를 관찰하지 않았다는 뜻이다. algorithm을 틀리거나 구현이 잘못되는 실패까지 사라진 것은 아니다. 이 구분은 reward model이 무엇을 고쳤는지 판단할 때 중요하다.
8.3 PinchBench: RLHF 중간 단계의 성능 하락
PinchBench 정확도는 55.89%에서 71.14%, 75.49%로 오른다.
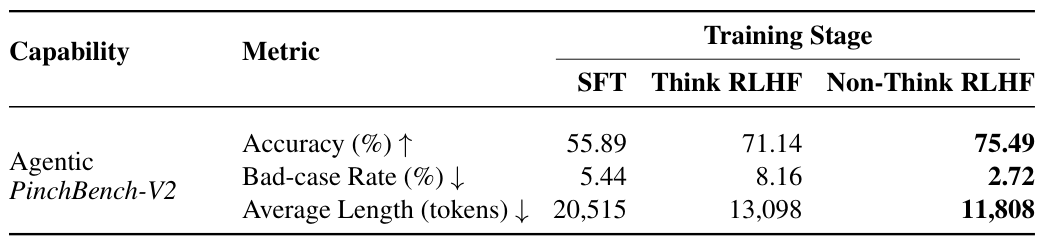
평균 길이도 20,515token에서 13,098token, 11,808token으로 감소한다. 그러나 문제 응답 비율은 5.44%에서 먼저 8.16%로 높아졌다가 마지막에 2.72%로 내려간다.
따라서 “모든 단계에서 모든 오류가 꾸준히 줄었다”는 설명은 맞지 않는다. 중간 모델은 과제를 더 잘 풀면서도 형식·길이 문제는 늘었다. 마지막 Non-Think 중심 학습 이후 Think 평가에서도 이 비율이 낮아지는 패턴이 교차 모드 개선의 관찰 근거다.
이 표는 순서대로 학습한 checkpoint의 비교다. 같은 시작점에서 Think 전용과 Non-Think 전용 학습만 따로 바꾼 완전한 통제 실험은 아니다. 또 최종 전체 reinforcement learning 결과인 표 3의 PinchBench 74.7과 여기의 75.49는 서로 다른 단계이므로 섞어 쓰지 않는다.
9. Reasoning length reward: 문제별 출력 길이 조절
9.1 고정 length penalty가 어려운 문제에 미치는 영향
간단한 덧셈을 수천 token 동안 푸는 것은 낭비일 수 있다. 반면 어려운 증명을 짧게 끝내라고 압박하면 필요한 탐색을 포기할 수 있다. 논문은 문제별 기준 길이와 현재 모델의 성공 정도를 함께 사용한다.
각 문제에서 이전 checkpoint들이 맞힌 응답을 모아 길이의 중앙값을 구한다. 이것을 그 문제의 고정 길이 예산으로 둔다. 학습 중 매번 기준을 바꾸지는 않는다. 현재 생성한 여러 응답 중 정답의 비율은 별도로 계산한다. 많이 맞히는 문제라면 불필요하게 길어지는 응답을 더 강하게 줄이고, 아직 잘 못 푸는 문제에는 약한 압력을 준다.
9.2 Length reward 식 1의 계산 예제
원문의 길이 제약 단계는 기본 과제 reward에서 다음 벌점을 뺀다.
는 응답 i의 기본 과제 reward다. 는 그 응답의 길이, 는 문제 q의 고정 예산, 는 최대 생성 길이다. 는 현재 생성 묶음에서 완전히 맞힌 응답의 비율이다. 는 벌점 크기를 조절한다. clip은 괄호 안 값이 0보다 작으면 0, 1보다 크면 1로 제한한다.
설명용으로 예산 1,000token, 최대 길이 5,000token, 실제 응답 3,000token을 생각하자. normalize한 초과 길이는 0.5다. 현재 정답 비율이 0.8이고 벌점 계수를 0.5로 정하면 벌점은 다음과 같다.
정답 reward가 1이면 최종 reward는 0.8이다. 같은 길이라도 아직 어려워 정답 비율이 0.2인 문제라면 벌점은 0.05로 줄어든다. 예산 안에 들어오는 응답은 벌점이 0이다. 이 숫자는 식을 이해하기 위한 계산이며 논문이 사용한 실제 hyperparameter가 아니다.
정답 reward가 1, 오답 reward가 0인 경우에는 이면 길이와 관계없이 정답의 reward가 오답보다 높다는 성질이 있다. 벌점의 최대 크기가 1보다 작기 때문이다. 다만 논문은 실제 사용한 계수 값을 적지 않았으므로 이 조건이 실제 실험에 어떻게 설정됐는지까지 단정하지 않는다.
9.3 Length constraint 해제와 미공개 RL 설정
학습은 벌점을 적용하는 단계와 끄는 단계를 번갈아 진행한다. 계속 짧게만 만들려 하면 새로운 풀이를 탐색할 기회가 줄 수 있기 때문이다. 두 단계의 학습 step 수는 각각 별도 설정값이라고 설명하지만 실제 숫자는 없다.
재현하려면 빈칸이 더 있다. 이전에 한 번도 정답을 못 낸 문제의 예산은 어떻게 만드는가. 예산이 최대 길이와 같아 분모가 0이 되는 경우는 어떻게 피하는가. 현재 응답 묶음의 크기는 얼마인가. 이런 처리는 식의 의미를 구현하는 데 필요하지만 원문은 구체적인 규칙을 주지 않는다.
따라서 이 식을 구현했다고 저자의 학습을 그대로 재현했다고 말할 수는 없다. reward 형식은 공개됐지만, 이를 실제로 작동시킨 데이터·설정·예외 처리는 일부만 공개됐다.
10. Agent RL: task success와 중간 action reward
작업 끝에 성공 또는 실패 한 번만 알려 주면 어느 tool action이 문제였는지 학습하기 어렵다. 논문은 최종 결과 reward에 더해 각 행동을 평가하는 기준을 둔다. 올바른 도구를 호출했는지, 그 행동이 완료에 필요한 정보를 늘렸는지 같은 항목이다.
예를 들어 이미 읽은 파일을 이유 없이 다시 여는 행동과, 오류 원인을 구분하기 위해 새 로그를 읽는 행동은 둘 다 “파일 읽기”지만 작업에 기여하는 정도가 다르다. 행동 중심 평가 기준은 이 차이를 학습에 반영하려 한다. 이 예는 원리를 설명한 것이며 실제 논문 rubric의 문장이나 배점은 아니다.
또 학습 데이터를 고르는 기준이 바뀐다. SFT 데이터 생성에서는 잘 푸는 작업을 점점 어렵게 만들었다. 반면 이 agent RL 단계에서는 상대적으로 짧고 쉬우며 여러 번 시도했을 때 성공 가능성이 높은 작업을 고른다. 원문은 선택 지표를 pass@8로 표시한다. 여덟 차례의 시도에서 성공할 가능성을 보는 지표이며, 뒤의 코드 평가에서 사용하는 독립 실행 8회의 평균과 구분해야 한다. 저자들은 작은 모델에서 이런 선택이 더 안정적이고 큰 개선을 줬다고 설명한다. 서로 다른 학습 단계의 선택이므로 모순은 아니다. 다만 어려운 작업만 학습한 통제군의 정확한 결과는 없다.
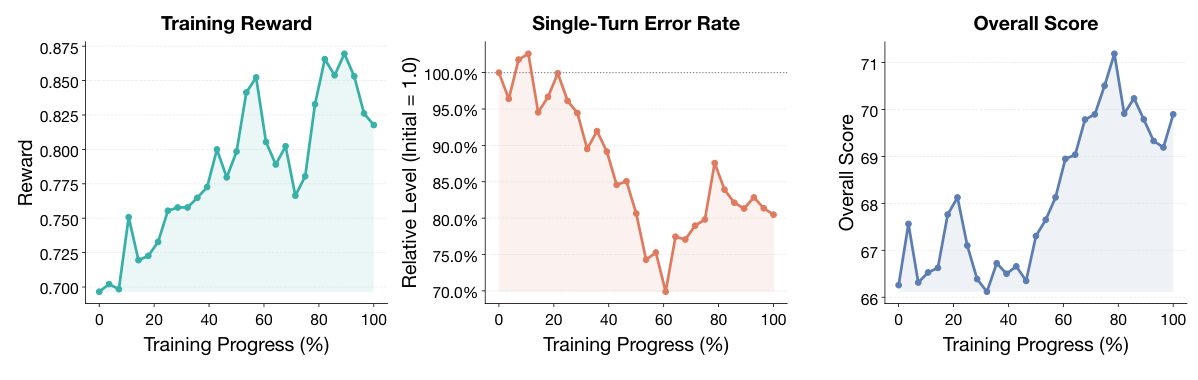
Training reward, 오류 유형, validation 점수는 서로 다른 대상을 측정한다. 곡선의 방향만 묶어 읽지 말고 각 패널의 축과 평가 조건을 확인해야 한다.
10.1 Agent RL reward curve의 변화
학습 reward는 시작의 약 0.70에서 마지막의 약 0.82로 오른다.
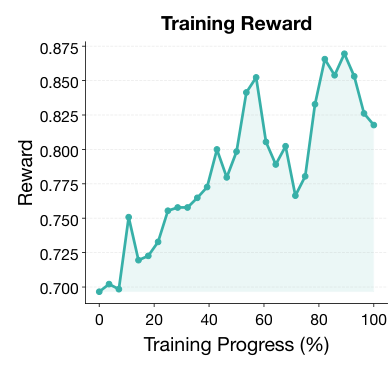
중간에 오르내리는 구간이 있다. 과제 난도와 trajectory가 다양하므로 매번 같은 문제를 푸는 단순한 곡선으로 읽으면 안 된다. 숫자는 그림에서 읽은 근삿값이며 원시 로그를 계산한 결과가 아니다.
reward가 오른다는 것은 학습 목표에 더 잘 맞아 간다는 관찰이다. 그 자체로 실제 업무 능력이 같은 비율로 늘었다는 뜻은 아니다. 그래서 오른쪽의 별도 과제 점수와 함께 봐야 한다.
10.2 Process reward 이후 상대 error rate가 낮아지는 경향
중앙 곡선은 초기 오류 수준을 100%로 놓는다.
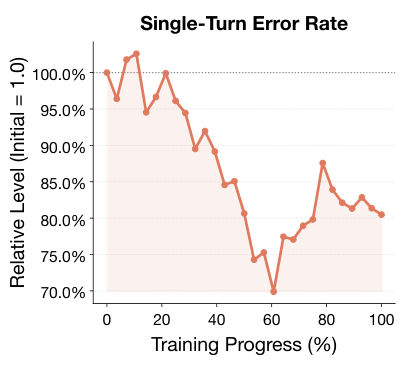
마지막은 대략 80% 수준이므로 초기 대비 약 20% 감소다. 예를 들어 초기 실제 오류율이 10%였다면 이런 상대 변화는 약 8%에 해당한다. 10%에서 음수가 될 만큼 20%포인트를 빼는 뜻이 아니다. 원문은 초기 실제 오류율을 이 그림에 주지 않는다.
중간에는 상대 수준이 약 70%까지 내려갔다가 다시 높아진다. 따라서 마지막 checkpoint가 모든 행동 지표에서 가장 좋은 것도 아니다. 이 곡선을 보고 “학습할수록 오류가 항상 줄어든다”고 쓰면 그림과 맞지 않는다.
10.3 Best checkpoint와 final checkpoint 점수
오른쪽 점수는 66에서 올라 최고 약 71에 도달한다.
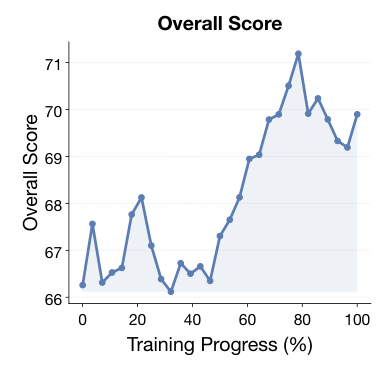
마지막은 약 70이다. 원문 본문도 71을 최고점으로 설명한다. 최고 점수를 최종 모델의 점수처럼 옮겨 적지 않는 것이 중요하다.
이 결과는 행동 reward를 포함한 학습 과정에서 오류가 줄고 과제 점수가 좋아졌다는 근거다. 하지만 outcome reward만 사용한 모델을 같은 조건으로 비교한 곡선은 없다. 쉬운 작업 선택과 행동 reward를 동시에 사용했으므로, 개선 중 얼마가 각 요소 때문인지는 분리할 수 없다.
11. RL 전후 benchmark: accuracy와 output token 수
앞의 표 2는 RLHF 단계만 비교했다. 그림 7은 이후의 reasoning·agent 학습까지 포함한 전체 RL 과정 전후를 비교한다. 두 자료의 수치가 비슷해도 같은 checkpoint라고 가정하면 안 된다.
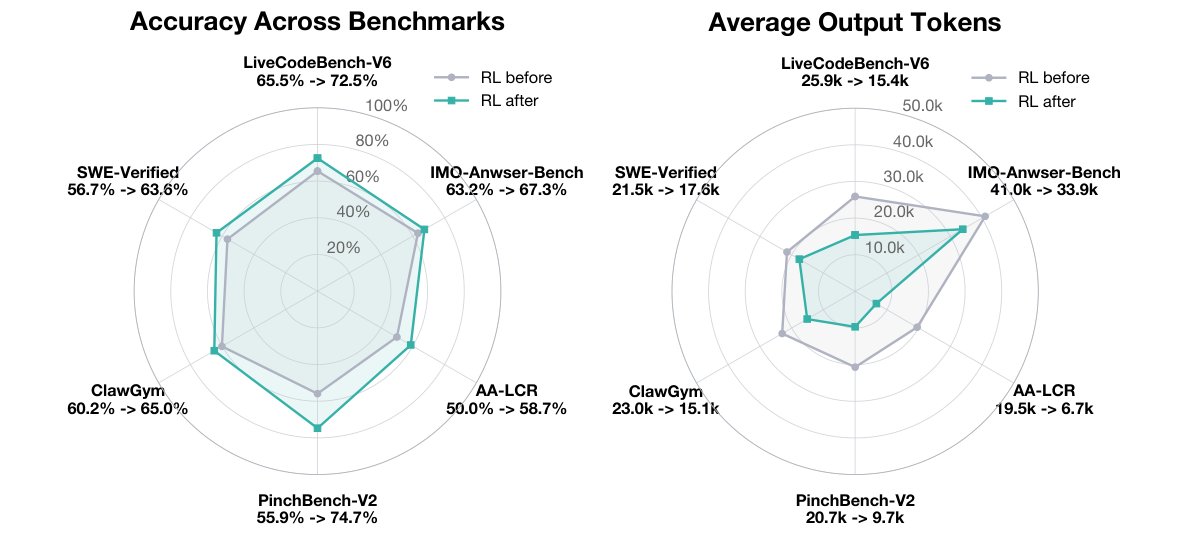
이 그림의 주요 결과는 여섯 benchmark에서 accuracy가 높아지면서 평균 output token은 줄어드는 방향이 함께 나타난다는 것이다. PinchBench는 55.9%→74.7%와 20.7K→9.7K, LiveCodeBench는 65.5%→72.5%와 25.9K→15.4K다. 아래 확대도는 reasoning·agent task별로 개선 폭을 나누어 보여준다. Token 감소를 실제 latency 측정으로 바꾸어 해석하지는 않는다.
정답률과 출력 길이는 같은 방향으로 좋아져야 하는 지표가 아니다. 아래 두 확대도에서 정확도 변화와 token 사용량을 나눠 확인한다.
11.1 6개 benchmark의 accuracy 변화
LiveCodeBench는 65.5%에서 72.5%, IMO-Answer-Bench는 63.2%에서 67.3%로 오른다.
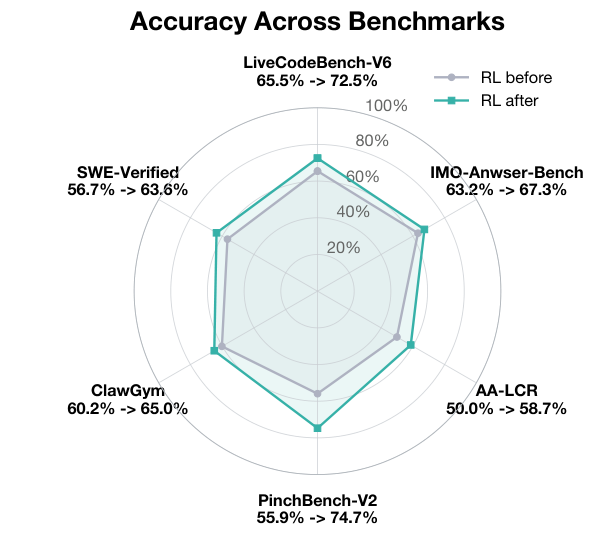
코딩과 수학 reasoning에서 개선이 나타난다. AA-LCR은 50.0%에서 58.7%로 올라 긴 문맥을 다루는 능력도 함께 좋아진다.
agent 쪽에서는 PinchBench가 55.9%에서 74.7%로 크게 상승한다. ClawGym은 60.2%에서 65.0%, SWE-bench Verified는 56.7%에서 63.6%다. 변화 폭은 과제마다 다르다. 모든 개선을 하나의 평균으로 합치면 어떤 능력이 많이 바뀌었는지 사라진다.
원문 그림의 일부 글자와 눈금은 가까이 겹쳐 있다. 임의로 수치를 다시 그려 바꾸지 않고 원본과 확대본을 함께 제공했다. 숫자는 인접한 본문에서도 읽을 수 있게 풀어 적었다.
11.2 Output token 감소와 latency 측정의 차이
LiveCodeBench의 평균 출력은 25.9K에서 15.4K, IMO는 41.0K에서 33.9K로 줄었다.
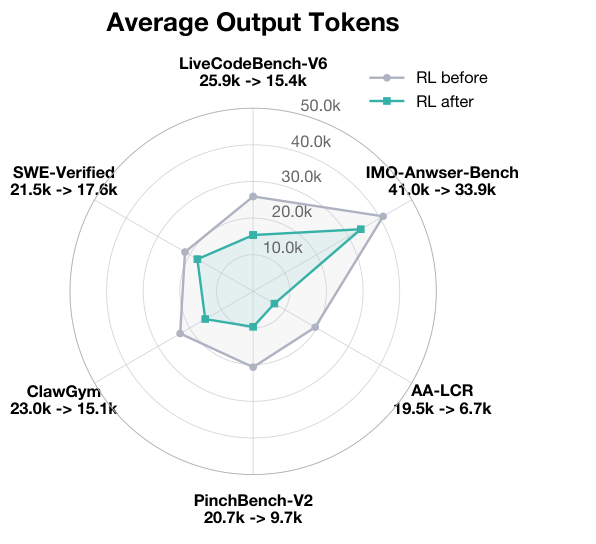
AA-LCR은 19.5K에서 6.7K로 감소한다. agent 쪽에서는 PinchBench 20.7K에서 9.7K, ClawGym 23.0K에서 15.1K, SWE-bench Verified 21.5K에서 17.6K다.
정확도가 높아지면서 출력도 줄었다는 결합 결과는 유용하다. 그러나 모델이 같은 초당 token 수로 작동하는지, 도구 응답을 얼마나 기다렸는지, GPU 메모리가 얼마나 필요한지는 이 그림으로 알 수 없다. 특히 반복 구조와 외부 도구가 있는 작업에서는 token 감소율을 그대로 latency 감소율로 바꿀 수 없다.
표 2의 SFT PinchBench 평균 20,515token과 그림 7의 시작값 20.7K도 완전히 같은 값은 아니다. 원문은 이 차이의 sample 구성이나 집계 이유를 설명하지 않는다. 이 글은 각 자료의 값을 유지하고 두 실험을 섞어 추가 계산하지 않는다.
또 이 비교는 길이 벌점만 켠 실험이 아니다. RLHF, 길이 제어, agent reward와 데이터 선택이 함께 들어간 최종 결과다. 여섯 과제에서의 개선은 전체 학습 방식의 효과를 보여 주지만 개별 기법의 독립적인 기여량을 증명하지는 않는다.
12. Nanbeige4.2 benchmark: agent·coding·reasoning·instruction following
표 3은 일반 agent, 코드 agent, reasoning, 정렬 능력을 나눈다. 여기서 정렬은 긴 문맥 reasoning과 복잡한 지시 준수, 채용 업무 요구에 맞는 응답 같은 평가 묶음이다. 모든 종류의 안전성이나 사회적 적절함을 한 번에 검증한 점수는 아니다.
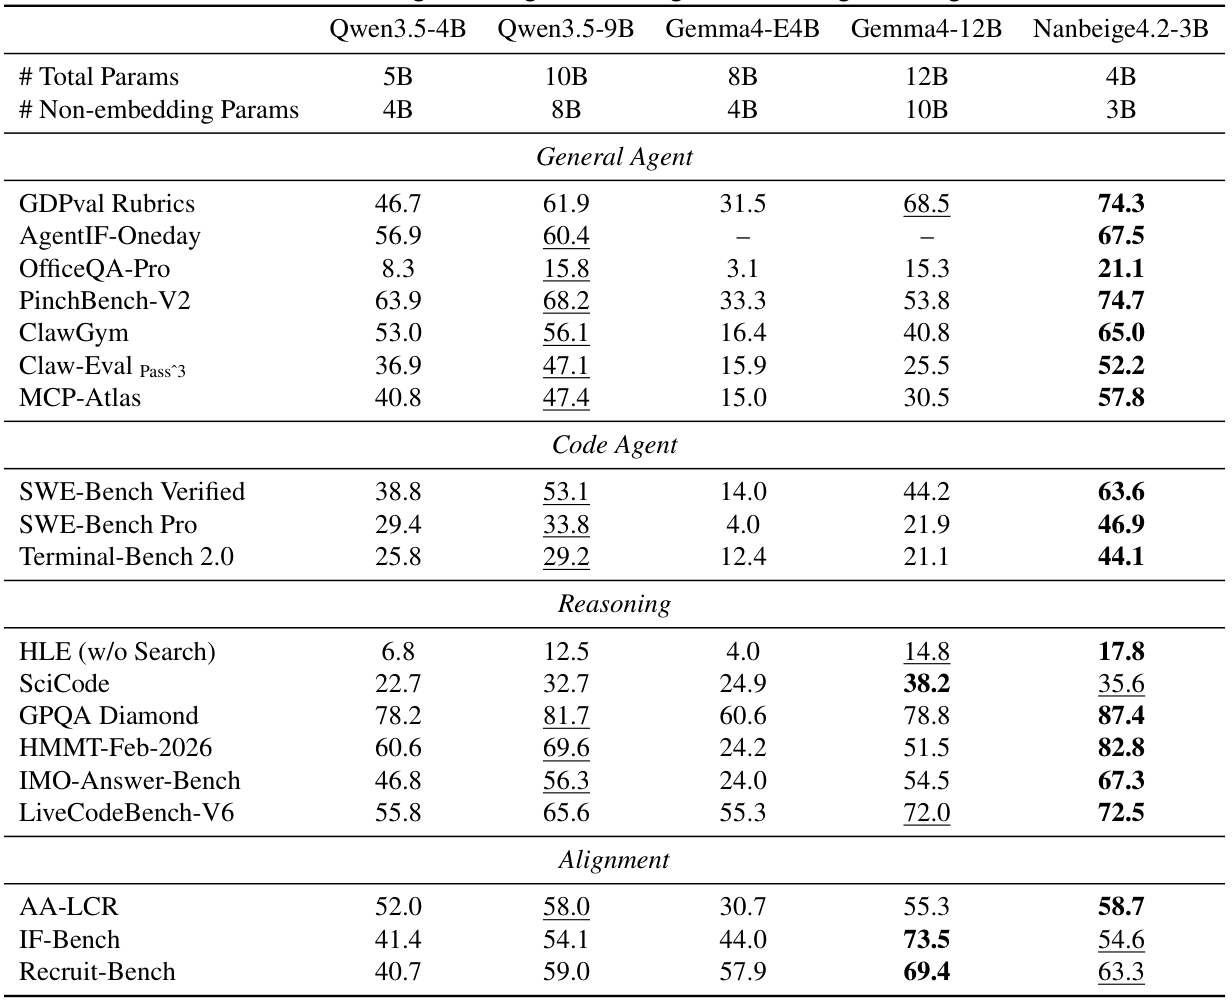
비교 모델은 Qwen3.5-4B·9B, Gemma4-E4B·12B다. 표에 따르면 전체 parameter는 각각 5B, 10B, 8B, 12B이고 Nanbeige는 4B다. 이름의 숫자만 보고 동일한 규모의 모델이라고 묶지 않는다. 실제 데이터 예산과 반복 계산량까지 같게 맞춘 실험도 아니다.
12.1 General agent benchmark의 task별 성능
문서와 업무 결과를 평가하는 GDPval Rubrics에서 Nanbeige는 74.3, Qwen3.5-9B는 61.9, Gemma4-12B는 68.5다.
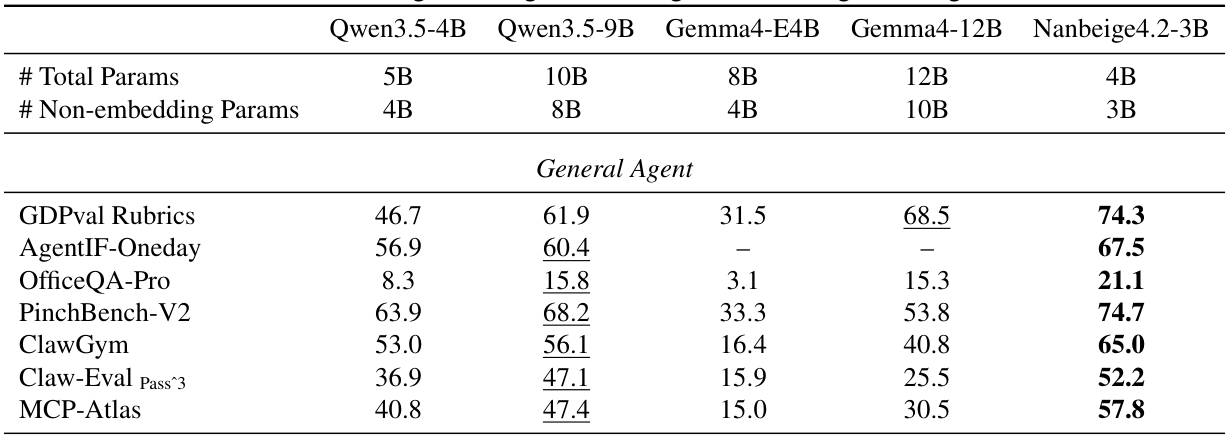
일상 업무의 지시 준수를 다루는 AgentIF-Oneday는 Nanbeige 67.5, Qwen 60.4다. Gemma 두 모델의 이 행은 값이 없으므로 0점으로 보거나 직접 비교에서 이겼다고 세면 안 된다.
문서 근거 질의응답인 OfficeQA-Pro에서는 Nanbeige 21.1, Qwen 15.8, Gemma12B 15.3이다. 비교 모델보다 높지만 절대 점수는 낮다. 실제로 어려운 문서 질문을 안정적으로 해결하는 수준이라고 확대해서 말할 근거는 부족하다. 모든 원본 PDF를 주고 관련 문서를 알려 주지 않는 까다로운 설정이 사용됐다는 점은 14장에서 살펴본다.
일상 agent 작업을 다루는 PinchBench는 74.7 대 68.2, ClawGym은 65.0 대 56.1로 Qwen9B보다 높다. Claw-Eval은 52.2 대 47.1, 실제 MCP 도구 사용을 다루는 MCP-Atlas는 57.8 대 47.4다. 보고된 일반 agent 항목에서 넓은 개선이 있다는 관찰은 가능하다.
그러나 이 일곱 행은 같은 시험의 하위 점수가 아니다. 최종 파일의 rubric 점수와 도구 과제 성공 지표, Claw-Eval의 Pass^3 표기가 섞여 있다. 논문은 Pass^3의 전체 산식을 본문에 풀어 주지 않는다. 이를 다른 행의 단일 시도 정확도와 같은 값으로 취급해 종합 순위를 만들지 않는다.
12.2 Coding agent benchmark와 긴 실행 budget
SWE-bench Verified는 Nanbeige 63.6, Qwen9B 53.1, Gemma12B 44.2다.
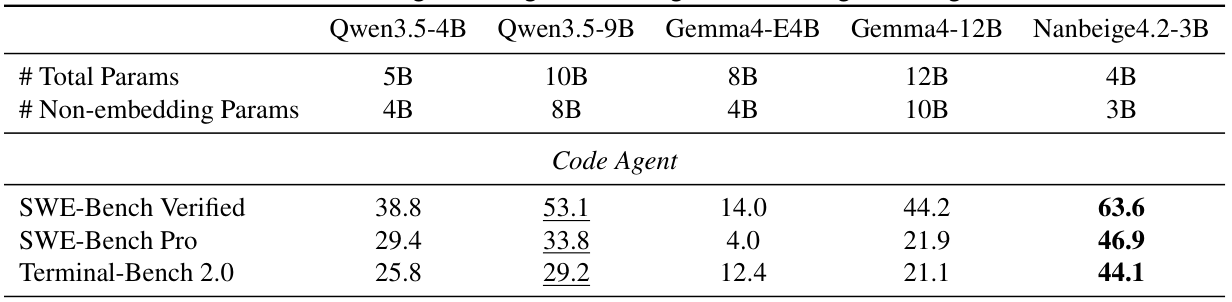
SWE-bench Pro는 각각 46.9, 33.8, 21.9다. Terminal-Bench 2.0은 44.1, 29.2, 21.1이다. 함수 한 개를 생성하는 문제를 넘어 저장소를 수정하고 터미널에서 작업하는 능력에서도 우위가 관찰된다.
세 평가의 실행 틀은 서로 다르다. Verified는 OpenHands, Pro는 SWE-agent, Terminal은 Harbor/Terminus-2다. 문맥은 256K, 최대 출력은 32K, 상호작용은 최대 250차례이고, 과제별 제한 시간은 4시간 또는 10시간이다. 이 조건을 빼고 “짧은 한 번의 요청에서 63.6% 성공”이라고 설명하면 실험을 바꾸는 셈이다.
또 결과는 독립 실행 8회의 평균이다. 8번 중 한 번이라도 성공한 최고 결과를 고른 수치라는 뜻이 아니다. 논문은 이 반복을 명시하지만 confidence interval과 상세 변동을 표에 제공하지 않는다.
12.3 Reasoning benchmark: SciCode와 작은 점수 차이
검색을 쓰지 않는 HLE에서 Nanbeige는 17.8로 Gemma12B의 14.8, Qwen9B의 12.5보다 높다.
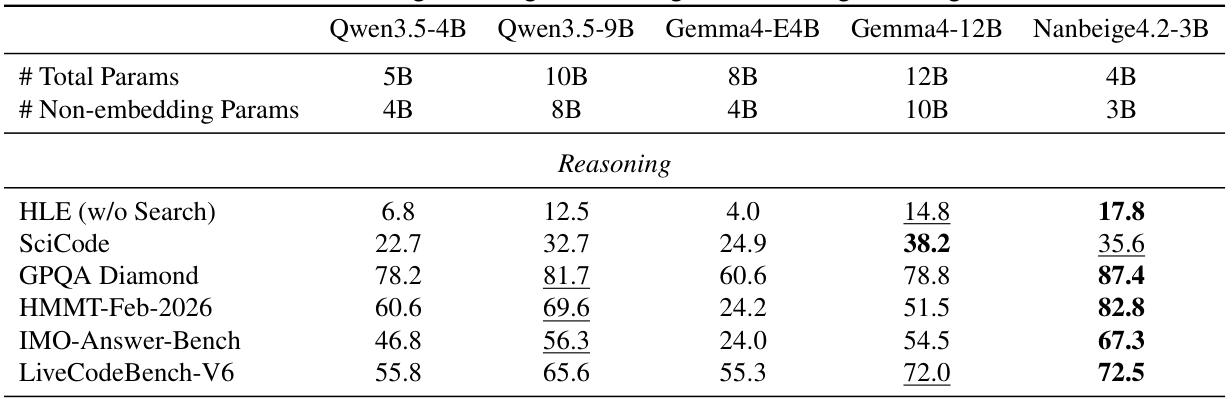
과학 분야의 어려운 질의응답인 GPQA Diamond는 87.4로 Qwen의 81.7보다 높다. HMMT-Feb-2026과 IMO-Answer-Bench도 표 기준으로 82.8과 67.3이며, Qwen9B의 69.6과 56.3을 앞선다. HMMT는 앞서 설명한 그림 1의 82.1과 불일치가 남아 있다.
SciCode는 다르다. Nanbeige 35.6은 Qwen9B 32.7보다 높지만 Gemma12B 38.2보다 낮다. 과학 지식을 코드로 옮기는 문제에서 가장 강한 모델이라고 말할 수 없다. 수학 점수가 높다고 모든 과학 소프트웨어 작업까지 같은 순위가 되는 것은 아니다.
LiveCodeBench는 Nanbeige 72.5, Gemma12B 72.0으로 차이가 0.5점이다. 표의 순위는 Nanbeige가 높지만, 반복 변동과 confidence interval이 없는 상태에서 큰 격차나 안정적인 우월성을 주장하기 어렵다. 이 구간은 “최고 점수”라는 말보다 실제 차이의 크기가 더 중요하다.
12.4 Instruction following benchmark의 약한 결과
AA-LCR에서는 Nanbeige 58.7이 Qwen9B 58.0보다 조금 높다.
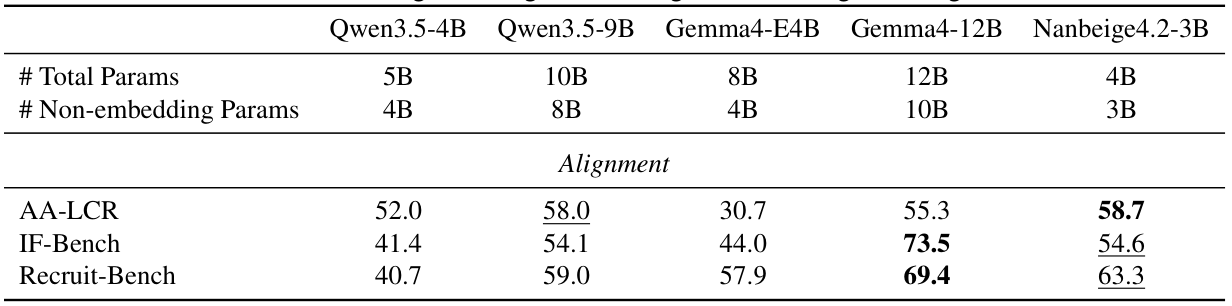
반면 IF-Bench는 Nanbeige 54.6, Gemma12B 73.5다. 채용 업무의 요구에 맞추는 내부 평가 Recruit-Bench도 Nanbeige 63.3, Gemma12B 69.4다.
따라서 도구를 능숙하게 연결한다는 결과를 모든 문장 제약과 업무 규칙을 더 잘 지킨다는 주장으로 넓히면 안 된다. “반드시 세 항목으로 답하라” 같은 출력 조건과 “여러 파일에서 필요한 정보를 찾아라”는 과제는 일부 능력을 공유해도 동일하지 않다. 이 문장 예시는 차이를 설명한 것이며 IF-Bench의 실제 공개 문제를 인용한 것은 아니다.
Recruit-Bench는 저자들의 내부 평가다. 기업의 채용과 지원자의 구직 상황을 포함한다고 설명하지만 세부 데이터와 공개 재현 경로가 충분히 제시되지 않는다. 특정 내부 평가의 결과를 채용 판단 전반의 신뢰성으로 확대하지 않는다.
13. OpenClaw benchmark: 같은 agent framework에서 비교
표 3에는 과제별 실행 틀이 섞여 있었다. 표 4는 Qwen4B, Qwen9B, Nanbeige를 같은 OpenClaw 실행 틀, 같은 도구 집합, 같은 평가 방식으로 비교한다. 모델의 능력이 하나의 통합 비서 환경으로 옮겨 가는지를 묻는 실험이다.
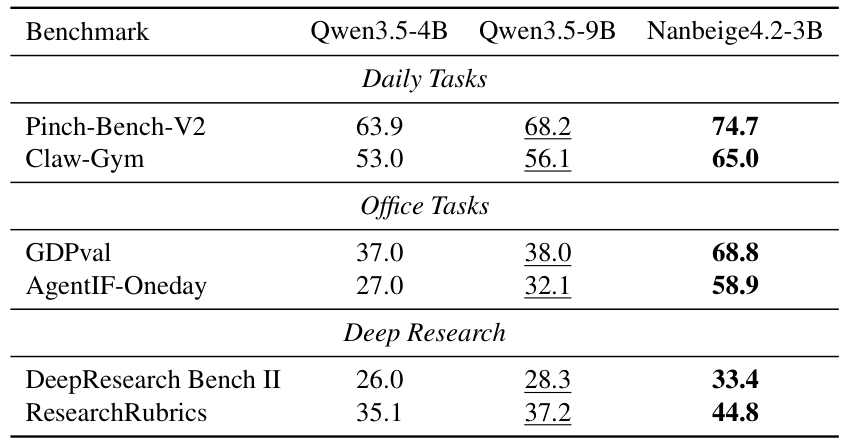
일상 작업의 PinchBench는 Qwen4B 63.9, Qwen9B 68.2, Nanbeige 74.7이다. ClawGym은 53.0, 56.1, 65.0이다. 이 두 행은 표 3에도 같은 수치로 등장하므로 별도의 독립 재현 두 번으로 세지 않는다.
사무 작업의 GDPval은 37.0, 38.0, 68.8이고 AgentIF-Oneday는 27.0, 32.1, 58.9다. 이 환경에서 Nanbeige와 두 Qwen 모델의 차이는 비교적 크다. 다만 표 3의 Nanbeige GDPval 74.3, AgentIF 67.5와는 다른 점수다. 표 3의 내부 실행 틀과 표 4의 OpenClaw가 다르므로 서로 충돌하는 동일 실험 값으로 취급하지 않는다.
심층 조사 작업에서는 DeepResearch Bench II가 26.0, 28.3, 33.4, ResearchRubrics가 35.1, 37.2, 44.8이다. 여러 외부 자료를 찾아 근거를 종합하는 조건에서도 Nanbeige가 높은 값을 보인다. 이 표에는 Gemma 비교가 없으므로 Gemma에 대한 OpenClaw 우열은 알 수 없다.
저자들은 이 결과를 로컬 개인 비서의 가능성과 연결한다. 여기서 로컬은 모델을 직접 실행할 수 있다는 방향이다. 실제 평가는 외부 검색과 별도 판정 모델을 사용한다. 인터넷 없이 노트북 한 대에서 같은 점수를 내거나 같은 속도로 작동한다는 실험은 아니다. 사용성을 판단하려면 모델 크기뿐 아니라 아래의 전체 실행 조건을 봐야 한다.
14. Appendix 평가 설정: generation·tool·turn·time budget
14.1 Temperature·top-p·max token 기본값과 예외
별도 설명이 없으면 temperature 0.6, top-p 0.95, top-k 20, 문맥 256K를 사용한다.
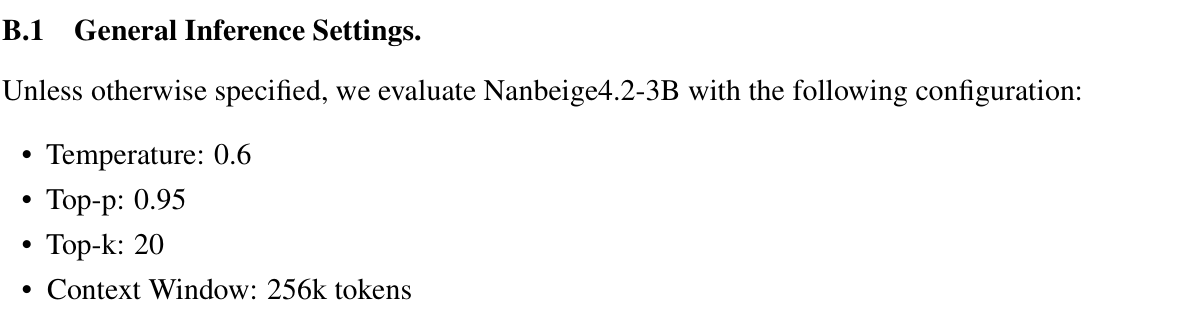
temperature는 다음 token 선택의 무작위성, top-p와 top-k는 후보를 제한하는 방식과 관련된다. 이 글의 핵심은 각 값을 튜닝하는 일반론보다 논문 점수가 나온 설정을 보존하는 것이다.
문맥 길이와 새 출력의 최대 길이는 다르다. 문맥에는 요청과 이전 대화, 도구 결과까지 들어간다. 256K 문맥을 지원한다고 매 호출마다 256K의 새 답을 생성했다는 뜻은 아니다. 코드 agent 평가에서는 별도로 32K 출력 제한을 둔다.
14.2 Coding 평가의 time·turn budget과 평균
Verified는 OpenHands에서 과제당 4시간, Pro는 SWE-agent에서 10시간이다.
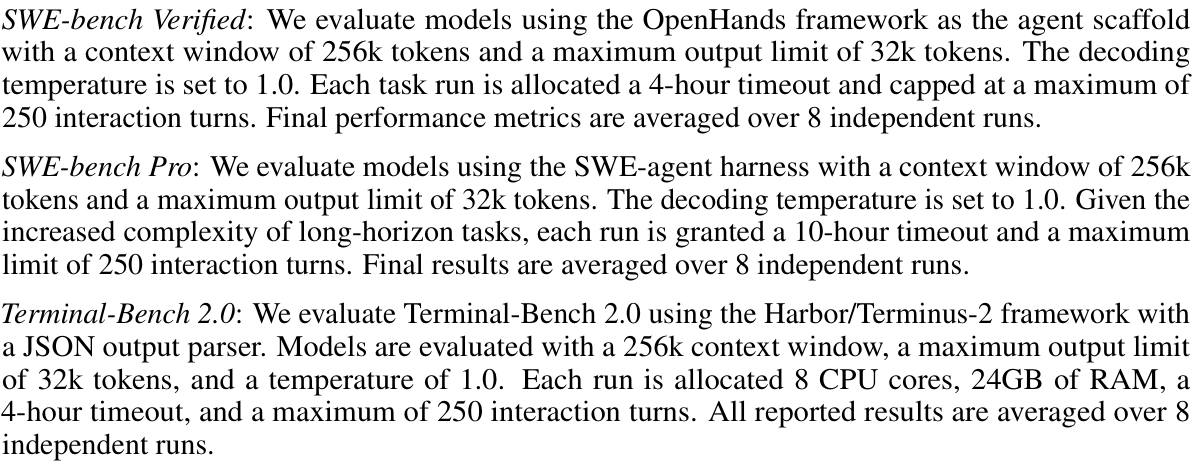
Terminal-Bench는 Harbor/Terminus-2와 JSON 출력 파서를 사용하며 4시간이다. 세 평가 모두 256K 문맥, 32K 최대 출력, temperature 1.0, 최대 250차례 상호작용, 독립 실행 8회의 평균이라는 공통 조건이 있다.
Terminal 설정의 CPU 8코어와 RAM 24GB는 작업 실행 환경에 할당된 자원이다. 모델이 쓰는 GPU 메모리가 24GB라는 정보가 아니다. weight와 KV cache의 메모리를 계산하려면 별도 정보가 필요하다.
재현에서 이 차이는 실질적이다. 같은 모델을 30차례, 10분만 실행하거나 JSON 대신 다른 도구 호출 형식을 사용하면 다른 실험이 된다. 반대로 긴 예산이 있다고 모든 요청이 끝까지 그 시간을 썼다는 뜻도 아니다. 평균 실제 실행 시간은 별도로 보고하지 않았다.
14.3 Office benchmark의 문서와 judge 조건
GDPval Rubrics와 AgentIF-Oneday는 검색 도구와 격리된 작업 환경을 갖춘 내부 실행 틀에서 평가한다.
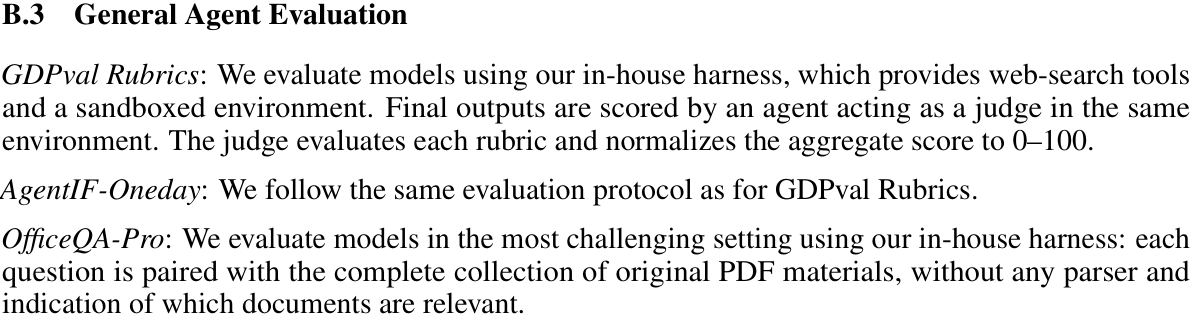
판정 agent가 각 기준을 확인하고 결과를 0–100으로 normalize한다. 단순히 결과 파일이 존재하는지만 세는 검사가 아니다. 다만 여기의 전체 판정 prompt와 모델 버전은 해당 문단에 적혀 있지 않다.
OfficeQA-Pro는 질문마다 원본 PDF 전체를 제공하고, 미리 파싱한 자료나 관련 문서의 위치를 알려 주지 않는 가장 어려운 설정이라고 설명한다. 필요한 문서를 찾는 부담도 평가에 포함된다. 이것을 모델 자체에 원래 PDF 시각 인식 기능이 있다는 근거로 바꿀 수는 없다. 문서 접근을 어떤 도구가 맡는지와 모델의 입력 형식은 별도로 확인해야 한다.
14.4 Conversation에는 reasoning을 유지하는 평가 절차
Claw-Eval은 전체 과제가 아니라 일반 과제 157개만 사용한다.
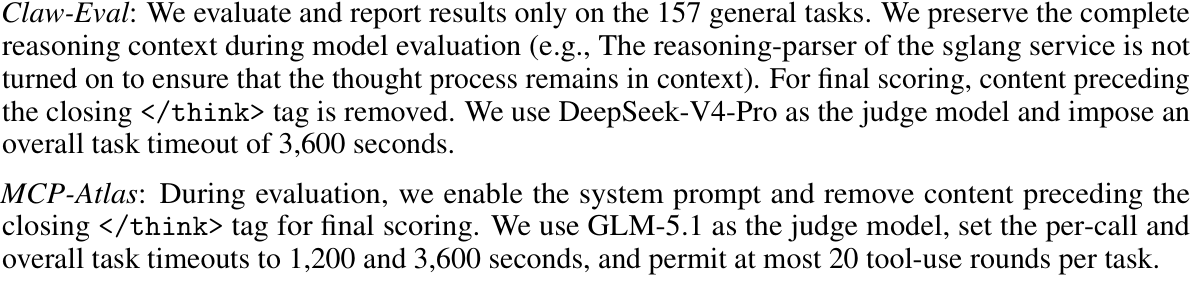
모델이 다음 행동을 만들 때는 이전 reasoning 내용을 문맥에 보존한다. 예로 SGLang의 reasoning parser를 켜지 않는다고 적는다. 그러나 최종 채점에서는 </think> 앞의 내용을 제거하고 최종 응답을 평가한다. 작업 중 문맥 보존과 최종 채점용 reasoning 제거는 서로 다른 단계다.
Claw-Eval의 판정 모델은 DeepSeek-V4-Pro, 전체 제한 시간은 3,600초다. MCP-Atlas는 시스템 prompt를 켜고 최종 채점 전에 같은 방식으로 reasoning을 제거한다. 판정 모델은 GLM-5.1이며 호출당 1,200초, 과제 전체 3,600초, 최대 20차례의 도구 사용을 허용한다.
파서가 reasoning을 별도 필드로 분리했는데 다음 요청에서 그 필드를 다시 넣지 않으면 논문의 조건과 달라진다. 반대로 최종 답만 채점해야 하는데 reasoning까지 판정기에 넘겨도 달라진다. 공개 모델의 채팅 템플릿을 읽어야 하는 이유가 여기에 있다.
14.5 OpenClaw search·judge의 외부 서비스 조건
OpenClaw에서도 전체 reasoning을 대화에 다시 넣도록 모델을 reasoning-content replay 허용 목록에 추가한다.
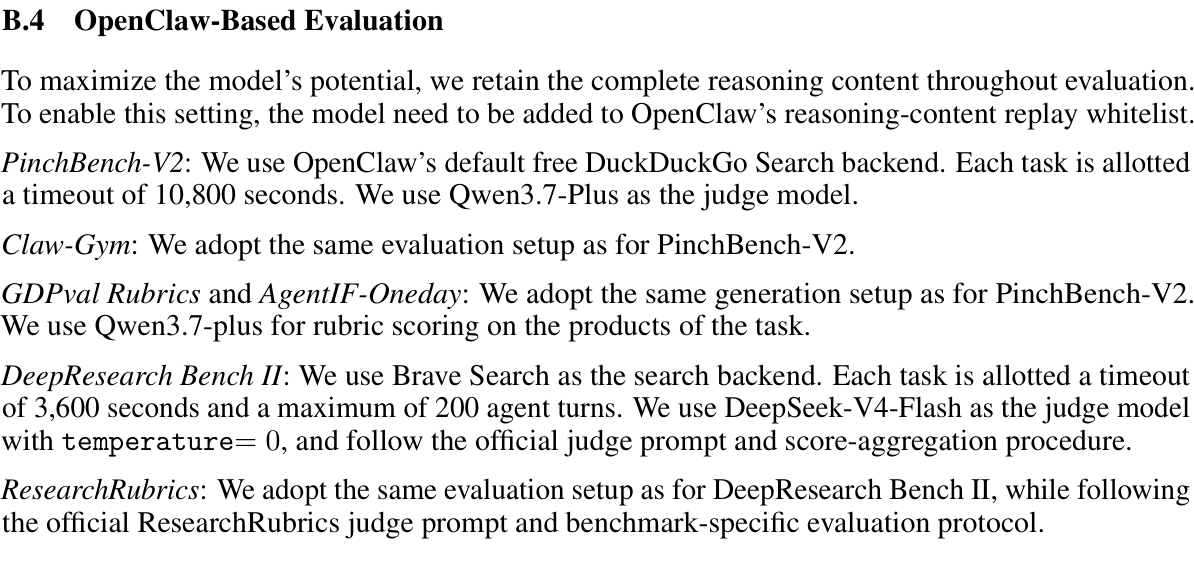
PinchBench와 ClawGym은 기본 DuckDuckGo 검색, 과제당 10,800초를 사용하고 Qwen3.7-Plus가 판정한다. GDPval과 AgentIF도 같은 생성 조건이며, 결과물의 rubric 채점에 같은 판정 모델을 쓴다.
심층 조사에서는 Brave Search로 바뀐다. DeepResearch Bench II와 ResearchRubrics는 과제당 3,600초, 최대 200차례, temperature 0인 DeepSeek-V4-Flash 판정기를 사용한다. 각 benchmark의 공식 판정 prompt와 집계 절차를 따른다고 설명하지만 원문 부록에 그 prompt 전문을 붙이지는 않았다.
검색 결과는 시간이 지나면 달라질 수 있고 외부 판정 모델도 별도로 고정해야 한다. 논문 PDF와 모델 파일만 보관해서 완전히 동일한 실행을 재현하기 어려운 부분이다. 로컬 모델이라는 표현에 가려 이런 외부 의존성을 빠뜨리지 않아야 한다.
15. Nanbeige 공개 코드: model loop·KV cache·chat template
15.1 Paper version과 Hugging Face model revision
코드 관찰은 공식 Hugging Face 저장소의 7월 27일 커밋을 기준으로 했다. 최신 파일을 논문 발표 당시 구현처럼 다루지 않기 위해서다. 설정, 모델 구현, 채팅 템플릿, 모델 설명과 weight 인덱스 등 작은 파일 8개를 읽었다. weight는 내려받지 않았고 모델 코드도 실행하지 않았다.
모델 설정은 22개 층, 반복 2회, hidden dimension 3,072, 중간 feed-forward 차원 10,752, vocabulary 크기 166,144를 지정한다. 최대 위치는 262,144이고 weight 자료형은 BF16이다. attention query head는 48개, key/value head는 8개, head 차원은 별도로 128로 지정한다. hidden dimension을 head 수로 나눈 값을 무조건 head 차원으로 쓰면 이 구현과 맞지 않는다.
15.2 Model loop와 KV cache 위치
모델 구현의 NanbeigeModel은 22개 층을 한 번 생성한다. forward는 같은 층 객체를 두 번 순회한다. 기본 경로에서는 각 통과 후 normalize하고, 첫 번째 통과의 결과가 두 번째 통과의 입력이 된다. 이 관찰이 앞의 “weight 공유” 설명을 뒷받침한다.
cache는 층 번호에 반복 번호 × 층 수를 더한 위치에 저장한다. 예를 들어 첫 통과의 0번 층은 cache 0, 다음 통과의 같은 층은 cache 22를 사용한다. 따라서 weight를 공유한다고 과거 token의 모든 중간 정보까지 같은 저장 공간을 쓰는 것은 아니다.
코드에는 반복 간 KV 공유, 다른 층 순서, 깊이 간 attention, 추가 연결 구조, n-gram 표현 같은 실험용 선택지도 있다. 그러나 기본값과 공개 checkpoint 설정을 따라가면 여기서 설명한 모델에는 해당 선택지가 활성화되어 있지 않다. 논문 결론도 일부를 향후 방향과 예비 구현으로 설명한다. 파일에 코드가 있다는 사실만으로 표 3의 성능을 그 기능의 효과라고 해석하지 않는다.
15.3 Weight memory와 long-context KV cache
weight 인덱스의 전체 크기 메타데이터는 8,339,601,408바이트, 약 7.77GiB다. 이것은 인덱스에 기록된 weight 규모이지 실행 중 GPU 메모리를 측정한 값이 아니다. 임시 계산 공간, KV cache, 도구와 응용 프로그램의 메모리는 별도다.
긴 문맥에서 왜 차이가 커질 수 있는지 설명용 계산을 해 보자. batch 1개, 262,144token 전체를 유지하고, 44개 논리적 cache 층에 key와 value를 BF16으로 보관한다고 가정한다. 설정의 KV head 8개와 head 차원 128을 곱하면 다음과 같다.
왼쪽의 두 개의 2는 각각 key/value 두 종류와 BF16의 원소당 2바이트다. 이 값은 전체 길이를 그대로 보관하는 가정의 KV 전용 산술이다. 실제 할당량을 관찰한 것도, 최소 필요 메모리를 단정한 것도 아니다. 짧은 입력, cache quantization, 일부 저장 이동 등 구현 선택에 따라 달라진다. 작은 weight와 작은 전체 실행 비용을 구분해야 한다는 점을 보여 주는 계산이다.
15.4 Chat template의 tool·reasoning 전달 형식
채팅 템플릿을 보면 기본 도구 형식은 XML 계열이고 JSON 선택지도 있다. 도구 호출에는 tool_call, 함수 이름, 인자 구분이 들어가며 반환값은 tool_response로 묶인다. 실제 함수를 실행하는 것은 바깥 실행 틀이다. 모델이 이런 문자열을 만들었다고 함수가 실행된 것은 아니다.
reasoning은 메시지의 reasoning_content 필드에서 가져오거나 응답의 </think> 구분으로 분리한다. preserve_thinking을 켜면 이전 reasoning을 유지한다. 끄면 마지막 사용자 요청보다 앞선 모델 응답의 reasoning을 제외하는 경로가 있다. 앞의 Claw-Eval·OpenClaw 조건과 연결되는 구체적인 구현 차이다.
enable_thinking을 끄는 경로는 빈 reasoning 구간을 넣고, 켜는 기본 경로는 reasoning 시작을 열어 준다. 이는 입력 템플릿 구성이지 모델이 항상 정확히 그 모드로 응답한다는 보장은 아니다. 도구 형식 파서와 reasoning 재전달 방식을 함께 맞춰야 한다.
모델 설명의 Transformers 예시는 새 출력 한도를 131,072로 두지만, 논문의 코드 agent 평가는 32K다. 예제 명령을 그대로 사용하는 것과 평가 재현은 다르다. 또한 설명에 나오는 SGLang nbg42, vLLM nanbeige42는 프로젝트가 지정한 분기다. 기본 설치의 최신 버전으로 같은 경로가 검증됐다고 주장하지 않는다. 이 리뷰에서는 어느 inference backend도 실행해 시험하지 않았다.
15.5 공개 구현에서 빠진 학습·평가 조건
공개 모델 파일은 반복 순서와 입력·출력 형식을 확인하는 데 유용하다. 하지만 28조 token의 학습 데이터, 전체 합성 pipeline, reward model, 행동 rubric 전문과 weight, learning rate·optimizer·KL 제약·클리핑, 단계별 step 수와 난수 설정을 모두 제공하지는 않는다. 이 파일 8개를 확인했다고 전체 학습 시스템을 감사한 것은 아니다.
특정 평가를 다시 한다면 먼저 그 평가의 실행 틀과 버전, 문맥·출력·차례·시간 한도, 반복 평균 방식을 고정해야 한다. 다음으로 도구 schema, reasoning 보존과 최종 답 분리, 검색 서비스와 판정 모델을 맞춘다. 원문에 없는 설정은 새 선택으로 기록해야 한다. 논문과 같은 형식의 실험을 구성하는 것과 동일한 점수를 확인하는 것을 단계별로 구분하는 편이 정확하다.
HMMT의 불일치도 재현 문제에 속한다. 고정한 평가 기록은 82.1이고, 표 3은 82.8이다. 원시 응답과 집계 설정이 없어 어느 쪽이 어떤 실행을 뜻하는지 확정할 수 없다. 독자는 이 차이를 남겨 둔 채 결과를 해석해야 한다.
16. Ablation과 한계: architecture·data·RL 효과의 분리
16.1 Architecture·SFT·RL의 비교와 빠진 ablation
이 논문에는 단계 전후의 근거가 있다. 표 2는 동일한 Think 평가 설정으로 RLHF checkpoint를 비교하고, 그림 7은 전체 RL 전후의 정확도와 출력 길이를 비교한다. 표 4는 세 모델의 OpenClaw·도구·평가 방식을 맞춘다. 각각 응답 안정화, 전체 후속 학습, 실행 틀을 옮겼을 때의 성능이라는 질문에 답한다.
그러나 반복 구조만 켜고 끈 동등한 pre-training 비교, 길이 reward만 제거한 최종 모델, action reward 없이 같은 쉬운 과제만 쓴 모델, 여러 실행 틀의 데이터 대신 하나만 쓴 모델의 정량 결과는 없다. 저자들은 일부 선택을 서술로 설명하지만 모든 비교표를 제공하지 않는다. 따라서 좋은 최종 결과를 구성 요소별 기여 점수로 나눌 수 없다.
더 명확하게 확인하려면 같은 데이터·계산 예산에서 반복 구조를 바꾸거나, 같은 시작 checkpoint와 과제로 reward 항목 하나만 바꾸는 실험이 필요하다. 이것은 이 리뷰의 후속 실험 제안이며 원문에서 이미 수행된 정량 결과라고 제시하는 것이 아니다.
16.2 저자의 한계와 추가 검증 사항
저자들은 층을 반복 안에서 조직하는 방법, 깊이 사이 정보 전달, token 주변의 n-gram을 외부 기억처럼 쓰는 방법을 향후 개선 방향으로 든다. 긴 문맥을 위한 선형·희소 attention, 더 다양한 agent 환경과 어려운 과제, pre-training부터 agent 능력을 넣는 방법, 큰 모델에서 작은 모델로 지식을 옮기는 학습도 계획한다. 현재 모델의 완성된 기능과 앞으로 할 연구를 구분해야 한다.
추가로 관찰할 한계는 세 가지다. 첫째, 최종 점수의 분산과 일부 표·그림 불일치가 남아 있다. 둘째, 판정 모델과 합성 환경의 기준이 실제 업무 품질과 얼마나 맞는지 별도 검증이 필요하다. 셋째, 작은 parameter 수의 이점을 실제 장비에서의 latency·메모리·총 비용으로 연결하는 측정이 부족하다.
이는 연구의 성과를 없애는 지적이 아니다. 적은 weight로 여러 agent 과제에서 경쟁력 있는 결과를 낸 관찰은 유지된다. 다만 어떤 제품 환경에서 같은 이점이 나올지 판단할 때 필요한 추가 근거를 구분하는 것이다.
17. Nanbeige4.2-3B의 활용 조건과 후속 검증
Nanbeige4.2-3B의 기여는 작은 모델의 능력을 한 가지 트릭으로 설명하지 않는 데 있다. 반복 계산으로 표현을 강화하고, 실제 실행을 통해 학습 작업을 검증하며, 실패한 행동과 복구 문맥을 구분하고, 응답 형식·reasoning 길이·tool action을 순서대로 학습한다. 작업을 끝내는 능력은 정답 지식뿐 아니라 환경과 상호작용하는 방식에서 나온다는 설계를 구체적으로 보여 준다.
이 논문을 공부할 가장 강한 이유는 코드·문서·도구를 하나의 학습 모델로 묶는 방법과 평가 조건을 함께 볼 수 있다는 점이다. 가장 신중해야 할 부분은 공개된 최종 모델과 재현 가능한 전체 학습 레시피 사이의 간격이다. 작은 모델의 실용성을 확인하려면 같은 장비와 실행 틀에서 성공률, 실제 소요 시간, 메모리, 외부 호출 비용을 함께 측정하는 비교가 다음 단계가 된다.
참고문헌은 원문 13–15쪽, 개인 저자 목록과 평가 설정은 부록 A·B, 감사 표기는 부록 C에 있다. 부록의 추가 실험표는 없지만 실행 조건은 결과 해석에 직접 영향을 주므로 본문 14장에 각각 연결했다. 인용할 때는 Nanbeige LLM Lab, Boss Zhipin, “Nanbeige4.2-3B: Unlocking Agentic Capabilities in a Compact Model,” arXiv:2607.22083v2, 2026, preprint로 버전을 명시한다.
원문과 도판은 논문 PDF v2, 구현 관찰은 고정한 공식 모델 저장소에 근거한다. 원문 도판에는 CC BY 4.0 출처를 붙였고, 확대본은 원문 일부를 잘라 머리글과 해당 영역을 다시 배치했다. 수치와 축을 새로 그려 바꾸지 않았다. 설명용 예시·산술과 코드 정적 관찰은 논문이 직접 보고한 실험과 구분했다.
18. 출처
- 원문 PDF, arXiv:2607.22083v2: method·학습 설정·전체 실험과 figure·table의 근거.
- 공식 Hugging Face 저장소의 7월 27일 커밋: 본문에서 대조한 공개 구현·설정의 고정 버전.
- 모델 설정: 본문에서 대조한 공개 구현·설정의 고정 버전.
- 모델 구현의
NanbeigeModel: 본문에서 대조한 공개 구현·설정의 고정 버전. - weight 인덱스: 본문에서 대조한 공개 구현·설정의 고정 버전.
자료 확인·수정: 2026년 9월 16일. 검토한 원문과 공개 구현의 버전은 위에 고정했다. 이번 수정에서는 전문 용어, 설명 문장, 검색 주제가 드러나는 제목과 이미지 배치를 보완했다.
관련 글
Paper Review
A Defense of the Quadratic Model — LLM 학습의 Gauss–Newton 근사와 안정성 분석
A Defense of the Quadratic Model의 Gauss–Newton 근사, Lanczos spectrum과 학습 안정성을 설명한다. batch 64 예제, 원문 figure·table, 공개 코드로 근사가 맞는 조건과 반례를 분석한다.
Paper Review
IndexTTS: An Industrial-Level Controllable and Efficient Zero-Shot Text-To-Speech System — voice cloning·병음 발음 제어 분석
IndexTTS v1의 SEQ3 입력, Conformer·Perceiver와 BigVGAN2 구조를 설명한다. 병음 교정률 94%의 분모, CER·WER·SS·MOS와 inference 속도를 원문 figure·table과 코드로 분석한다.
Paper Review
IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech — 감정·발화 길이 제어 원리 분석
IndexTTS2의 T2S·S2M, GRL 감정 분리, GPT latent와 duration control을 설명한다. WER·SS·MOS, ablation과 공개 inference 코드의 제한을 원문 figure·table로 분석한다.